{
"cells": [
{
"cell_type": "markdown",
"metadata": {},
"source": "# 14 SmolVLA 端到端:训练、评估、视频与诊断\n\n 这个 Notebook 把 SmolVLA 的完整学习路径放在一个文件里:先看已经复现成功的权重和视频,再检查数据,最后给出 smoke、长训、严格评估和日志追踪命令。\n\n 运行方式建议:第一次教学演示只开 `RUN_SMOKE=1 RUN_EVAL=1`;完整复现实验再开 `RUN_LONG_TRAIN=1`。长训输出会真实写回 Notebook 单元格,而不是粘贴静态日志。\n"
},
{
"cell_type": "code",
"execution_count": 1,
"metadata": {},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": "TOPIC_ROOT = $TOPIC_ROOT\nPROJECT_ROOT = $PROJECT_ROOT\nDATA_ROOT = $DATA_ROOT\nMODEL_ROOT = $MODEL_ROOT\nOUTPUT_ROOT = $OUTPUT_ROOT\n"
}
],
"source": [
"from pathlib import Path\n",
"import json\n",
"import os\n",
"import shlex\n",
"import shutil\n",
"import subprocess\n",
"import sys\n",
"\n",
"try:\n",
" from IPython.display import HTML, Markdown, display\n",
"except Exception:\n",
" class Markdown(str):\n",
" pass\n",
"\n",
" class HTML(str):\n",
" pass\n",
"\n",
" def display(obj):\n",
" print(obj)\n",
"\n",
"\n",
"def find_topic_root():\n",
" cwd = Path.cwd().resolve()\n",
" for candidate in [cwd, *cwd.parents]:\n",
" if (candidate / \"assets\" / \"metrics_snapshot.json\").exists():\n",
" return candidate\n",
" raise RuntimeError(\"请从 AMD ROCm 专题目录或 notebooks 子目录启动 Jupyter。\")\n",
"\n",
"\n",
"TOPIC_ROOT = find_topic_root()\n",
"ASSET_DIR = TOPIC_ROOT / \"assets\"\n",
"PROJECT_ROOT = Path(os.environ.get(\"PROJECT_ROOT\", \"/path/to/04mujoco复现ACT、Pi0、SmolVLA\"))\n",
"DATA_ROOT = Path(os.environ.get(\"DATA_ROOT\", \"/path/to/datasets/every_embodied\"))\n",
"MODEL_ROOT = Path(os.environ.get(\"MODEL_ROOT\", \"/path/to/model/checkpoints\"))\n",
"OUTPUT_ROOT = Path(os.environ.get(\"OUTPUT_ROOT\", TOPIC_ROOT / \"outputs\"))\n",
"\n",
"# The AMD teaching workflow should be runnable from local datasets/checkpoints.\n",
"# Avoid surprising network calls during class or when AUP/Radeon Cloud cannot\n",
"# reach Hugging Face.\n",
"os.environ.setdefault(\"HF_HUB_OFFLINE\", os.environ.get(\"NOTEBOOK_HF_OFFLINE\", \"1\"))\n",
"os.environ.setdefault(\"TRANSFORMERS_OFFLINE\", os.environ.get(\"NOTEBOOK_HF_OFFLINE\", \"1\"))\n",
"os.environ.setdefault(\"HF_DATASETS_OFFLINE\", os.environ.get(\"NOTEBOOK_HF_OFFLINE\", \"1\"))\n",
"os.environ.setdefault(\"HF_HOME\", str(Path(os.environ.get(\"CACHE_ROOT\", OUTPUT_ROOT / \"cache\")) / \"huggingface\"))\n",
"os.environ.setdefault(\"HF_DATASETS_CACHE\", str(Path(os.environ[\"HF_HOME\"]) / \"datasets\"))\n",
"\n",
"def public_path(path):\n",
" path = Path(path)\n",
" replacements = [\n",
" (TOPIC_ROOT, \"$TOPIC_ROOT\"),\n",
" (PROJECT_ROOT, \"$PROJECT_ROOT\"),\n",
" (DATA_ROOT, \"$DATA_ROOT\"),\n",
" (MODEL_ROOT, \"$MODEL_ROOT\"),\n",
" (OUTPUT_ROOT, \"$OUTPUT_ROOT\"),\n",
" ]\n",
" value = str(path)\n",
" for root, label in sorted(replacements, key=lambda item: len(str(item[0])), reverse=True):\n",
" root_value = str(root)\n",
" if root_value and value.startswith(root_value):\n",
" return label + value[len(root_value):]\n",
" return value\n",
"\n",
"\n",
"print(\"TOPIC_ROOT = $TOPIC_ROOT\")\n",
"print(\"PROJECT_ROOT =\", public_path(PROJECT_ROOT))\n",
"print(\"DATA_ROOT =\", public_path(DATA_ROOT))\n",
"print(\"MODEL_ROOT =\", public_path(MODEL_ROOT))\n",
"print(\"OUTPUT_ROOT =\", public_path(OUTPUT_ROOT))\n"
]
},
{
"cell_type": "code",
"execution_count": null,
"metadata": {},
"outputs": [],
"source": [
"def md_table(headers, rows):\n",
" lines = [\"| \" + \" | \".join(headers) + \" |\", \"| \" + \" | \".join([\"---\"] * len(headers)) + \" |\"]\n",
" for row in rows:\n",
" lines.append(\"| \" + \" | \".join(public_path(x) if isinstance(x, (str, Path)) else str(x) for x in row) + \" |\")\n",
" display(Markdown(\"\\n\".join(lines)))\n",
"\n",
"\n",
"def show_json(path, max_chars=5000):\n",
" path = Path(path)\n",
" if not path.exists():\n",
" print(\"文件不存在:\", public_path(path))\n",
" return None\n",
" data = json.loads(path.read_text(encoding=\"utf-8\"))\n",
" text = json.dumps(data, ensure_ascii=False, indent=2)\n",
" print(text[:max_chars] + (\"\\n...\" if len(text) > max_chars else \"\"))\n",
" return data\n",
"\n",
"\n",
"def show_video(filename, title):\n",
" path = ASSET_DIR / filename\n",
" display(Markdown(f\"**{title}**\"))\n",
" if path.exists():\n",
" rel = f\"../assets/{filename}\"\n",
" display(HTML(f\"\"))\n",
" else:\n",
" print(\"缺少视频素材:\", public_path(path))\n",
"\n",
"\n",
"def show_image(filename, title, width=960):\n",
" path = ASSET_DIR / filename\n",
" display(Markdown(f\"**{title}**\"))\n",
" if path.exists():\n",
" rel = f\"../assets/{filename}\"\n",
" display(HTML(f\" \"))\n",
" else:\n",
" print(\"缺少图片素材:\", public_path(path))\n",
"\n",
"\n",
"def run_cmd_preview(command, cwd=None):\n",
" shown = [public_path(x) if isinstance(x, (str, Path)) else x for x in command]\n",
" print(\"$\", shlex.join([str(x) for x in shown]))\n",
" if cwd:\n",
" print(\"cwd =\", public_path(cwd))\n",
"\n",
"\n",
"def tail_log(log_path, lines=40):\n",
" path = Path(log_path)\n",
" if not path.exists():\n",
" print(\"日志不存在:\", public_path(path))\n",
" return\n",
" content = path.read_text(encoding=\"utf-8\", errors=\"replace\").splitlines()\n",
" print(\"\\n\".join(content[-lines:]))\n",
"\n",
"\n",
"def env_flag(name, default=False):\n",
" value = os.environ.get(name)\n",
" if value is None:\n",
" return default\n",
" return value.strip().lower() in {\"1\", \"true\", \"yes\", \"y\", \"on\"}\n",
"\n",
"\n",
"RUN_SMOKE = env_flag(\"RUN_SMOKE\")\n",
"RUN_LONG_TRAIN = env_flag(\"RUN_LONG_TRAIN\", True)\n",
"RUN_EVAL = env_flag(\"RUN_EVAL\")\n",
"EVAL_SCRIPT = Path(os.environ.get(\"EVAL_SCRIPT\", PROJECT_ROOT / \"eval_policy_success.py\"))\n",
"\n",
"\n",
"_XVFB_PROCESS = None\n",
"\n",
"\n",
"def ensure_xvfb_display():\n",
" \"\"\"Start a lightweight virtual display for headless MuJoCo evaluation.\"\"\"\n",
" global _XVFB_PROCESS\n",
" if os.environ.get(\"DISPLAY\"):\n",
" print(\"DISPLAY =\", os.environ[\"DISPLAY\"])\n",
" return None\n",
" xvfb_bin = shutil.which(\"Xvfb\")\n",
" if not xvfb_bin:\n",
" print(\"没有发现 Xvfb;如遇 GLFW DISPLAY 报错,请先安装 xvfb。\")\n",
" return None\n",
" display_id = os.environ.get(\"NOTEBOOK_XVFB_DISPLAY\", \":99\")\n",
" _XVFB_PROCESS = subprocess.Popen(\n",
" [xvfb_bin, display_id, \"-screen\", \"0\", \"1280x1024x24\"],\n",
" stdout=subprocess.DEVNULL,\n",
" stderr=subprocess.DEVNULL,\n",
" )\n",
" os.environ[\"DISPLAY\"] = display_id\n",
" print(\"已启动 Notebook 内部 Xvfb:DISPLAY =\", display_id)\n",
" return _XVFB_PROCESS\n",
"\n",
"\n",
"def ensure_project_layout():\n",
" required = [PROJECT_ROOT / \"asset\" / \"example_scene_y2.xml\", PROJECT_ROOT / \"mujoco_env\"]\n",
" missing = [path for path in required if not path.exists()]\n",
" if missing:\n",
" print(\"当前 PROJECT_ROOT 还不是可运行工程,缺少:\")\n",
" for path in missing:\n",
" print(\" -\", public_path(path))\n",
" print(\"请先设置 PROJECT_ROOT,再运行训练或评估单元。\")\n",
" return False\n",
" return True\n",
"\n",
"\n",
"def write_json_yaml(path, payload):\n",
" path = Path(path)\n",
" path.parent.mkdir(parents=True, exist_ok=True)\n",
" try:\n",
" import yaml\n",
" text = yaml.safe_dump(payload, allow_unicode=True, sort_keys=False)\n",
" except Exception:\n",
" text = json.dumps(payload, ensure_ascii=False, indent=2) + \"\\n\"\n",
" path.write_text(text, encoding=\"utf-8\")\n",
" print(\"写出配置:\", public_path(path))\n",
" return path\n",
"\n",
"\n",
"def make_lerobot_train_config(policy_type, dataset_repo_id, dataset_root, output_dir, steps, batch_size, chunk_size, n_action_steps, seed=42):\n",
" save_freq = int(os.environ.get(f\"{policy_type.upper()}_SAVE_FREQ\", os.environ.get(\"SAVE_FREQ\", str(steps))))\n",
" return {\n",
" \"dataset\": {\n",
" \"repo_id\": dataset_repo_id,\n",
" \"root\": str(dataset_root),\n",
" \"use_imagenet_stats\": True,\n",
" },\n",
" \"policy\": {\n",
" \"type\": policy_type,\n",
" \"chunk_size\": int(chunk_size),\n",
" \"n_action_steps\": int(n_action_steps),\n",
" \"device\": \"cuda\",\n",
" },\n",
" \"output_dir\": str(output_dir),\n",
" \"job_name\": Path(output_dir).name,\n",
" \"batch_size\": int(batch_size),\n",
" \"steps\": int(steps),\n",
" \"save_freq\": max(1, save_freq),\n",
" \"log_freq\": 20,\n",
" \"num_workers\": 4,\n",
" \"seed\": int(seed),\n",
" \"resume\": False,\n",
" \"eval_freq\": -1,\n",
" \"save_checkpoint\": True,\n",
" \"use_policy_training_preset\": True,\n",
" \"wandb\": {\"enable\": False, \"disable_artifact\": True},\n",
" }\n",
"\n",
"\n",
"def train_lerobot_config_in_notebook(config_path, enabled=False, progress_name=\"train\"):\n",
" \"\"\"Run LeRobot offline training directly inside the notebook kernel.\n",
"\n",
" The notebook cell owns dataset creation, policy creation, optimizer steps,\n",
" checkpoint saving, tqdm progress, and metric JSONL writing.\n",
" \"\"\"\n",
" config_path = Path(config_path)\n",
" print(\"config =\", public_path(config_path))\n",
" if not enabled:\n",
" print(\"未启动。设置 RUN_SMOKE=1 或 RUN_LONG_TRAIN=1 后,本单元会直接在 Notebook 内训练。\")\n",
" return None\n",
" if not ensure_project_layout():\n",
" return None\n",
"\n",
" import time\n",
" from contextlib import nullcontext\n",
"\n",
" import draccus\n",
" import torch\n",
" from torch.amp import GradScaler\n",
"\n",
" from lerobot.common.datasets.factory import make_dataset\n",
" from lerobot.common.datasets.sampler import EpisodeAwareSampler\n",
" from lerobot.common.datasets.utils import cycle\n",
" from lerobot.common.optim.factory import make_optimizer_and_scheduler\n",
" from lerobot.common.policies.factory import make_policy\n",
" from lerobot.common.policies.utils import get_device_from_parameters\n",
" from lerobot.common.utils.random_utils import set_seed\n",
" from lerobot.common.utils.train_utils import get_step_checkpoint_dir, save_checkpoint, update_last_checkpoint\n",
" from lerobot.common.utils.utils import get_safe_torch_device\n",
" from lerobot.configs.train import TrainPipelineConfig\n",
"\n",
" class _CompactProgress:\n",
" def __init__(self, iterable, desc, total=None):\n",
" self.iterable = iterable\n",
" self.desc = desc\n",
" self.total = int(total if total is not None else len(iterable))\n",
" self.every = max(1, int(os.environ.get(\"NOTEBOOK_PROGRESS_EVERY\", \"100\")))\n",
" self.postfix = \"\"\n",
"\n",
" def set_postfix(self, **kwargs):\n",
" self.postfix = \", \".join(f\"{key}={value}\" for key, value in kwargs.items())\n",
"\n",
" def __iter__(self):\n",
" for index, value in enumerate(self.iterable, start=1):\n",
" yield value\n",
" if index == 1 or index == self.total or index % self.every == 0:\n",
" suffix = f\" | {self.postfix}\" if self.postfix else \"\"\n",
" print(f\"{self.desc}: {index}/{self.total}{suffix}\", flush=True)\n",
"\n",
" def notebook_progress(iterable, desc, total=None):\n",
" return _CompactProgress(iterable, desc, total=total)\n",
"\n",
" cfg = draccus.parse(TrainPipelineConfig, config_path=config_path, args=[])\n",
" cfg.validate()\n",
" if cfg.seed is not None:\n",
" set_seed(cfg.seed)\n",
"\n",
" device = get_safe_torch_device(cfg.policy.device, log=True)\n",
" torch.backends.cudnn.benchmark = True\n",
" torch.backends.cuda.matmul.allow_tf32 = True\n",
"\n",
" print(\"Creating dataset...\")\n",
" dataset = make_dataset(cfg)\n",
" print(\"Creating policy...\")\n",
" pretrained_override = os.environ.get(f\"{cfg.policy.type.upper()}_PRETRAINED_PATH_OVERRIDE\") or os.environ.get(\"POLICY_PRETRAINED_PATH_OVERRIDE\")\n",
" if pretrained_override and not cfg.resume:\n",
" cfg.policy.pretrained_path = str(Path(pretrained_override))\n",
" print(\"pretrained override =\", public_path(cfg.policy.pretrained_path))\n",
" elif cfg.policy.type == \"pi0\" and not cfg.resume:\n",
" cfg.policy.pretrained_path = \"lerobot/pi0\"\n",
" elif cfg.policy.type == \"smolvla\" and not cfg.resume:\n",
" smolvla_base_candidates = [\n",
" os.environ.get(\"SMOLVLA_BASE_PATH\"),\n",
" os.environ.get(\"SMOLVLA_PRETRAINED_BASE_PATH\"),\n",
" str(MODEL_ROOT / \"smolvla_base\" / \"pretrained_model\"),\n",
" str(MODEL_ROOT / \"lerobot_smolvla_base_legacy\"),\n",
" str(MODEL_ROOT / \"lerobot_smolvla_base\"),\n",
" ]\n",
" local_smolvla_base = next((Path(p) for p in smolvla_base_candidates if p and Path(p).exists()), None)\n",
" if local_smolvla_base is not None:\n",
" cfg.policy.pretrained_path = str(local_smolvla_base)\n",
" print(\"local smolvla base =\", public_path(cfg.policy.pretrained_path))\n",
" else:\n",
" cfg.policy.pretrained_path = \"lerobot/smolvla_base\"\n",
" if cfg.policy.type == \"smolvla\":\n",
" local_vlm_model = os.environ.get(\"SMOLVLA_VLM_MODEL_PATH\")\n",
" if local_vlm_model and Path(local_vlm_model).exists():\n",
" cfg.policy.vlm_model_name = str(Path(local_vlm_model))\n",
" cfg.policy.load_vlm_weights = False\n",
" print(\"local smolvlm processor/config =\", public_path(cfg.policy.vlm_model_name))\n",
"\n",
" policy = make_policy(cfg=cfg.policy, ds_meta=dataset.meta)\n",
"\n",
" # Compatibility for newer Transformers: PaliGemmaForConditionalGeneration may expose\n",
" # language_model as GemmaModel directly, while this LeRobot Pi0 code expects\n",
" # language_model.model. Use a non-Module proxy so checkpoints/state_dict stay clean.\n",
" if cfg.policy.type == \"pi0\":\n",
" try:\n",
" lm = policy.model.paligemma_with_expert.paligemma.language_model\n",
" if not hasattr(lm, \"model\"):\n",
" class _LanguageModelCoreProxy:\n",
" def __init__(self, core):\n",
" self._core = core\n",
"\n",
" def __getattr__(self, name):\n",
" return getattr(self._core, name)\n",
"\n",
" object.__setattr__(lm, \"model\", _LanguageModelCoreProxy(lm))\n",
" print(\"patched Pi0 PaliGemma language_model.model compatibility proxy\")\n",
" except Exception as exc:\n",
" print(f\"Pi0 PaliGemma compatibility patch skipped: {exc}\")\n",
"\n",
" policy.to(device)\n",
" policy.train()\n",
"\n",
" optimizer, lr_scheduler = make_optimizer_and_scheduler(cfg, policy)\n",
" grad_scaler = GradScaler(device.type, enabled=cfg.policy.use_amp)\n",
"\n",
" def _dataset_column_values(name):\n",
" hf_dataset = getattr(dataset, \"hf_dataset\", None)\n",
" if hf_dataset is None or name not in getattr(hf_dataset, \"column_names\", []):\n",
" return None\n",
" values = hf_dataset[name]\n",
" try:\n",
" return list(values)\n",
" except TypeError:\n",
" return [values[i] for i in range(len(values))]\n",
"\n",
" def _task_name_map():\n",
" meta = getattr(dataset, \"meta\", None)\n",
" tasks = getattr(meta, \"tasks\", None)\n",
" if tasks is None:\n",
" return {}\n",
" if isinstance(tasks, dict):\n",
" return {int(k): str(v) for k, v in tasks.items()}\n",
" try:\n",
" return {int(k): str(v) for k, v in dict(tasks).items()}\n",
" except Exception:\n",
" return {}\n",
"\n",
" def _make_weighted_sampler(generator):\n",
" mode = os.environ.get(\"NOTEBOOK_FRAME_WEIGHT_MODE\", \"\").strip().lower()\n",
" if not mode or mode in {\"0\", \"none\", \"off\", \"false\"}:\n",
" return None, {\"mode\": \"none\"}\n",
" weights = torch.ones(len(dataset), dtype=torch.double)\n",
" info = {\"mode\": mode, \"num_frames\": len(dataset)}\n",
"\n",
" if \"blue\" in mode:\n",
" blue_weight = float(os.environ.get(\"NOTEBOOK_BLUE_WEIGHT\", \"2.0\"))\n",
" mask = [False] * len(dataset)\n",
" task_indices = _dataset_column_values(\"task_index\")\n",
" task_names = _task_name_map()\n",
" if task_indices is not None and task_names:\n",
" for idx, task_index in enumerate(task_indices):\n",
" task_text = task_names.get(int(task_index), \"\").lower()\n",
" mask[idx] = (\"blue\" in task_text) or (\"蓝\" in task_text)\n",
" else:\n",
" for column in [\"task\", \"language_instruction\", \"instruction\"]:\n",
" values = _dataset_column_values(column)\n",
" if values is None:\n",
" continue\n",
" for idx, value in enumerate(values):\n",
" text = str(value).lower()\n",
" mask[idx] = (\"blue\" in text) or (\"蓝\" in text)\n",
" break\n",
" blue_count = int(sum(mask))\n",
" if blue_count == 0:\n",
" print(\"警告:NOTEBOOK_FRAME_WEIGHT_MODE=blue 但没有识别到 blue/蓝 指令帧,采样退回均匀。\")\n",
" else:\n",
" for idx, is_blue in enumerate(mask):\n",
" if is_blue:\n",
" weights[idx] *= blue_weight\n",
" info.update({\"blue_weight\": blue_weight, \"blue_frames\": blue_count})\n",
"\n",
" weight_file = os.environ.get(\"NOTEBOOK_FRAME_WEIGHT_JSON\")\n",
" if weight_file:\n",
" payload = json.loads(Path(weight_file).read_text(encoding=\"utf-8\"))\n",
" for key, value in payload.items():\n",
" weights[int(key)] *= float(value)\n",
" info.update({\"weight_json\": public_path(weight_file), \"json_entries\": len(payload)})\n",
"\n",
" if float(weights.sum()) <= 0:\n",
" raise ValueError(\"采样权重总和为 0。\")\n",
" sampler = torch.utils.data.WeightedRandomSampler(\n",
" weights=weights,\n",
" num_samples=len(weights),\n",
" replacement=True,\n",
" generator=generator,\n",
" )\n",
" info.update(\n",
" {\n",
" \"weight_min\": float(weights.min()),\n",
" \"weight_max\": float(weights.max()),\n",
" \"weight_mean\": float(weights.mean()),\n",
" }\n",
" )\n",
" return sampler, info\n",
"\n",
" generator = torch.Generator()\n",
" if cfg.seed is not None:\n",
" generator.manual_seed(int(cfg.seed))\n",
"\n",
" weighted_sampler, sampler_info = _make_weighted_sampler(generator)\n",
" if weighted_sampler is not None:\n",
" shuffle = False\n",
" sampler = weighted_sampler\n",
" print(\"Notebook weighted sampler =\", json.dumps(sampler_info, ensure_ascii=False))\n",
" elif hasattr(cfg.policy, \"drop_n_last_frames\"):\n",
" shuffle = False\n",
" sampler = EpisodeAwareSampler(\n",
" dataset.episode_data_index,\n",
" drop_n_last_frames=cfg.policy.drop_n_last_frames,\n",
" shuffle=True,\n",
" )\n",
" else:\n",
" shuffle = True\n",
" sampler = None\n",
"\n",
" dataloader = torch.utils.data.DataLoader(\n",
" dataset,\n",
" num_workers=cfg.num_workers,\n",
" batch_size=cfg.batch_size,\n",
" shuffle=shuffle,\n",
" sampler=sampler,\n",
" generator=generator if sampler is None else None,\n",
" pin_memory=device.type != \"cpu\",\n",
" drop_last=False,\n",
" )\n",
" dl_iter = cycle(dataloader)\n",
"\n",
" output_dir = Path(cfg.output_dir)\n",
" output_dir.mkdir(parents=True, exist_ok=True)\n",
" metrics_path = output_dir / \"notebook_train_metrics.jsonl\"\n",
" num_learnable = sum(p.numel() for p in policy.parameters() if p.requires_grad)\n",
" num_total = sum(p.numel() for p in policy.parameters())\n",
" print(f\"output_dir = {public_path(output_dir)}\")\n",
" print(f\"steps = {cfg.steps}, batch_size = {cfg.batch_size}, frames = {dataset.num_frames}, episodes = {dataset.num_episodes}\")\n",
" print(f\"learnable_params = {num_learnable:,}, total_params = {num_total:,}\")\n",
"\n",
" last_metrics = None\n",
" progress = notebook_progress(range(1, cfg.steps + 1), desc=progress_name, total=cfg.steps)\n",
" start_all = time.perf_counter()\n",
" for step in progress:\n",
" load_start = time.perf_counter()\n",
" batch = next(dl_iter)\n",
" data_s = time.perf_counter() - load_start\n",
" for key, value in batch.items():\n",
" if isinstance(value, torch.Tensor):\n",
" batch[key] = value.to(device, non_blocking=True)\n",
"\n",
" update_start = time.perf_counter()\n",
" device_from_policy = get_device_from_parameters(policy)\n",
" with torch.autocast(device_type=device_from_policy.type) if cfg.policy.use_amp else nullcontext():\n",
" loss, output_dict = policy.forward(batch)\n",
" grad_scaler.scale(loss).backward()\n",
" grad_scaler.unscale_(optimizer)\n",
" grad_norm = torch.nn.utils.clip_grad_norm_(\n",
" policy.parameters(),\n",
" cfg.optimizer.grad_clip_norm,\n",
" error_if_nonfinite=False,\n",
" )\n",
" grad_scaler.step(optimizer)\n",
" grad_scaler.update()\n",
" optimizer.zero_grad()\n",
" if lr_scheduler is not None:\n",
" lr_scheduler.step()\n",
" if hasattr(policy, \"update\"):\n",
" policy.update()\n",
" update_s = time.perf_counter() - update_start\n",
"\n",
" is_log_step = cfg.log_freq > 0 and (step % cfg.log_freq == 0 or step == 1 or step == cfg.steps)\n",
" is_saving_step = cfg.save_checkpoint and (step % cfg.save_freq == 0 or step == cfg.steps)\n",
" if is_log_step:\n",
" last_metrics = {\n",
" \"step\": step,\n",
" \"loss\": float(loss.detach().cpu()),\n",
" \"grad_norm\": float(grad_norm.detach().cpu()) if hasattr(grad_norm, \"detach\") else float(grad_norm),\n",
" \"lr\": float(optimizer.param_groups[0][\"lr\"]),\n",
" \"update_s\": float(update_s),\n",
" \"data_s\": float(data_s),\n",
" \"elapsed_s\": float(time.perf_counter() - start_all),\n",
" }\n",
" with metrics_path.open(\"a\", encoding=\"utf-8\") as f:\n",
" f.write(json.dumps(last_metrics, ensure_ascii=False) + \"\\n\")\n",
" progress.set_postfix(\n",
" loss=f\"{last_metrics['loss']:.4f}\",\n",
" lr=f\"{last_metrics['lr']:.1e}\",\n",
" updt_s=f\"{last_metrics['update_s']:.3f}\",\n",
" )\n",
" if is_saving_step:\n",
" checkpoint_dir = get_step_checkpoint_dir(cfg.output_dir, cfg.steps, step)\n",
" print(f\"\\nSaving checkpoint at step {step}: {public_path(checkpoint_dir)}\")\n",
" save_checkpoint(checkpoint_dir, step, cfg, policy, optimizer, lr_scheduler)\n",
" update_last_checkpoint(checkpoint_dir)\n",
"\n",
" print(\"训练完成。metrics =\", public_path(metrics_path))\n",
" if last_metrics is not None:\n",
" print(json.dumps(last_metrics, ensure_ascii=False, indent=2))\n",
" return {\"output_dir\": output_dir, \"metrics_path\": metrics_path, \"last_metrics\": last_metrics}\n",
"\n",
"\n",
"def load_eval_module():\n",
" import importlib.util\n",
"\n",
" if not EVAL_SCRIPT.exists():\n",
" raise FileNotFoundError(f\"评估脚本不存在:{public_path(EVAL_SCRIPT)}\")\n",
" spec = importlib.util.spec_from_file_location(\"notebook_eval_policy_success\", EVAL_SCRIPT)\n",
" module = importlib.util.module_from_spec(spec)\n",
" assert spec.loader is not None\n",
" spec.loader.exec_module(module)\n",
" return module\n",
"\n",
"\n",
"def run_eval_policy_in_notebook(\n",
" policy_name,\n",
" policy_path,\n",
" result_path,\n",
" episodes,\n",
" seed_start,\n",
" render=False,\n",
" enabled=False,\n",
" repo_id=None,\n",
" dataset_root=None,\n",
"):\n",
" print(\"policy =\", policy_name)\n",
" print(\"policy_path =\", public_path(policy_path))\n",
" print(\"result =\", public_path(result_path))\n",
" if not enabled:\n",
" print(\"未启动。设置 RUN_EVAL=1 后,本单元会在 Notebook 内直接加载策略并闭环评估。\")\n",
" return None\n",
" if not ensure_project_layout():\n",
" return None\n",
"\n",
" import argparse\n",
" from contextlib import contextmanager\n",
"\n",
" @contextmanager\n",
" def pushd(path):\n",
" old = Path.cwd()\n",
" os.chdir(path)\n",
" try:\n",
" yield\n",
" finally:\n",
" os.chdir(old)\n",
"\n",
" ensure_xvfb_display()\n",
" module = load_eval_module()\n",
" result_path = Path(result_path)\n",
" result_path.parent.mkdir(parents=True, exist_ok=True)\n",
" if result_path.exists():\n",
" result_path.unlink()\n",
"\n",
" args = argparse.Namespace(\n",
" policy=policy_name,\n",
" episodes=int(episodes),\n",
" seed_start=int(seed_start),\n",
" max_action_steps=int(os.environ.get(\"EVAL_MAX_ACTION_STEPS\", \"400\")),\n",
" hz=float(os.environ.get(\"EVAL_HZ\", \"20\")),\n",
" render=bool(render),\n",
" output_jsonl=result_path,\n",
" device=os.environ.get(\"EVAL_DEVICE\", \"cuda\"),\n",
" reset_policy_each_action=env_flag(\"EVAL_RESET_POLICY_EACH_ACTION\", False),\n",
" act_n_action_steps=None,\n",
" act_force_dataset_gripper=False,\n",
" act_clamp_timestamp=False,\n",
" act_policy_path=Path(policy_path),\n",
" act_repo_id=repo_id or \"datawhale_eai_pnp\",\n",
" act_dataset_root=Path(dataset_root or \"./demo_data\"),\n",
" act_episode_timestamp_offsets=\"\",\n",
" act_episode_source_flags=\"\",\n",
" physical_success=env_flag(\"EVAL_PHYSICAL_SUCCESS\", True),\n",
" physical_min_lift=float(os.environ.get(\"EVAL_PHYSICAL_MIN_LIFT\", \"0.06\")),\n",
" physical_min_lift_steps=int(os.environ.get(\"EVAL_PHYSICAL_MIN_LIFT_STEPS\", \"3\")),\n",
" physical_final_upright_cos=float(os.environ.get(\"EVAL_PHYSICAL_FINAL_UPRIGHT_COS\", \"0.85\")),\n",
" smolvla_policy_path=Path(policy_path),\n",
" pi0_policy_path=Path(policy_path),\n",
" pi0_repo_id=repo_id or os.environ.get(\"PI0_DATASET_REPO_ID\", \"datawhale_eai_pnp_language\"),\n",
" pi0_dataset_root=Path(dataset_root or os.environ.get(\"PI0_DATASET_ROOT\", \"./demo_data_language\")),\n",
" )\n",
"\n",
" with pushd(PROJECT_ROOT):\n",
" if policy_name == \"act\":\n",
" policy = module.make_act_policy(\n",
" args.device,\n",
" args.act_policy_path,\n",
" args.act_repo_id,\n",
" args.act_dataset_root,\n",
" n_action_steps=args.act_n_action_steps,\n",
" episode_timestamp_offsets=args.act_episode_timestamp_offsets,\n",
" episode_source_flags=args.act_episode_source_flags,\n",
" )\n",
" rollout = module.rollout_act\n",
" elif policy_name == \"smolvla\":\n",
" policy = module.make_smolvla_policy(args.device, args.smolvla_policy_path)\n",
" rollout = module.rollout_language_policy\n",
" elif policy_name == \"pi0\":\n",
" policy = module.make_pi0_policy(args.device, args.pi0_policy_path, args.pi0_repo_id, args.pi0_dataset_root)\n",
" rollout = module.rollout_language_policy\n",
" else:\n",
" raise ValueError(policy_name)\n",
"\n",
" rows = []\n",
" for offset in notebook_progress(range(args.episodes), desc=f\"{policy_name} eval\", total=args.episodes):\n",
" seed = args.seed_start + offset\n",
" row = rollout(args, policy, seed)\n",
" rows.append(row)\n",
" with result_path.open(\"a\", encoding=\"utf-8\") as f:\n",
" f.write(json.dumps(row, ensure_ascii=False) + \"\\n\")\n",
" print(json.dumps(row, ensure_ascii=False))\n",
" summarize_jsonl(result_path)\n",
" return rows\n",
"\n",
"\n",
"def list_checkpoints(run_dir):\n",
" run_dir = Path(run_dir)\n",
" candidates = []\n",
" for pattern in [\"checkpoints/*/pretrained_model\", \"checkpoint*/pretrained_model\", \"*/pretrained_model\", \"pretrained_model\"]:\n",
" candidates.extend(run_dir.glob(pattern))\n",
" unique = sorted(set(candidates))\n",
" if not unique:\n",
" print(\"尚未发现 checkpoint:\", public_path(run_dir))\n",
" return []\n",
" for path in unique:\n",
" print(\" -\", public_path(path))\n",
" return unique\n",
"\n",
"\n",
"def resolve_eval_policy(default_path, trained_run_dir=None, env_name=None):\n",
" if env_name and os.environ.get(env_name):\n",
" path = Path(os.environ[env_name])\n",
" print(\"评估使用环境变量指定权重:\", public_path(path))\n",
" return path\n",
" if trained_run_dir is not None and env_flag(\"EVAL_USE_LONG_TRAIN\"):\n",
" checkpoints = list_checkpoints(trained_run_dir)\n",
" if checkpoints:\n",
" path = checkpoints[-1]\n",
" print(\"评估使用本次长训最新 checkpoint:\", public_path(path))\n",
" return path\n",
" print(\"未找到本次长训 checkpoint,回退到保护权重。\")\n",
" path = Path(default_path)\n",
" print(\"评估使用保护/预训练权重:\", public_path(path))\n",
" return path\n",
"\n",
"\n",
"def summarize_jsonl(path):\n",
" path = Path(path)\n",
" if not path.exists():\n",
" print(\"结果 JSONL 尚不存在:\", public_path(path))\n",
" return None\n",
" rows = [json.loads(line) for line in path.read_text(encoding=\"utf-8\").splitlines() if line.strip()]\n",
" total = len(rows)\n",
" legacy = sum(bool(row.get(\"success\") or row.get(\"legacy_success\")) for row in rows)\n",
" if rows and all(\"physical_success\" in row for row in rows):\n",
" physical_count = sum(bool(row.get(\"physical_success\")) for row in rows)\n",
" physical_text = str(physical_count) + \"/\" + str(total)\n",
" else:\n",
" physical_text = \"未记录\"\n",
" md_table(\n",
" [\"结果文件\", \"episodes\", \"legacy_success\", \"physical_success\"],\n",
" [(public_path(path), total, f\"{legacy}/{total}\", physical_text)],\n",
" )\n",
" return rows\n"
]
},
{
"cell_type": "markdown",
"metadata": {},
"source": "## 运行控制台:先在这里选择本次实验\n\n下面这个单元格是三个模型通用的开关。默认全部关闭,避免打开 Notebook 后误启动数小时训练。\n\n建议顺序:\n\n1. 第一次把 `RUN_SMOKE` 设为 `True`,确认环境、数据、模型和一次反向传播都正常。\n2. 确认无误后把 `RUN_LONG_TRAIN` 设为 `True`,执行后面的真实训练单元格,Notebook 会显示实时 `tqdm`、loss、耗时和 checkpoint。\n3. 训练完成后把 `RUN_EVAL` 设为 `True`,执行严格评估单元格,结果会汇总为 `x/y` 成功率,并在有渲染条件时保存视频。\n4. 如果要复现正式保护结果,再把 `RUN_PROTECTED_TRAIN` 设为 `True`,执行对应 protected recipe 单元格。它和普通教学长训是两条明确标注的训练谱系。\n\n训练循环和评估循环都在 Notebook Python kernel 内执行,不是 `cat` 静态日志,也不是把训练交给外部 shell 脚本。\n"
},
{
"cell_type": "code",
"execution_count": null,
"metadata": {},
"outputs": [],
"source": [
"# RUN_CONTROL_CELL\n",
"# 只修改下面四个布尔值,然后按顺序执行后面的单元格。\n",
"RUN_SMOKE = False\n",
"RUN_LONG_TRAIN = True\n",
"RUN_EVAL = False\n",
"RUN_PROTECTED_TRAIN = False\n",
"\n",
"print({\n",
" 'RUN_SMOKE': RUN_SMOKE,\n",
" 'RUN_LONG_TRAIN': RUN_LONG_TRAIN,\n",
" 'RUN_EVAL': RUN_EVAL,\n",
" 'RUN_PROTECTED_TRAIN': RUN_PROTECTED_TRAIN,\n",
"})\n",
"print('长训通常需要几十分钟到数小时;评估会逐 episode 闭环运行,时间更长。')\n"
]
},
{
"cell_type": "markdown",
"metadata": {},
"source": "## Checkpoint 1:先确认这一版为什么作为主线\n"
},
{
"cell_type": "markdown",
"metadata": {},
"source": [
"## 结果对照\n",
"\n",
"| 项目 | 结果 | 说明 |\n",
"| --- | --- | --- |\n",
"| 历史教程记录 | 53/60 | SmolVLA weighted step500,红蓝杯平衡较好 |\n",
"| 当前重建结果 | 57/60 | red 27/30,blue 30/30 |\n",
"| 发布建议 | 主推权重 | 适合作为零训练预览和默认 Notebook 案例 |\n"
]
},
{
"cell_type": "markdown",
"metadata": {},
"source": "## Checkpoint 2:显示严格成功与失败视频\n"
},
{
"cell_type": "markdown",
"metadata": {},
"source": "## Checkpoint 1.5:保护权重的训练配方,不和课堂轻量训练混用\n\n 上一个单元给出的是已经保护的 `57/60` 结果。这里说明它是怎么训练出来的。课堂默认长训只是让学习者体验完整流程;要复现保护权重,需要切到下面的 protected recipe,并跑完整训练与 60 episode strict eval。\n"
},
{
"cell_type": "markdown",
"metadata": {},
"source": "### 结果口径对齐:本轮小面板与正式保护评估\n\n Notebook 后面的 eval 单元会跑一个便宜的小面板,用来确认本轮 checkpoint 能闭环执行并产出视频;正式保护评估使用更大的固定面板,才是发布权重和教程报告采用的口径。\n\n | 口径 | 成功率 | 评估范围 | 教学解释 |\n | --- | --- | --- | --- |\n | 本轮 Notebook 小面板 | `3/4` | post-long eval seed0-3 | 用于课堂展示和视频验收,不替代正式分数 |\n | 正式保护评估 | `57/60` | red30 + blue30 strict physical success | 红 `27/30`、蓝 `30/30`,作为默认发布权重 |\n"
},
{
"cell_type": "code",
"execution_count": 4,
"metadata": {},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": "{\n \"TEACHING_RECIPE\": \"protected\",\n \"TRAIN_DATA_ROOT\": \"$TRAIN_DATA_ROOT\",\n \"SMOLVLA_STEPS\": \"5000 + weighted-blue continuation\",\n \"SMOLVLA_EVAL_EPISODES\": \"60\",\n \"SMOLVLA_POLICY_PATH\": \"$MODEL_ROOT/smolvla_weighted_000500/pretrained_model\"\n}\n注意:weighted-blue 采样逻辑必须和 README_04/README_06 中的 Weighted sampler 一致;普通课堂长训不能冒充 protected 结果。\n"
},
{
"output_type": "display_data",
"data": {
"text/markdown": "| 模式 | 数据 | 采样/数据策略 | 训练步数 | 评估面板 | 教学解释 |\n| --- | --- | --- | --- | --- | --- |\n| 教学默认 | demo_data_language | 普通 EpisodeAwareSampler | SMOLVLA_STEPS=5000 | 本轮小面板 3/4 | 用于课堂跑通和视频展示,不保证得到 57/60 |\n| 保护配方 parent | demo_data_language | 基础 SmolVLA 长训 | 5000 steps | 作为加权续训父权重 | 先得到可用 parent checkpoint |\n| 保护配方 weighted-blue | demo_data_language | 蓝杯 frame/episode 加权,不复制原始 parquet | 续训 1000 steps,选择 step500 | red30 + blue30 strict | 当前重建 57/60;红 27/30,蓝 30/30 |"
},
"metadata": {}
}
],
"source": [
"# PROTECTED_RECIPE_CELL\n",
"rows = [\n",
" (\"教学默认\", \"demo_data_language\", \"普通 EpisodeAwareSampler\", \"SMOLVLA_STEPS=5000\", \"本轮小面板 3/4\", \"用于课堂跑通和视频展示,不保证得到 57/60\"),\n",
" (\"保护配方 parent\", \"demo_data_language\", \"基础 SmolVLA 长训\", \"5000 steps\", \"作为加权续训父权重\", \"先得到可用 parent checkpoint\"),\n",
" (\"保护配方 weighted-blue\", \"demo_data_language\", \"蓝杯 frame/episode 加权,不复制原始 parquet\", \"续训 1000 steps,选择 step500\", \"red30 + blue30 strict\", \"当前重建 57/60;红 27/30,蓝 30/30\"),\n",
"]\n",
"md_table([\"模式\", \"数据\", \"采样/数据策略\", \"训练步数\", \"评估面板\", \"教学解释\"], rows)\n",
"\n",
"protected_env = {\n",
" \"TEACHING_RECIPE\": \"protected\",\n",
" \"TRAIN_DATA_ROOT\": str(DATA_ROOT / \"demo_data_language\"),\n",
" \"SMOLVLA_STEPS\": \"5000 + weighted-blue continuation\",\n",
" \"SMOLVLA_EVAL_EPISODES\": \"60\",\n",
" \"SMOLVLA_POLICY_PATH\": str(MODEL_ROOT / \"smolvla_weighted_000500\" / \"pretrained_model\"),\n",
"}\n",
"print(json.dumps(protected_env, ensure_ascii=False, indent=2))\n",
"print(\"注意:weighted-blue 采样逻辑必须和 README_04/README_06 中的 Weighted sampler 一致;普通课堂长训不能冒充 protected 结果。\")\n"
]
},
{
"cell_type": "markdown",
"metadata": {},
"source": "### 可执行 protected 训练:parent 5000 + weighted-blue 续训\n\n 设置 `RUN_PROTECTED_TRAIN=1` 后,这一格会在 Notebook 内部真实训练两个阶段:先训练 parent,再把 parent checkpoint 作为初始化继续做 blue 加权续训。默认关闭是为了避免课堂一打开就长训。\n"
},
{
"cell_type": "code",
"execution_count": null,
"metadata": {},
"outputs": [],
"source": [
"# PROTECTED_TRAIN_CELL\n",
"protected_train_enabled = globals().get(\"RUN_PROTECTED_TRAIN\", env_flag(\"RUN_PROTECTED_TRAIN\", False))\n",
"if not protected_train_enabled:\n",
" print(\"未启动。设置 RUN_PROTECTED_TRAIN=1 后,本单元会原生训练 SmolVLA protected recipe。\")\n",
"else:\n",
" DATASET_REPO_ID = globals().get(\"DATASET_REPO_ID\", os.environ.get(\"DATASET_REPO_ID\", \"datawhale_eai_pnp_language\"))\n",
" TRAIN_DATA_ROOT = globals().get(\"TRAIN_DATA_ROOT\", Path(os.environ.get(\"TRAIN_DATA_ROOT\", DATA_ROOT / \"demo_data_language\")))\n",
" CONFIG_DIR = OUTPUT_ROOT / \"configs\"\n",
" RUN_ROOT = OUTPUT_ROOT / \"runs\" / \"smolvla_protected_recipe\"\n",
" PARENT_OUTPUT = RUN_ROOT / \"parent_5000\"\n",
" WEIGHTED_OUTPUT = RUN_ROOT / \"weighted_blue2_step1000\"\n",
" parent_config = make_lerobot_train_config(\n",
" \"smolvla\", DATASET_REPO_ID, TRAIN_DATA_ROOT, PARENT_OUTPUT,\n",
" steps=int(os.environ.get(\"SMOLVLA_PARENT_STEPS\", \"5000\")),\n",
" batch_size=int(os.environ.get(\"SMOLVLA_BATCH_SIZE\", \"4\")),\n",
" chunk_size=50,\n",
" n_action_steps=50,\n",
" )\n",
" weighted_config = make_lerobot_train_config(\n",
" \"smolvla\", DATASET_REPO_ID, TRAIN_DATA_ROOT, WEIGHTED_OUTPUT,\n",
" steps=int(os.environ.get(\"SMOLVLA_WEIGHTED_STEPS\", \"1000\")),\n",
" batch_size=int(os.environ.get(\"SMOLVLA_BATCH_SIZE\", \"4\")),\n",
" chunk_size=50,\n",
" n_action_steps=50,\n",
" )\n",
" parent_path = write_json_yaml(CONFIG_DIR / \"smolvla_protected_parent_5000.yaml\", parent_config)\n",
" weighted_path = write_json_yaml(CONFIG_DIR / \"smolvla_protected_weighted_blue2.yaml\", weighted_config)\n",
" train_lerobot_config_in_notebook(parent_path, enabled=True, progress_name=\"SmolVLA protected parent\")\n",
" parent_ckpt = list_checkpoints(PARENT_OUTPUT)[-1]\n",
" old_override = os.environ.get(\"SMOLVLA_PRETRAINED_PATH_OVERRIDE\")\n",
" old_mode = os.environ.get(\"NOTEBOOK_FRAME_WEIGHT_MODE\")\n",
" old_blue = os.environ.get(\"NOTEBOOK_BLUE_WEIGHT\")\n",
" os.environ[\"SMOLVLA_PRETRAINED_PATH_OVERRIDE\"] = str(parent_ckpt)\n",
" os.environ[\"NOTEBOOK_FRAME_WEIGHT_MODE\"] = \"blue\"\n",
" os.environ[\"NOTEBOOK_BLUE_WEIGHT\"] = os.environ.get(\"SMOLVLA_BLUE_WEIGHT\", \"2.0\")\n",
" try:\n",
" train_lerobot_config_in_notebook(weighted_path, enabled=True, progress_name=\"SmolVLA protected weighted-blue\")\n",
" finally:\n",
" if old_override is None:\n",
" os.environ.pop(\"SMOLVLA_PRETRAINED_PATH_OVERRIDE\", None)\n",
" else:\n",
" os.environ[\"SMOLVLA_PRETRAINED_PATH_OVERRIDE\"] = old_override\n",
" if old_mode is None:\n",
" os.environ.pop(\"NOTEBOOK_FRAME_WEIGHT_MODE\", None)\n",
" else:\n",
" os.environ[\"NOTEBOOK_FRAME_WEIGHT_MODE\"] = old_mode\n",
" if old_blue is None:\n",
" os.environ.pop(\"NOTEBOOK_BLUE_WEIGHT\", None)\n",
" else:\n",
" os.environ[\"NOTEBOOK_BLUE_WEIGHT\"] = old_blue\n",
" print(\"protected candidate checkpoints:\")\n",
" list_checkpoints(WEIGHTED_OUTPUT)\n"
]
},
{
"cell_type": "code",
"execution_count": 6,
"metadata": {},
"outputs": [
{
"output_type": "display_data",
"data": {
"text/markdown": "**红杯成功回放:weighted500 seed0**"
},
"metadata": {}
},
{
"output_type": "display_data",
"data": {
"text/html": ""
},
"metadata": {}
},
{
"output_type": "display_data",
"data": {
"text/markdown": "**蓝杯成功回放:weighted500 seed0**"
},
"metadata": {}
},
{
"output_type": "display_data",
"data": {
"text/html": ""
},
"metadata": {}
},
{
"output_type": "display_data",
"data": {
"text/markdown": "**红杯失败回放:用于观察 upright/release 问题**"
},
"metadata": {}
},
{
"output_type": "display_data",
"data": {
"text/html": ""
},
"metadata": {}
}
],
"source": [
"show_video(\"smolvla_weighted500_red_success_seed0.mp4\", \"红杯成功回放:weighted500 seed0\")\n",
"show_video(\"smolvla_weighted500_blue_success_seed0.mp4\", \"蓝杯成功回放:weighted500 seed0\")\n",
"show_video(\"smolvla_weighted500_red_failure_seed8.mp4\", \"红杯失败回放:用于观察 upright/release 问题\")\n"
]
},
{
"cell_type": "markdown",
"metadata": {},
"source": "## Checkpoint 3:检查数据和权重路径\n\n 预计耗时:几秒。这里不会训练,只确认数据、权重和输出目录是否指向正确位置。\n"
},
{
"cell_type": "code",
"execution_count": 7,
"metadata": {},
"outputs": [
{
"output_type": "display_data",
"data": {
"text/markdown": "| 变量 | 当前值 |\n| --- | --- |\n| DATASET_REPO_ID | datawhale_eai_pnp_language |\n| TRAIN_DATA_ROOT | $DATA_ROOT/demo_data_language |\n| SMOLVLA_POLICY_PATH | $OUTPUT_ROOT/runs/smolvla_protected_recipe/weighted_blue2_step1000/checkpoints/001000/pretrained_model |\n| 数据 meta | $DATA_ROOT/demo_data_language/meta/info.json |"
},
"metadata": {}
}
],
"source": [
"DATASET_REPO_ID = os.environ.get(\"DATASET_REPO_ID\", \"datawhale_eai_pnp_language\")\n",
"TRAIN_DATA_ROOT = Path(os.environ.get(\"TRAIN_DATA_ROOT\", DATA_ROOT / \"demo_data_language\"))\n",
"PRETRAINED_POLICY = Path(os.environ.get(\"SMOLVLA_POLICY_PATH\", MODEL_ROOT / \"smolvla_weighted_000500\" / \"pretrained_model\"))\n",
"\n",
"rows = [\n",
" (\"DATASET_REPO_ID\", DATASET_REPO_ID),\n",
" (\"TRAIN_DATA_ROOT\", TRAIN_DATA_ROOT),\n",
" (\"SMOLVLA_POLICY_PATH\", PRETRAINED_POLICY),\n",
" (\"数据 meta\", TRAIN_DATA_ROOT / \"meta\" / \"info.json\"),\n",
"]\n",
"md_table([\"变量\", \"当前值\"], rows)\n"
]
},
{
"cell_type": "markdown",
"metadata": {},
"source": "## Checkpoint 4:生成配置并真实启动 smoke / 长训\n\n 预计耗时:smoke 约 1-5 分钟;`SMOLVLA_STEPS=5000` 的长训通常需要几十分钟到数小时,取决于 ROCm、batch size 和数据盘速度。 \n 这一格是真实训练入口:设置 `RUN_SMOKE=1` 或 `RUN_LONG_TRAIN=1` 后执行,会在 Notebook kernel 内直接创建 dataset、policy、optimizer 和训练循环,并显示 tqdm 进度。\n"
},
{
"cell_type": "code",
"execution_count": null,
"metadata": {},
"outputs": [],
"source": [
"CONFIG_DIR = OUTPUT_ROOT / \"configs\"\n",
"LOG_DIR = OUTPUT_ROOT / \"logs\"\n",
"RUN_ROOT = OUTPUT_ROOT / \"runs\" / \"smolvla_weighted_repro\"\n",
"SMOKE_OUTPUT = RUN_ROOT / \"smoke\"\n",
"LONG_OUTPUT = RUN_ROOT / \"weighted_full\"\n",
"\n",
"smoke_config = make_lerobot_train_config(\n",
" \"smolvla\", DATASET_REPO_ID, TRAIN_DATA_ROOT, SMOKE_OUTPUT,\n",
" steps=2, batch_size=2, chunk_size=50, n_action_steps=50,\n",
")\n",
"long_config = make_lerobot_train_config(\n",
" \"smolvla\", DATASET_REPO_ID, TRAIN_DATA_ROOT, LONG_OUTPUT,\n",
" steps=int(os.environ.get(\"SMOLVLA_STEPS\", \"5000\")),\n",
" batch_size=int(os.environ.get(\"SMOLVLA_BATCH_SIZE\", \"4\")),\n",
" chunk_size=50,\n",
" n_action_steps=50,\n",
")\n",
"smoke_config_path = write_json_yaml(CONFIG_DIR / \"smolvla_smoke.yaml\", smoke_config)\n",
"long_config_path = write_json_yaml(CONFIG_DIR / \"smolvla_weighted_full.yaml\", long_config)\n",
"\n",
"train_lerobot_config_in_notebook(smoke_config_path, enabled=RUN_SMOKE, progress_name=\"SmolVLA smoke\")\n",
"train_lerobot_config_in_notebook(long_config_path, enabled=RUN_LONG_TRAIN, progress_name=\"SmolVLA long train\")\n"
]
},
{
"cell_type": "markdown",
"metadata": {},
"source": "## Checkpoint 5:实时查看训练日志和 checkpoint\n\n 预计耗时:几秒。长训进行中可以反复执行本格,查看 Notebook 训练写出的 metrics 和已经落盘的 checkpoint。\n"
},
{
"cell_type": "code",
"execution_count": 9,
"metadata": {},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": "smoke metrics:\n日志不存在: $OUTPUT_ROOT/runs/smolvla_weighted_repro/smoke/notebook_train_metrics.jsonl\n\nlong train metrics:\n日志不存在: $OUTPUT_ROOT/runs/smolvla_weighted_repro/weighted_full/notebook_train_metrics.jsonl\n\ncheckpoints:\n尚未发现 checkpoint: $OUTPUT_ROOT/runs/smolvla_weighted_repro/weighted_full\n"
}
],
"source": [
"print(\"smoke metrics:\")\n",
"tail_log(SMOKE_OUTPUT / \"notebook_train_metrics.jsonl\", lines=20)\n",
"print(\"\\nlong train metrics:\")\n",
"tail_log(LONG_OUTPUT / \"notebook_train_metrics.jsonl\", lines=40)\n",
"print(\"\\ncheckpoints:\")\n",
"list_checkpoints(LONG_OUTPUT)\n"
]
},
{
"cell_type": "markdown",
"metadata": {},
"source": "## Checkpoint 6:已完成长训的实测对照\n\n 这是我们已经在 AMD 设备上跑完并复核过的视频/指标对照,用来帮助学习者先看到“正确跑起来是什么样”。它不替代本次 Notebook 的训练输出。\n"
},
{
"cell_type": "markdown",
"metadata": {},
"source": [
"## 结果对照\n",
"\n",
"| 阶段 | 训练/评估进度 | 结论 |\n",
"| --- | --- | --- |\n",
"| parent | 5000/5000 steps | 基础 SmolVLA 收敛到可用 checkpoint |\n",
"| weighted-blue | selected step 500/1000 | step500 比 step1000 更平衡 |\n",
"| strict gate | 57/60 | legacy 60/60,physical 57/60 |\n"
]
},
{
"cell_type": "code",
"execution_count": 11,
"metadata": {},
"outputs": [
{
"output_type": "display_data",
"data": {
"text/markdown": "**历史训练进度与闭环结果**"
},
"metadata": {}
},
{
"output_type": "display_data",
"data": {
"text/html": "
 "
},
"metadata": {}
},
{
"output_type": "display_data",
"data": {
"text/markdown": "**红杯/蓝杯分指令对比**"
},
"metadata": {}
},
{
"output_type": "display_data",
"data": {
"text/html": "
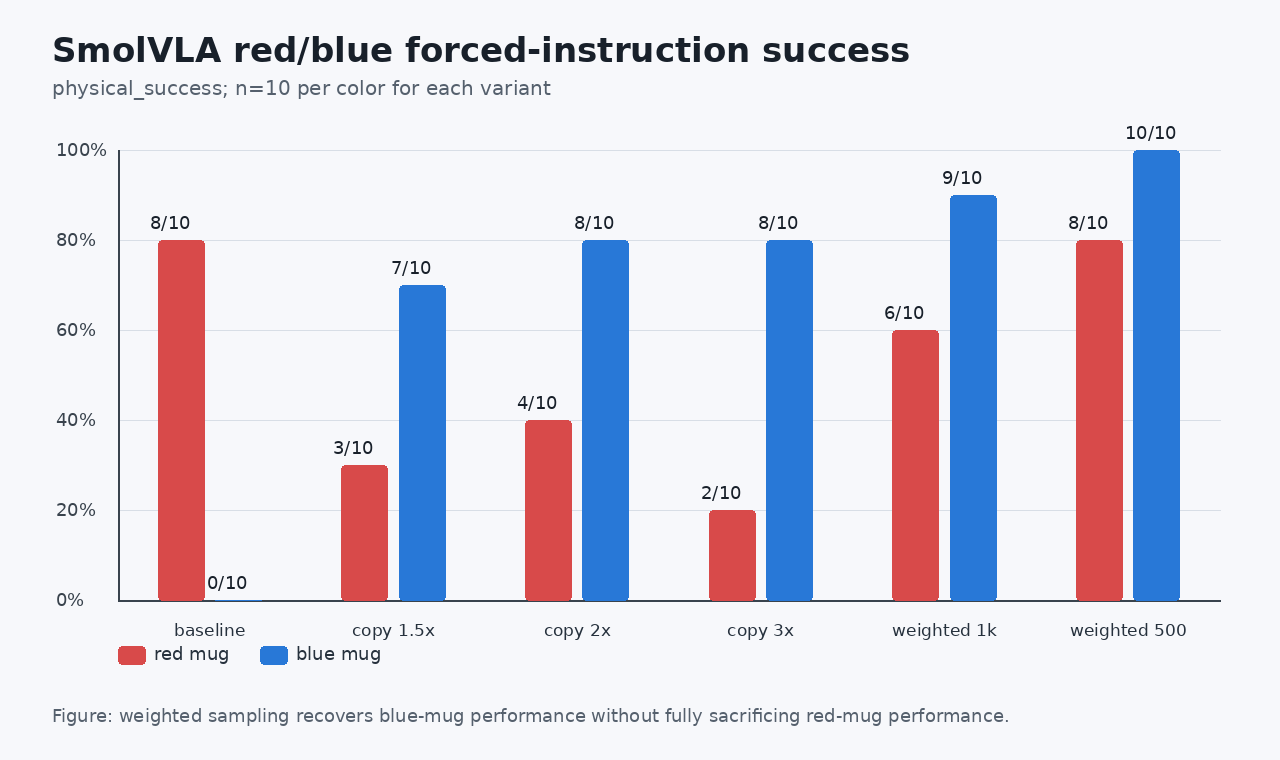 "
},
"metadata": {}
}
],
"source": [
"show_image(\"training_progress_overview.png\", \"历史训练进度与闭环结果\")\n",
"show_image(\"smolvla_red_blue_success.png\", \"红杯/蓝杯分指令对比\")\n"
]
},
{
"cell_type": "markdown",
"metadata": {},
"source": "## Checkpoint 7:Notebook 内严格评估\n\n 预计耗时:10 个 episode 通常 10-30 分钟;`SMOLVLA_EVAL_EPISODES=60` 会更久。 \n 本单元会在 Notebook kernel 内加载策略并逐个 seed 闭环 rollout;如无显示器,会自动尝试启动 Xvfb。\n"
},
{
"cell_type": "code",
"execution_count": 12,
"metadata": {},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": "评估使用环境变量指定权重: $OUTPUT_ROOT/runs/smolvla_protected_recipe/weighted_blue2_step1000/checkpoints/001000/pretrained_model\npolicy = smolvla\npolicy_path = $OUTPUT_ROOT/runs/smolvla_protected_recipe/weighted_blue2_step1000/checkpoints/001000/pretrained_model\nresult = $OUTPUT_ROOT/smolvla_eval_seed0_59.jsonl\n没有发现 Xvfb;如遇 GLFW DISPLAY 报错,请先安装 xvfb。\n"
},
{
"ename": "FileNotFoundError",
"evalue": "评估脚本不存在:$PROJECT_ROOT/eval_policy_success.py",
"output_type": "error",
"traceback": [
"Traceback (most recent call last):",
" File \"/workspace/every-embodied-amd-topic/code/execute_tutorial_notebooks.py\", line 175, in execute_notebook",
" exec(compile(source, f\"{path.name}:cell-{cell_index}\", \"exec\"), namespace)",
" File \"14_smolvla_end_to_end.ipynb:cell-22\", line 3, in ",
" File \"14_smolvla_end_to_end.ipynb:cell-2\", line 468, in run_eval_policy_in_notebook",
" File \"14_smolvla_end_to_end.ipynb:cell-2\", line 426, in load_eval_module",
"FileNotFoundError: 评估脚本不存在:$PROJECT_ROOT/eval_policy_success.py"
]
}
],
"source": [
"eval_episodes = os.environ.get(\"SMOLVLA_EVAL_EPISODES\", \"10\")\n",
"eval_policy = resolve_eval_policy(PRETRAINED_POLICY, LONG_OUTPUT, \"SMOLVLA_EVAL_POLICY_PATH\")\n",
"run_eval_policy_in_notebook(\n",
" \"smolvla\",\n",
" eval_policy,\n",
" OUTPUT_ROOT / f\"smolvla_eval_seed0_{int(eval_episodes)-1}.jsonl\",\n",
" episodes=eval_episodes,\n",
" seed_start=0,\n",
" render=env_flag(\"RENDER_EVAL\"),\n",
" enabled=RUN_EVAL,\n",
" repo_id=DATASET_REPO_ID,\n",
" dataset_root=TRAIN_DATA_ROOT,\n",
")\n",
"summarize_jsonl(OUTPUT_ROOT / f\"smolvla_eval_seed0_{int(eval_episodes)-1}.jsonl\")\n"
]
},
{
"cell_type": "markdown",
"metadata": {},
"source": "## Checkpoint 8:怎么读结果\n"
},
{
"cell_type": "code",
"execution_count": 13,
"metadata": {},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": "{\n \"candidate\": \"weighted_000500\",\n \"episodes\": 60,\n \"physical_success_count\": 57,\n \"legacy_success_count\": 60,\n \"by_color\": {\n \"red\": \"27/30\",\n \"blue\": \"30/30\"\n },\n \"release_decision\": \"作为教程默认预训练权重\"\n}\n"
}
],
"source": [
"summary = {\n",
" \"candidate\": \"weighted_000500\",\n",
" \"episodes\": 60,\n",
" \"physical_success_count\": 57,\n",
" \"legacy_success_count\": 60,\n",
" \"by_color\": {\"red\": \"27/30\", \"blue\": \"30/30\"},\n",
" \"release_decision\": \"作为教程默认预训练权重\",\n",
"}\n",
"print(json.dumps(summary, ensure_ascii=False, indent=2))\n"
]
}
],
"metadata": {
"kernelspec": {
"display_name": "Python 3 (ipykernel)",
"language": "python",
"name": "python3"
},
"language_info": {
"codemirror_mode": {
"name": "ipython",
"version": 3
},
"file_extension": ".py",
"mimetype": "text/x-python",
"name": "python",
"nbconvert_exporter": "python",
"pygments_lexer": "ipython3"
},
"amd_rocm_tutorial_execution": {
"executor": "code/execute_tutorial_notebooks.py",
"python": "3.12.3",
"code_cells_executed": 13,
"errors": 1,
"record_markers": [],
"prepare_markers": [],
"long_tasks_enabled": false
}
},
"nbformat": 4,
"nbformat_minor": 5
}