
Robots That Know What to Ask:机器人主动提问修正奖励错位
论文:Robots That Know What to Ask: Recovering Misaligned Rewards through Targeted Explanations 会议:Robotics: Science and Systems, RSS 2026 arXiv:https://arxiv.org/abs/2605.22986 RSS 页面:https://roboticsconference.org/program/papers/116/ 代码状态:截至 2026-07-18,未检索到作者公开的官方项目页或代码仓库;本教程以论文、arXiv HTML 图和 RSS 信息为主要来源。
这篇文章适合放在“具身场景的深度和强化学习”里,而不是放进世界模型或 VLA 基座章节。它研究的不是“机器人如何在世界模型里预演未来”,也不是“换一个更强的视觉语言动作模型”。它研究的是一个更基础、更容易被忽视的问题:人类给机器人的示教并不一定把真实任务目标表达完整,机器人从这些不完整示教里学到的 reward function 可能会错位;那么机器人能不能自己判断“我到底缺哪一类信息”,然后有针对性地向人类要补充示教。
一句话概括:它提出 ASQ(Ambiguity-Sensitive Querying),用示教中特征分布的方差信号找出“欠指定特征”,再通过自然语言解释告诉人类“我不确定这个维度”,让人类补充更有针对性的 corrective demonstrations,从而修正逆强化学习里的奖励错位。
为什么需要这篇
很多机器人学习方法默认一件事:人类示教虽然可能不完美,但至少已经覆盖了任务中重要的目标维度。比如机器人要移动一个杯子,人类的真实偏好可能是:
- 杯子要保持直立;
- 杯子要靠近桌子;
- 杯子不能撞到笔记本电脑;
- 杯子不能靠近人。
问题是,人类在示教时不一定每次都能同时照顾所有目标。有些目标可能因为认知负担被忽略,有些目标可能因为机械臂运动限制很难被体现,有些目标可能只是训练场景没有覆盖到。结果就是:示教看起来够多,但某个关键特征其实没有被讲清楚。
这会造成 reward ambiguity。机器人用 MaxEnt IRL 或类似方法从示教里反推出 reward 权重时,可能以为某个特征不重要,部署时就做出“人类不想要但训练数据没说清”的动作。文章的核心动机就是处理这种“示教欠指定导致的奖励错位”。
方法总览
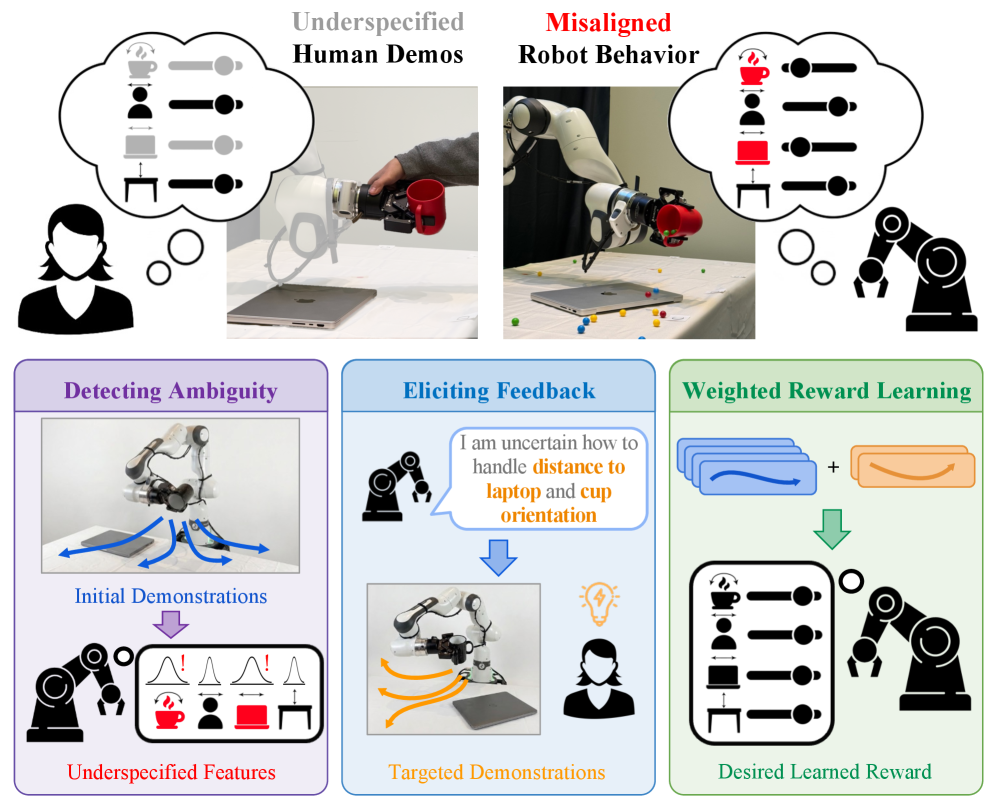
图源:arXiv HTML,Figure 1,Robots That Know What to Ask。
这张图是全文最重要的入口。左边表示常规从示教学 reward 的流程:人类给一批 demonstrations,机器人用这些轨迹学习奖励函数,然后用学到的奖励规划动作。问题出在中间:如果某些 task-relevant features 在示教中没有被充分体现,机器人学到的 reward 就会偏。
右边是 ASQ 的核心思路:
- 先看已有示教里每个特征的取值分布。
- 如果某个特征被人类稳定优化,它在示教里的变化通常比较小。
- 如果某个特征没有被稳定表达,它在示教里的变化会更大。
- 机器人把高方差、疑似欠指定的特征挑出来。
- 机器人用自然语言解释自己不确定的特征。
- 人类围绕这个被点名的特征补充示教。
- 奖励学习器把这批补充示教作为 targeted corrective demonstrations,用更合适的权重更新 reward。
可以把它理解成一种“奖励学习里的主动问诊”。机器人不是泛泛地说“请再演示几次”,而是说“我不确定你是否希望我远离 laptop,请你针对这个点再演示几次”。
mermaidflowchart LR
    A["初始示教 D_init"] --> B["提取每条轨迹的特征值"]
    B --> C["估计每个特征的示教方差"]
    C --> D["识别高方差的欠指定特征"]
    D --> E["生成自然语言解释"]
    E --> F["请求针对该特征的补充示教"]
    F --> G["给补充示教设置 demo-specific rationality / weighting"]
    G --> H["MaxEnt IRL 更新 reward function"]
    H --> I["用新 reward 规划和评估策略"]
核心创新拆解
1. 把“示教不完整”显式建模
以往很多 inverse reinforcement learning 或 learning from demonstration 方法会把示教视作任务偏好的直接证据。只要人类演示了某条轨迹,算法就会倾向于认为这条轨迹在所有特征上都体现了人类偏好。
这篇文章指出这个假设太强。人类示教可能只在部分特征上是“理性”的。例如示教者这次主要注意杯子别倒,但没有注意离 laptop 远一点。此时如果算法把这条示教当成“所有特征都被同等关注”的证据,就会把 reward 学歪。
所以 ASQ 的第一步不是马上多收数据,而是判断:已有数据到底缺哪一维监督。
2. 用特征方差找欠指定维度
文章的关键观察很简单,但很有用:
- 被稳定优化的特征,在示教轨迹中通常比较一致;
- 没被稳定优化的特征,在示教轨迹中会出现更大变化。
举例来说,如果人类一直很在意“杯子直立”,所有示教里的杯子倾角都会比较小,方差也小。反过来,如果人类示教时没有注意“远离 laptop”,不同示教轨迹距离 laptop 的程度就可能差异很大。ASQ 正是利用这种统计信号来判断“哪个特征可能没被讲清楚”。
这个设计的好处是它不需要机器人先执行大量失败 rollout,也不需要人类先写一套完整 reward。它利用的是已经收集到的 demonstrations。
3. 不是只问“再演示一次”,而是解释“我缺什么”
ASQ 的提问不是随机收集更多示教,而是 targeted explanations。机器人会把自己识别出的欠指定特征用自然语言告诉人类,然后让人类围绕这个特征给补充示教。
这个点很重要。单纯给人看一个失败 rollout,让人猜机器人哪里错了,效果不一定好。人类可能看到了机器人行为,但不一定能反推出 reward learner 到底缺哪个特征。文章真实用户实验里也观察到,Rollout 条件下参与者经常误判欠指定特征;Explanation 条件下,参与者更容易把注意力放到被点名的特征上。
4. demo-specific rationality / weighting
文章还强调:补充示教和初始示教不应该被完全同等看待。
如果人类是在“请你重点展示远离 laptop”这个提示下给出的示教,那么这批示教对 laptop distance 这个特征的监督更强;但它不一定同样强地监督所有其他特征。于是 reward learning 时需要 demo-specific rationality 或 weighting,把“这条示教主要针对哪个特征”这件事编码进去。
这也是为什么 Explanation 条件有额外价值:只有当机器人明确告诉人类要关注哪个特征时,算法才有理由相信这批补充示教确实是 targeted 的。如果是 Unguided 或只给 Rollout,人类可能关注任意一个目标维度,算法无法可靠地给某个特征加权。
5. 多特征场景里的 LLM 过滤
在 8-feature 实验里,任务相关特征和无关干扰物会同时存在。如果直接用方差找高变化特征,算法可能把无关干扰物也当成需要询问的对象。文章因此引入 LLM filtering:先用语言模型根据任务语义过滤掉明显无关的特征,再在剩余候选里做方差检测。
这不是把 LLM 当成最终 reward model,而是把 LLM 当成一个语义筛选器。它的角色更像“先从一堆环境对象里删掉明显不相关的项”,再交给统计检测处理。
实验环境
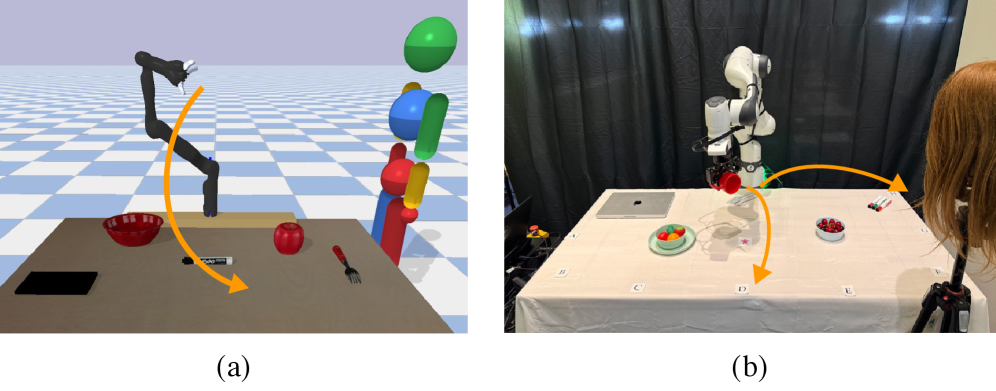
图源:arXiv HTML,Figure 2,Robots That Know What to Ask。
论文主要用了两类实验环境:
- JacoRobot 仿真桌面操作环境:7 自由度 Jaco 机械臂在有障碍物的桌面上移动咖啡杯。这个环境用于系统比较 ASQ、随机查询和 Oracle 等方法在 reward recovery 上的差异。
- 真实 Franka 机械臂用户实验:真实桌面任务里让参与者给 corrective demonstrations,比较不同反馈方式对奖励修正效果的影响。
附录还给了一个 GridRobot 导航环境,用来展示更简化的二维导航奖励恢复过程。
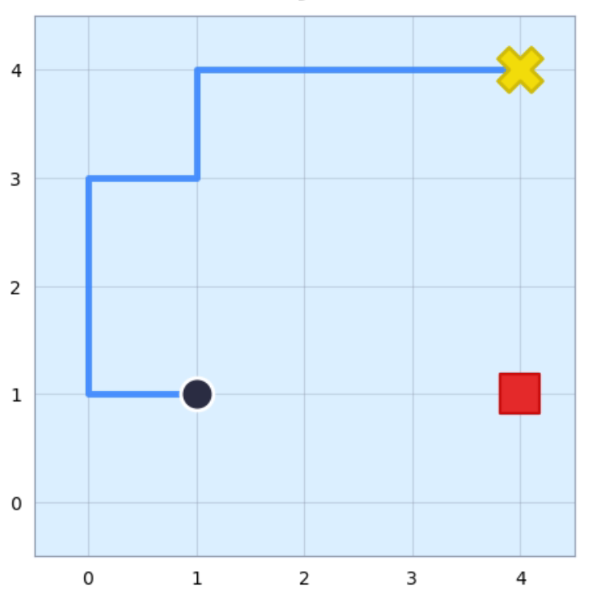
图源:arXiv HTML,Figure 7,Robots That Know What to Ask。
GridRobot 更像一个教学环境:状态、动作和特征都容易控制,适合复现 ASQ 的基本思想。真想自己做一个最小复现,可以先从 GridWorld / GridRobot 风格环境做起,而不是直接上真实机械臂。
仿真实验怎么看
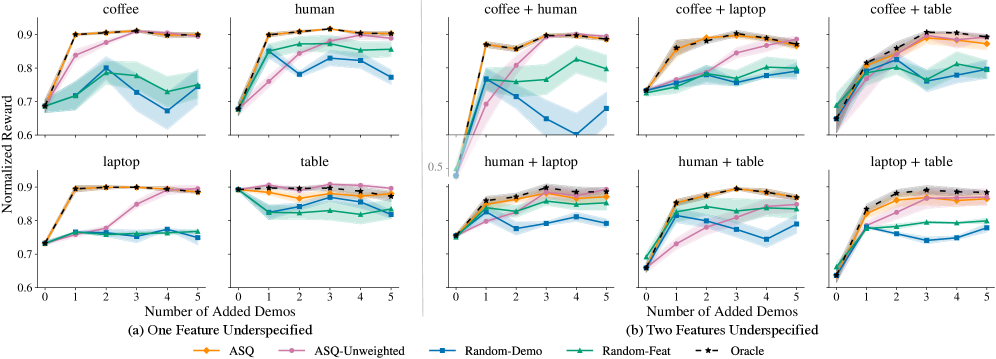
图源:arXiv HTML,Figure 3,Robots That Know What to Ask。
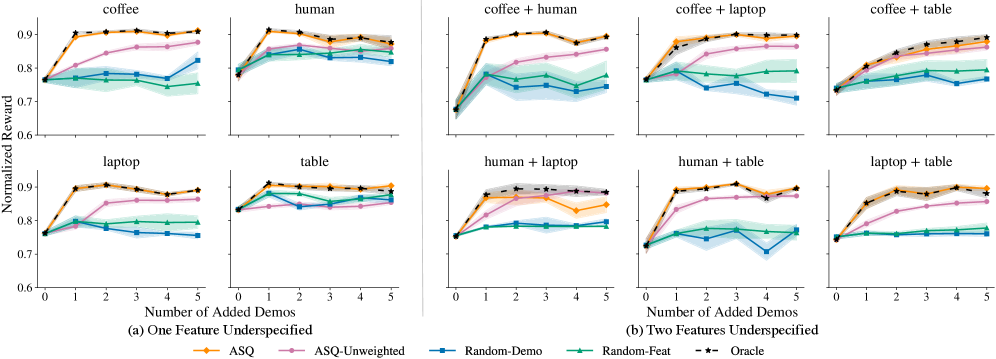
Figure 3 比较的是 JacoRobot 中一个或两个欠指定特征的情况。纵轴是 normalized reward,越高表示学到的 reward 越接近真实目标;横轴是额外收集的 corrective demonstrations 数量。
图里的核心结论是:
- ASQ 明显优于随机查询和被动加数据;
- ASQ 能更快接近 Oracle;
- 欠指定特征越多,随机收数据越低效,因为随机示教不一定刚好覆盖缺失维度;
- targeted explanation-guided demonstrations 的样本效率更高。
这里的 Oracle 可以理解为知道真正缺哪个特征的理想查询器。ASQ 的意义就是在不知道真实缺口的情况下,用示教方差信号尽量接近 Oracle。
图源:arXiv HTML,Figure 4,Robots That Know What to Ask。
Figure 4 更接近真实问题:环境里不只有任务相关特征,还有干扰物。比如桌上有很多对象,但并不是每个对象都属于 reward 的目标维度。论文在 8-feature setting 里放入 4 个任务相关特征和 4 个无关 distractor objects。
这个实验要说明两点:
- 只看方差并不够,干扰物也可能产生高方差。
- 结合 LLM filtering 后,ASQ 能先排除语义上不相关的候选,再定位真正欠指定的任务特征。
这对大模型时代的机器人系统很实用。现实桌面任务里特征空间通常不是干净的,机器人看到的对象远多于任务目标。先用语言/语义过滤,再用轨迹统计做主动查询,是一个比较稳的组合。
真实用户实验怎么看
图源:arXiv HTML,Figure 5,Robots That Know What to Ask。
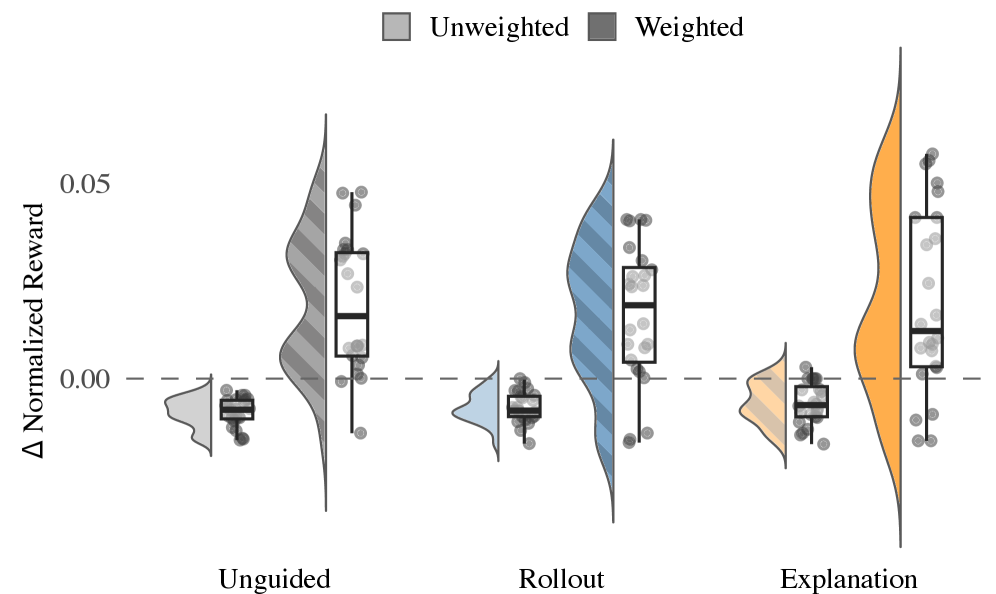
真实用户实验里,论文比较三种条件:
- Unguided:不提供额外反馈,只让人补充示教。
- Rollout:给人看机器人当前学到 reward 后的行为 rollout,让人自己判断哪里不对。
- Explanation:直接告诉人“机器人不确定哪个特征”,让人围绕这个特征补充示教。
任务目标包括让杯子保持直立、靠近桌面、远离 laptop、远离人。论文招募了 12 位参与者,采用 within-subjects 设计,并用 normalized reward recovery 衡量奖励修正效果。
Figure 5 的重点是:只有 Explanation 条件在平均意义上带来了正向 reward improvement。Rollout 并没有显著好于 Unguided。直觉上这说明,给人看失败行为并不等于给人解释模型缺什么;人类可能看到了动作不好,但猜不准 reward learner 的具体歧义在哪里。
图源:arXiv HTML,Figure 6,Robots That Know What to Ask。
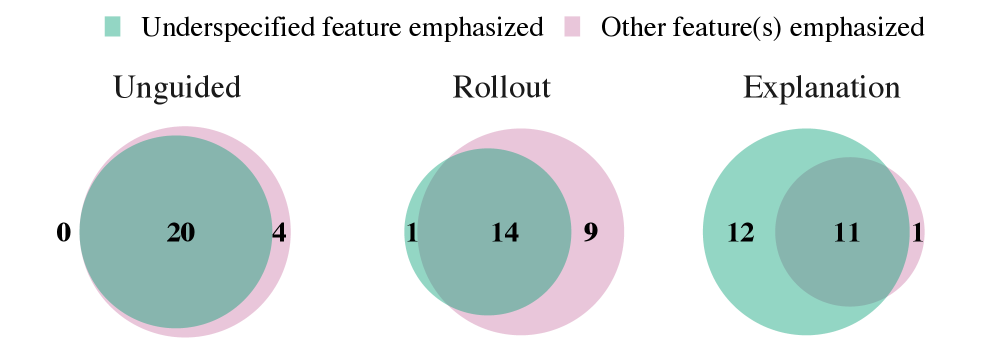
Figure 6 进一步看参与者自己报告他们示教时关注了什么。Explanation 条件下,参与者更常报告自己强调了机器人点名的欠指定特征;Rollout 条件下,参与者更容易关注其他特征或同时关注多个特征。
这解释了为什么 Explanation + weighting 更有效:它不只是让人多给数据,而是把人的注意力和算法的 reward uncertainty 对齐了。
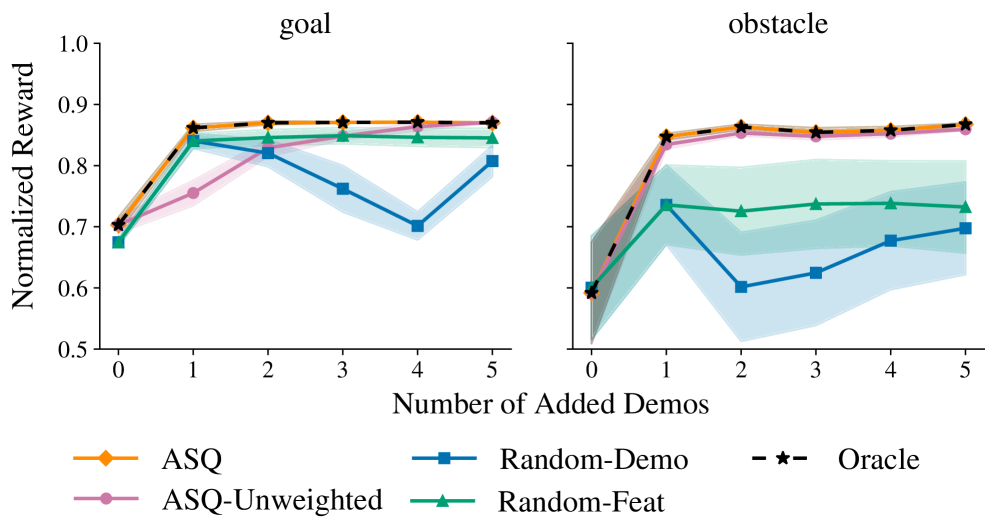
附录 GridRobot 结果
图源:arXiv HTML,Figure 8,Robots That Know What to Ask。
GridRobot 结果可以作为教学复现的参考。它不需要真实机械臂,也不需要复杂视觉感知,只需要:
- 一个小型离散环境;
- 若干手工定义特征,例如到目标距离、是否接近障碍、是否经过危险区域;
- 一批故意欠指定的 demonstrations;
- 一个 MaxEnt IRL 或简化 reward fitting 实现;
- 一个主动查询策略,按特征方差挑出要补充示教的特征。
如果后面要做“轻量复现版”,建议先从这个方向做,而不是直接复刻 JacoRobot 或 Franka 用户实验。
它到底牛在哪里
这篇文章不是靠大模型规模取胜,也不是靠机器人硬件堆结果。它的亮点在于把一个长期存在但不够显式的问题拆清楚了:示教数据少并不是唯一问题,示教数据“偏”和“欠指定”同样会让 reward 学歪。
它的贡献可以概括成三点:
- 问题定义清楚:不是泛泛说“人类示教不完美”,而是具体指出 task-relevant features 可能 underspecified。
- 查询准则简单有效:用示教中特征方差判断哪些目标维度没被稳定表达。
- 人机交互闭环合理:机器人先解释不确定性,再请求 targeted demonstrations,最后用特征级 weighting 更新 reward。
这对具身智能教程很有价值,因为它能帮助大家把“从人类数据学机器人目标”这件事看得更细。很多 VLA、RL、world model 后训练工作都需要 reward 或 preference 信号;如果这些信号本身欠指定,再强的后训练也可能沿着错误目标优化。
它没有解决什么
也要看清边界:
- 它依赖显式特征空间。机器人必须能把轨迹映射到一组可解释 features 上,才能计算哪个特征方差高。端到端像素级 VLA 里如果没有对象、距离、姿态、接触等中间特征,这套方法不能直接套。
- 它不是通用问答智能体。机器人不是自由地问任何问题,而是在预定义特征集合里判断哪个维度欠指定。
- 它不是世界模型。它不生成未来视频,不提供
step(action)仿真接口,也不在 imagined rollout 里训练策略。 - 它不是一键可复现项目。截至整理时没有检索到官方代码仓库,真实用户实验也需要机器人平台和受试者流程,复现成本不低。
- 它主要验证 reward recovery,不是大规模通用操作成功率榜单。实验说明 targeted explanations 能改善奖励学习,但不等于已经解决开放世界机器人对齐。
和 VLA / 世界模型工作的关系
这篇可以和最近的几个方向形成互补:
- 和 Agentic-VLA:Agentic-VLA 关注 VLA 在线适应外环,核心是自动合成 reward、探索和经验记忆;ASQ 关注人类示教导致的 reward 欠指定,能作为 human-in-the-loop reward repair 模块。
- 和 RAW-Dream / GE-Sim 2.0:世界模型可以在想象中生成 rollout,但 imagined RL 仍然需要 reward。ASQ 提醒我们:如果 reward 或 VLM judge 对某些特征不敏感,世界模型里优化也会放大错位。
- 和 VisualThink-VLA:VisualThink-VLA 让 VLA 用视觉证据思考再行动;ASQ 则可以把“哪些视觉/空间特征是任务目标”通过人类解释和示教校准得更清楚。
- 和传统 IRL / preference learning:ASQ 更像是把主动学习、人类解释和 MaxEnt IRL 接在一起,适合放在奖励学习与机器人强化学习课程中。
如果想复现,应该从哪里开始
目前不建议把它作为组队学习的强制复现任务,但可以做一个轻量概念复现:
- 搭一个二维 GridWorld 或简化 tabletop 环境。
- 定义 3 到 5 个 feature,例如目标距离、障碍距离、是否靠近某个对象、路径长度。
- 人工生成 demonstrations,其中故意让某个 feature 没被稳定优化。
- 用 MaxEnt IRL 或线性 reward fitting 学一个 reward。
- 计算每个 feature 在 demonstrations 中的方差,挑出高方差候选。
- 生成自然语言提示,例如“我不确定是否应该远离障碍物,请给我一些强调远离障碍物的示教”。
- 加入 targeted demonstrations,再对比 reward recovery 是否提升。
如果要往真实机器人靠近,需要额外补齐:
- 轨迹特征提取器,例如物体距离、杯子姿态、末端执行器路径、碰撞/接触事件;
- 规划器或轨迹优化器,用学到的 reward 生成行为;
- 人类示教接口,例如 kinesthetic teaching、遥操作、VR/手柄控制;
- 受试者实验协议,包括条件随机化、NASA-TLX 或主观偏好问卷;
- reward recovery 的 ground truth 或代理评估指标。
适合放进组队学习的题目
可以把它作为 Task04 操作控制方向的进阶复盘题。推荐问题:
- 为什么“多收示教”不一定能修正 reward?
- ASQ 如何判断哪个特征欠指定?
- Rollout feedback 为什么可能不如 feature-based explanation?
- demo-specific rationality / weighting 在 reward learning 中起什么作用?
- 如果把 ASQ 接到 VLA 或世界模型后训练里,应该接在哪一层?
一个比较好的作业不是复现真实机械臂,而是画出“示教 -> 特征方差 -> 欠指定检测 -> 解释提问 -> 补充示教 -> reward 更新”的流程图,并用一个小例子说明 reward 错位如何发生。
推荐阅读顺序
- 先读论文 Figure 1,理解 ASQ 在修正什么问题。
- 再读 Figure 3 和 Figure 4,看仿真里为什么 targeted query 比随机 query 有效。
- 然后读 Figure 5 和 Figure 6,看真实用户实验里 Explanation 为什么有意义。
- 最后读附录 GridRobot,把它作为最小复现参考。
参考链接
- arXiv 摘要页:https://arxiv.org/abs/2605.22986
- arXiv HTML:https://arxiv.org/html/2605.22986v1
- RSS 2026 论文页:https://roboticsconference.org/program/papers/116/
- Nick Walker publications:https://nickwalker.us/publications/