
NBS 主动感知:用节点级 Beam Search 做移动机器人信息路径规划
本文导读论文 An Efficient Beam Search Algorithm for Active Perception in Mobile Robotics。这篇工作已经在 The International Journal of Robotics Research OnlineFirst 发布,对应 arXiv 版本为
2604.23327。它不是 VLA,也不是世界模型,而是更偏导航规划、主动感知、信息路径规划的一篇系统方法论文。
1. 一句话结论
这篇论文解决的问题是:机器人不知道完整环境时,应该往哪里走、朝哪里看,才能在有限时间或能量预算内获得最多有用信息。
传统导航常问“怎么从 A 点最快到 B 点”。主动感知问的是另一件事:B 点可能还不知道,地图也不完整,机器人要一边探索、一边建图、一边决定下一段最值得走的感知轨迹。
论文的核心贡献可以压成三个模块:
| 模块 | 解决什么问题 | 关键思想 |
|---|---|---|
| Node-wise Beam Search,NBS | 在图上找高信息量路径,不想用昂贵 TSP,也不想被最短路径树限制 | 不是每一层只留全局 top-B,而是每个终止节点各自保留 top-B 条候选路径 |
| Expected Gain | 已知高收益点和未知区域边界之间怎么平衡 | 把 frontier 未来可能带来的收益加入路径评分,避免只贪心已知 gain |
| RRAG | 真实主动感知不是给定静态图,需要在线构图 | 用 Rapidly-exploring Random Annulus Graph 增量采样可通行视点,并保留多朝向 |
从教程位置上看,它最适合放在 08-具身导航及VLN/03前沿VLN复现 下面。虽然这个目录名字里有 VLN,但这篇不是语言导航,而是更基础的 主动感知路径规划:它可以被 VLN、无人机探索、移动机器人建图、场景扫描等任务复用。
2. 论文与项目入口
| 条目 | 链接 | 当前状态 |
|---|---|---|
| IJRR 论文页 | SAGE: An efficient beam search algorithm for active perception in mobile robotics | 已 OnlineFirst |
| arXiv | arXiv:2604.23327 / HTML 版本 | 可直接读全文和取图 |
| 项目页 | efficient-beam-search.github.io | 论文项目主页 |
| OpenApero | openapero.github.io | 主动感知库主页,标注 Summer 2026 release |
| GitHub | OpenApero/openapero | 当前是 placeholder,代码、文档、示例尚未公开 |
截至 2026-07-18,OpenApero 仓库 README 明确写着 The code is not public yet,release target 是 Summer 2026。所以这篇教程暂时定位为“方法导读 + 复现路径说明”,不是手把手运行教程。
3. 它到底在做什么
主动感知可以理解成下面这个闭环:
mermaidflowchart LR
  A["传感器观测<br/>RGB-D / depth / map update"] --> B["更新局部地图<br/>free / occupied / unknown"]
  B --> C["更新候选视点图<br/>RRAG"]
  C --> D["计算节点收益<br/>gain / frontier / expected gain"]
  D --> E["NBS 规划高信息路径"]
  E --> F["机器人执行下一小段"]
  F --> A
这个闭环里,论文最关心的是中间两步:
- 怎么建图上的候选视点:机器人能站在哪里、朝哪里看、哪些视点之间能连通。
- 怎么在图上选路径:有限预算下,走哪串节点能获得最大信息。
它不是学习一个视觉大模型,也不是训练一个可生成未来视频的 world model。它仍然是经典机器人规划味道很重的方法:有图、有边、有代价、有收益、有预算、有碰撞检测、有在线重规划。
4. 总览图怎么读
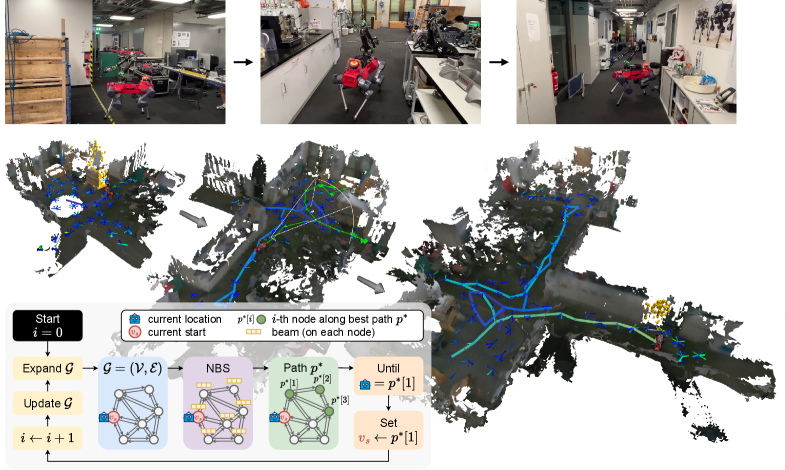
图 1 展示的是硬件实验中的 surface reconstruction。可以按四层来读:
- 机器人轨迹:图中已走过的轨迹用从深蓝到亮黄的颜色表示,表示时间推进;当前计划路径用浅绿色箭头表示。
- 相机视锥:机器人不是全知上帝视角,它只能看到相机视野内的区域,所以“朝向”会直接影响信息量。
- frontier:黄色体素表示 surface frontiers,也就是已知表面附近、但还没有被充分观测的未知区域。主动感知的关键就是去这些地方补洞。
- 规划闭环:左下角小图给出主循环:NBS 找当前最优路径,机器人走到下一个节点,更新图和新信息,再重新规划。
这张图非常适合作为教程里的第一张图,因为它把论文的核心直觉讲清楚了:机器人不是一次性规划完整路线,而是看一点、走一点、更新一点、再规划一点。
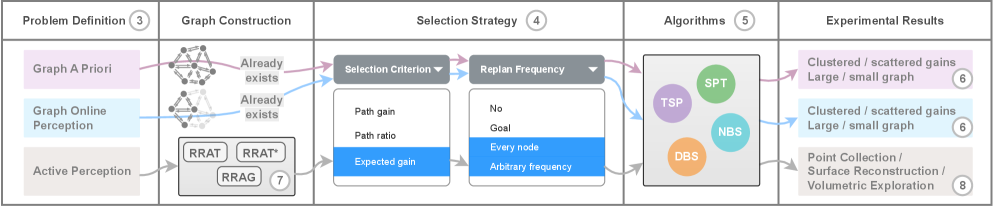
图 2 是论文结构图。它把问题从抽象到真实分成三层:
| 层级 | 场景 | 重点 |
|---|---|---|
| Graph a priori | 图和节点 gain 都已知 | 先验证不同图搜索算法本身谁更强 |
| Graph online perception | 图会逐步被观测到 | 验证重规划、frontier 和 expected gain 是否有效 |
| Active perception | 没有现成图,要从自由空间里在线构建 | 引入 RRAG,把图搜索落到真实机器人任务 |
这个组织方式很值得学习。论文没有一上来就在 Habitat 或真机里堆结果,而是先在抽象图上拆清楚“搜索算法”和“选择指标”的贡献,再把最好的组合迁移到真实主动感知任务。这样写作逻辑很干净:先证明规划器有效,再证明图构建能接上真实机器人。
5. 问题定义:不是最短路,而是信息路径规划
普通路径规划可以写成:
给定起点和终点,找一条代价最小的路径。
信息路径规划更像:
给定起点和预算,找一条路径,让机器人沿途获得的信息最多。
这里的几个变量很关键:
| 概念 | 含义 |
|---|---|
| node | 一个候选机器人状态,通常包含位置和朝向 |
| edge | 两个候选状态之间的可行运动连接 |
| cost | 走过这条边需要的距离、时间或能量 |
| gain | 到达某个视点后能获得多少新信息 |
| budget | 总运动预算,例如最大路径长度或最大执行时间 |
| path | 一串节点,要求总 cost 不超过 budget |
这类问题难在两点:
- 节点选择和路径排序耦合:不是先挑一堆好点再随便连起来,因为连线成本会改变最优选择。
- 收益不是简单相加:一个区域被看过以后,再去附近节点可能没有新收益;未知区域的潜在收益又很难直接计算。
论文把问题逐步扩展成三种形式:
| 形式 | 是否知道完整图 | 是否知道完整 gain | 典型意义 |
|---|---|---|---|
| Graph a priori | 知道 | 知道 | 纯测试路径搜索算法 |
| Graph online perception | 部分知道 | 随观测更新 | 测试重规划和 frontier |
| Active perception | 不知道,要在线构建 | 随感知和建图估计 | 接近真实机器人 |
6. 为什么 TSP 和 SPT 都不够好
论文主要对比两类经典思路。
TSP 思路:先采样或挑选一批高信息节点,再用旅行商问题求一条访问路线。
这个方法的问题是:
- 节点选择和路径排序被拆成两步,容易局部最优。
- TSP 求解本身会随节点数变大而很贵。
- 在在线探索中,环境和 frontier 一直变,反复解大 TSP 不够轻量。
SPT 思路:用 shortest path tree 限制搜索空间,只在最短路径树里选路径。
这个方法的问题是:
- 很快,但候选路径被压得太窄。
- 一个节点通常只保留一条最短到达路径,可能丢掉“绕一点但能看更多”的路径。
- 主动感知任务里,重复经过某些位置、选择不同朝向、绕路观察未知区域都可能是有价值的。
这篇论文的定位就在中间:比 TSP 更可扩展,比 SPT 更不受限制。
7. NBS:节点级 Beam Search
普通 beam search 在序列任务里常见:每一层只保留全局 top-B 条候选序列。论文把这个叫 depth-wise beam search,DBS。
DBS 的问题是它容易把 beam 全部集中在同一片高分区域。比如第 1 步发现右边有几个高 gain 节点,所有 beam 都往右边扩,左边虽然短期分数低、但长期可能通向更大的未知区域,就被提前剪掉了。
NBS 的改法很直接:
不按深度全局保留 top-B,而是对每个终止节点各自保留 top-B 条候选路径。
也就是说,NBS 维护的不是:
textdepth d: top-B paths globally
而是:
textnode v1: top-B paths ending at v1
node v2: top-B paths ending at v2
node v3: top-B paths ending at v3
...
简化伪代码如下:
textfrontier[start] = {empty path}

repeat search_depth times:
    next_frontier = {}

    for each end_node in frontier:
        for each path ending at end_node:
            for each neighbor of end_node:
                candidate = path + neighbor
                if candidate cost > budget:
                    continue
                insert candidate into next_frontier[neighbor]
                keep only top-B candidates for this neighbor

    frontier = merge(frontier, next_frontier)

return best path among all stored feasible candidates
这个设计的关键收益是 保留路径多样性。即使某个区域暂时不在全局 top-B,它只要在自己的终止节点上足够好,就不会被其他区域的高分路径挤掉。
可以这样理解:
| 搜索方式 | 保留什么 | 优点 | 风险 |
|---|---|---|---|
| Greedy | 当前一步最好的选择 | 很快 | 容易短视 |
| SPT | 到每个节点的最短路径 | 很快,结构简单 | 只能看最短树里的路径 |
| DBS | 每个深度全局 top-B 路径 | 比 greedy 多探索 | beam 可能挤在同一区域 |
| NBS | 每个节点 top-B 路径 | 多样性更好,低 beam width 也稳 | 比 DBS 保存更多状态 |
| TSP | 选点后求访问顺序 | 可利用成熟 TSP 求解器 | 两阶段、成本高、在线不轻 |
论文结果里一个很有意思的点是:NBS 在较低 beam width 下也能保持稳定表现。这对机器人很重要,因为真实机器人规划不能无限扩 beam,通常要在几百毫秒到几秒内给出下一段可执行路径。
8. 路径评分:Path Gain、Path Ratio、Expected Gain
NBS 只是搜索框架,还需要一个分数函数来判断哪条路径更值得保留。论文重点比较了三种选择指标。
| 指标 | 直觉 | 适合场景 | 主要问题 |
|---|---|---|---|
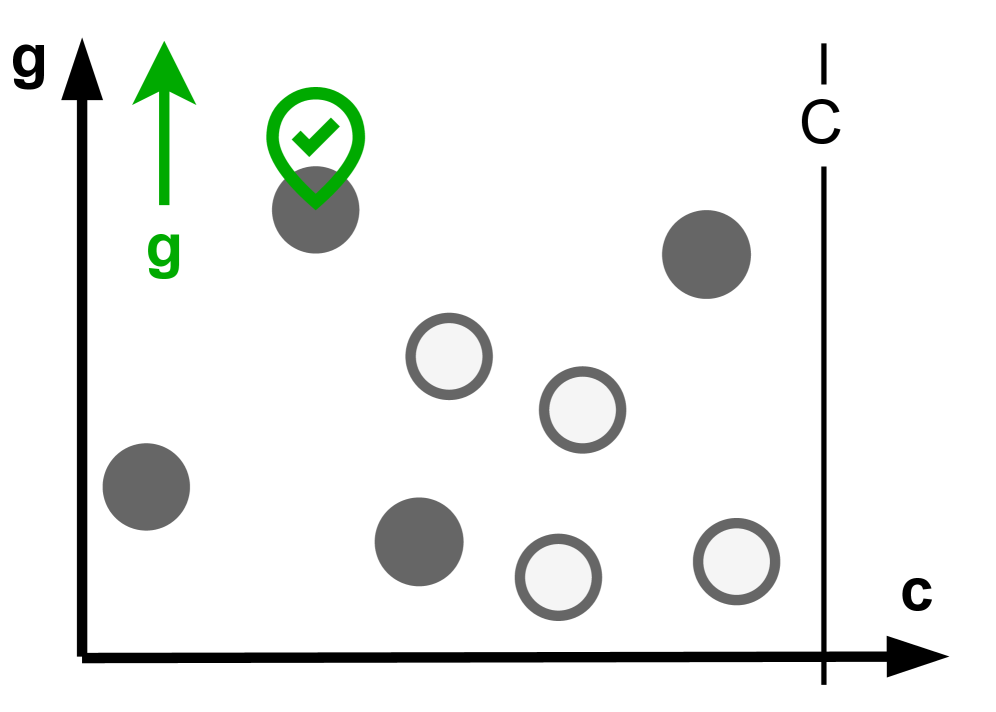
| Path Gain | 直接看这条路径能收集多少已知 gain | 已知信息分布比较准时 | 可能只贪心已知收益,不愿意去未知 frontier |
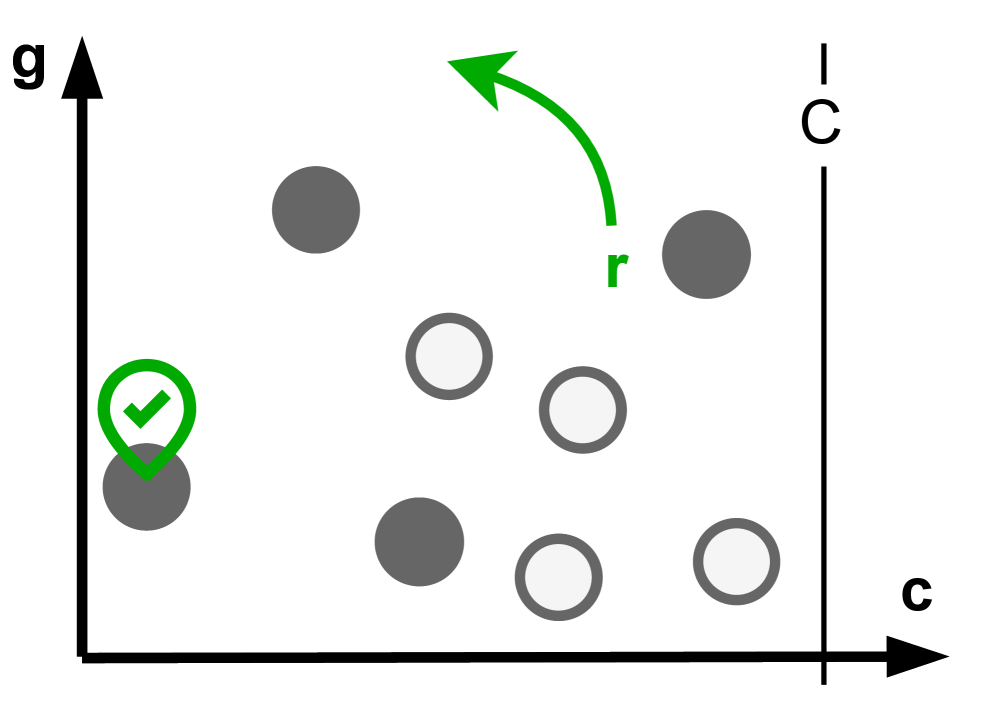
| Path Ratio | 用 gain / cost 衡量性价比 | 预算紧、短路径优先时 | 容易偏好近处小收益,长期探索不够 |
| Expected Gain | 已知 gain + frontier 估计未来 gain | 在线探索、主动建图 | 依赖 frontier 定义和可见性估计 |
 |
 |
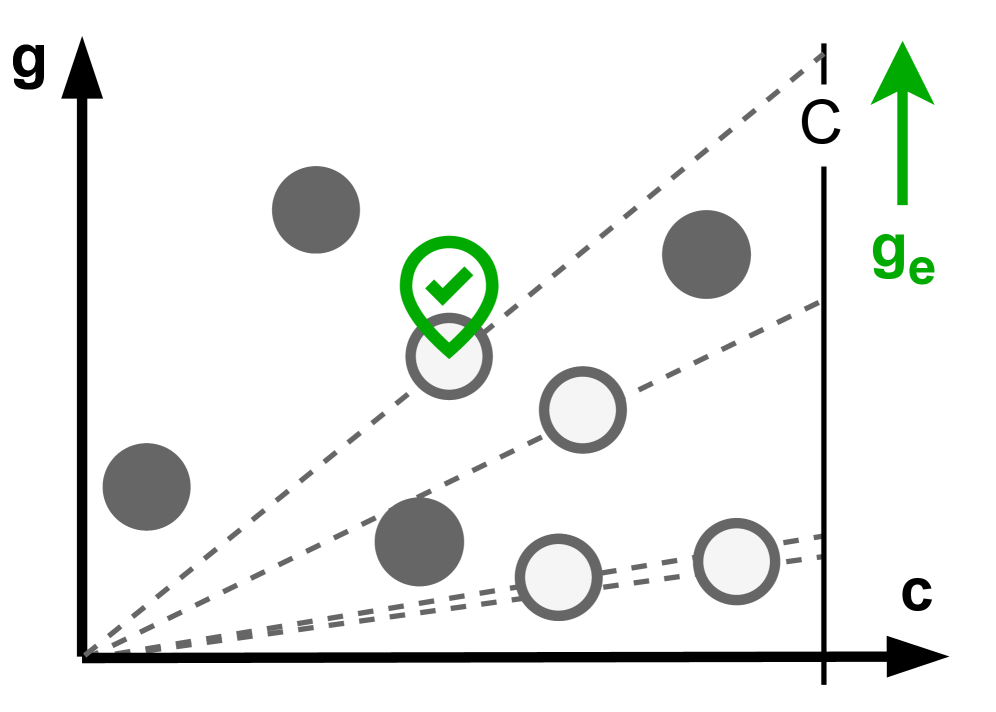 |
| Path Gain:偏向累计已知收益 | Path Ratio:偏向单位代价收益 | Expected Gain:把 frontier 潜在收益纳入评分 |
Expected Gain 是这篇论文很重要的第二个贡献。它要解决的是主动感知里最经典的 exploration-exploitation 平衡:
- exploitation:去已经知道很有价值的视点。
- exploration:去未知区域边界,因为那里可能打开新空间、新表面、新目标。
如果只看已知 gain,机器人会在已知区域附近打转;如果只看 frontier,机器人又可能忽略已经暴露出来的高价值目标。Expected Gain 的做法是在路径评分里引入 frontier 信息,让机器人能估计“走到这里以后,可能继续发现多少新东西”。
对学习者来说,这一节最重要的不是公式,而是思想:
主动感知不能只优化当前地图里的收益,还要给“能带来更多新观测的边界区域”一个合理的预期价值。
9. RRAG:把图搜索接到真实主动感知
如果只是在给定图上跑 NBS,那还只是算法题。真实机器人没有现成图,它要一边走一边采样候选视点。论文提出 RRAG,即 Rapidly-exploring Random Annulus Graph。
RRAG 的名字里有三个关键词:
| 关键词 | 含义 |
|---|---|
| Rapidly-exploring | 像 RRT/RRG 一样,通过随机采样快速覆盖可通行空间 |
| Random | 候选状态来自随机采样,适合未知环境和复杂几何 |
| Annulus Graph | 用环带距离规则控制节点密度和连边半径,避免图太稀或太密 |
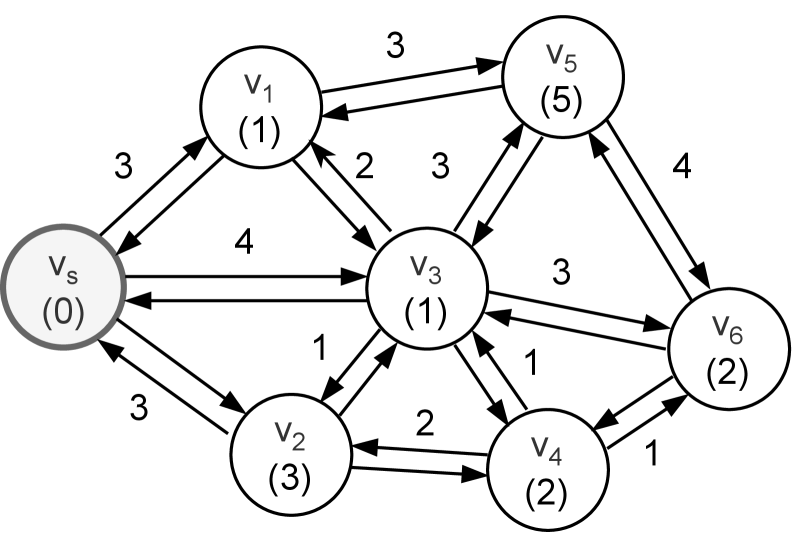
这类图里的每个节点不是单纯的二维位置,而是机器人状态。对相机机器人来说,朝向很重要:站在同一个位置,朝左看和朝右看获得的信息完全不同。
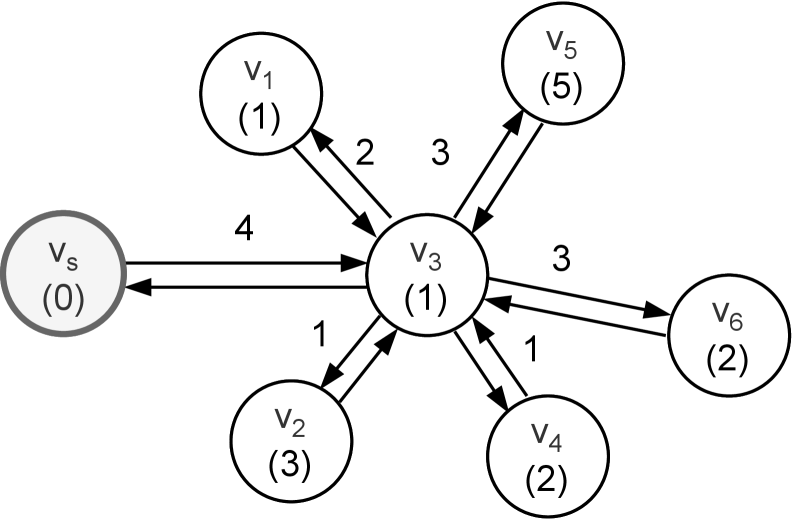
论文强调 RRAG 要保留完整方向采样,也就是同一位置附近可以有多个 yaw candidate。这样 NBS 在搜索路径时,不只是选“走到哪里”,还可以选“到那里后朝哪个方向看”。
RRAG 相比树结构还有一个优势:图允许一个节点被多条路径到达,也允许局部路径复用。树结构通常每个节点只有一个父节点,容易把一些“非最短但高信息”的路径剪掉。
10. 窄通道与 fallback local planner
真实空间里常有窄门、桌椅缝隙、走廊转角。只用直线连接两个采样节点,很容易因为碰撞检测失败而导致图断开。
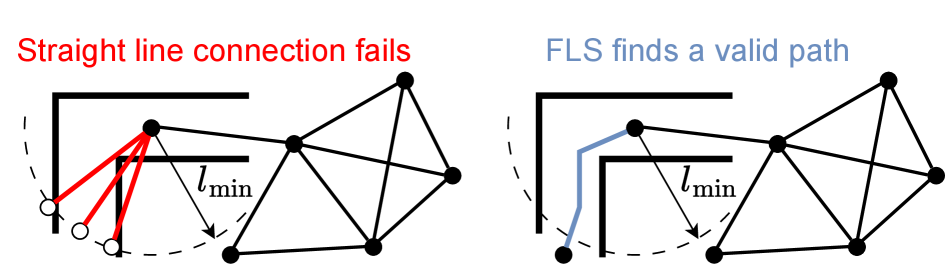
图中展示的是 fallback local sampling-based planner 的意义:当两个节点之间不能用简单直线连接时,局部采样规划器会尝试找一条可行曲线或折线路径,把本来断掉的图重新连起来。
这对主动感知很关键。因为如果图在窄通道处断开,NBS 再强也只能在错误的图上搜索;规划器会以为某些区域不可达,从而错过后续的信息收益。RRAG 的 fallback 不是锦上添花,而是让“在线构图”在 cluttered environments 里能工作的重要工程模块。
11. 三类主动感知任务
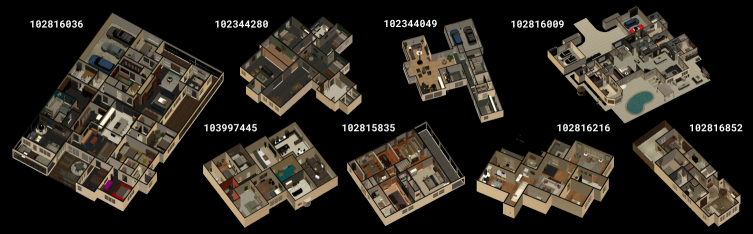
论文在 Habitat Synthetic Scenes Dataset 的 8 个室内场景上做了仿真实验,并覆盖三类任务:point collection、surface reconstruction、volumetric exploration。
11.1 Point Collection
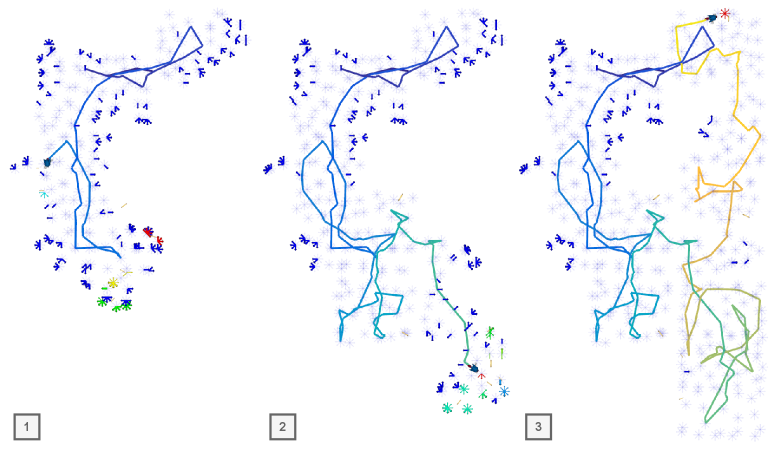
Point Collection 可以理解成一个没有语义标签的 ObjectNav 类任务:
- 环境里有一些点状目标。
- 机器人一开始不知道所有点在哪里。
- 只有当视野覆盖到相关区域时,点才会被发现。
- 机器人需要在预算内尽可能多地收集高价值点。
这个任务适合验证 exploration 和 exploitation 的平衡。机器人看到一个近处点时,应该马上去拿,还是继续探索可能有更多点的未知区域?Expected Gain 就是在处理这种权衡。
11.2 Surface Reconstruction
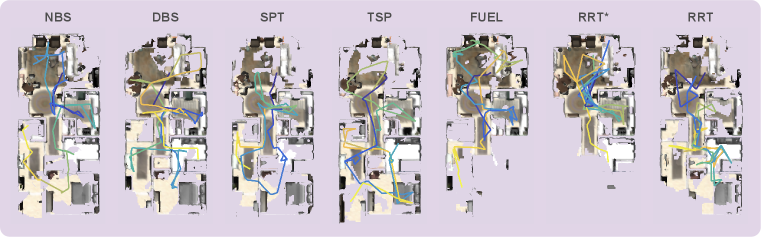
Surface Reconstruction 的目标是尽可能完整地扫描室内表面。真实目标是“最终重建了多少占据体素/表面面积”,但机器人在探索过程中不知道完整环境,所以不能直接优化最终指标。
论文使用 surface frontier 来估计 gain:
- 已知占据表面附近还有未知体素,说明那里可能有没扫完整的表面。
- 如果一个视点能看到很多 surface frontier,它就值得去。
- 重规划后,机器人会持续补洞,让重建从稀疏逐步变完整。
这类任务和现实里的工厂巡检、室内扫描、灾害现场建图非常接近。
11.3 Volumetric Exploration
Volumetric Exploration 更关注把环境中未知体积探索出来,目标类似“最大化被观测自由空间/占据空间”。它和 surface reconstruction 的区别是:
- surface reconstruction 更看重表面是否扫完整。
- volumetric exploration 更看重空间是否被充分探索。
在工程上,两者的 gain function 不一样,但规划器框架可以复用:都是更新地图、计算 frontier、构建 RRAG、用 NBS 找下一段路径。
12. 实验结论怎么理解
论文结论可以分三层看。
第一层,在抽象图上,NBS 比 TSP、SPT、DBS 更稳。尤其在 beam width 较小时,NBS 仍能保留较好路径,这说明“per-node 保留候选”比“per-depth 全局保留候选”更适合信息路径规划。
第二层,在 online perception 设置里,Expected Gain 比单纯 Path Gain 或 Path Ratio 更适合主动探索。原因不是它神奇,而是它明确把 frontier 当成未来潜在收益,让机器人愿意走向能打开新地图的地方。
第三层,在真实主动感知任务里,NBS + RRAG 的组合在 point collection、surface reconstruction、volumetric exploration 三类任务上都表现最好。论文摘要中给出的说法是:在一个或多个任务上相对现有 SOTA 至少提升 20%。
这说明它的贡献不是单点 trick,而是一整套组合:
textNBS 搜索算法
  + Expected Gain 路径选择指标
  + RRAG 在线图构建
  + 高频重规划
  + frontier-based gain estimation
= 可落地的主动感知规划器
13. 真机实验边界
论文还在真实机器人上做了验证。硬件平台是 ANYmal 四足机器人,前端传感器使用 ZED X Mini,相机深度由 NVIDIA Jetson Orin 处理,建图和规划模块运行在 Intel Core i7 CPU 上。
真机实验包括:
- 实验室 surface reconstruction。
- 户外空间和 engine museum 的 surface reconstruction。
- cafeteria 和另一个实验室环境中的 volumetric exploration。
这里要注意:真机部分更偏 qualitative validation,也就是证明完整 pipeline 可以上板运行、可以在复杂环境里在线建图和规划。但它不是大规模真实机器人 benchmark,不应解读成“所有移动机器人主动感知问题都已经解决”。
14. 和 VLA、世界模型的关系
这篇容易被放错位置,因为最近具身智能内容里“世界模型”“VLA”“可交互仿真”很热。但它和这些方向的关系应该这样理解:
| 方向 | 是否是这篇论文的核心 | 关系 |
|---|---|---|
| VLA | 否 | 没有训练视觉语言动作模型,也不输出机械臂动作 token |
| 世界模型 | 否 | 没有预测未来视频或 latent dynamics |
| 传统导航 | 部分相关 | 它不是到目标点最短路,而是信息收益最大化路径 |
| 主动感知 | 是 | 机器人主动选择下一步观测位置和朝向 |
| 建图探索 | 是 | 使用 frontier、ESDF、在线图更新和重规划 |
如果把它放进系统框架,它应该处在这条链路中:
text感知建图模块给出 free / occupied / unknown
        ↓
主动感知规划器选择下一批高价值视点
        ↓
底层运动控制执行路径
        ↓
新观测反过来更新地图
未来它可以和 VLA 结合。例如 VLA 给出高层任务“检查这片区域”或“寻找某个物体”,NBS 负责低层的主动视点规划。但这篇论文自身不解决语言理解和语义目标 grounding。
15. 现在怎么复现
当前不能直接按官方仓库复现实验,因为 OpenApero 代码还没有公开。比较务实的学习顺序是:
- 先读 arXiv HTML 版,重点看 Figure 1、Figure 2、Section 4、Section 5、Section 7、Section 8。
- 等 OpenApero 仓库发布代码后,再从最小图 benchmark 跑起,不要一上来就跑 Habitat 或真机。
- 先复现 graph a priori:构造一个带 gain 和 edge cost 的小图,对比 SPT、DBS、NBS。
- 再复现 graph online perception:每次只暴露局部节点和 frontier,观察 expected gain 是否让路径更愿意探索。
- 最后接 Habitat:加载 HSSD 场景、RGB-D 观测、Voxblox/ESDF 地图、RRAG 图构建、NBS 重规划。
如果想在代码公开前自己做一个简化版,建议只实现下面这个最小实验:
text输入:
  一个 NetworkX 图
  每个节点有 gain
  每条边有 cost
  一个起点 start
  一个预算 budget

实现:
  SPT baseline
  depth-wise beam search
  node-wise beam search
  path_gain / path_ratio 两种评分

输出:
  每种方法找到的路径
  总 gain
  总 cost
  搜索耗时
这个最小实验不需要 Habitat,也不需要机器人仿真,但能把论文最核心的算法思想吃透。
16. 读这篇时建议重点看什么
建议按下面的问题去读,而不是从头硬啃公式:
- 为什么信息路径规划不能直接套最短路?
- 为什么 TSP-based active perception 会贵?为什么两阶段选点和连线会损失解质量?
- DBS 为什么会被局部高分区域吸走 beam?
- NBS 的 per-node top-B 到底保留了什么多样性?
- Expected Gain 怎么把 frontier 的未来价值引入路径评分?
- RRAG 为什么要保留多个 orientation?
- fallback local planner 解决了在线图构建里的哪个真实工程问题?
- 三类任务的 gain function 有什么区别?
- 仿真结论和真机结论分别证明了什么,没有证明什么?
能回答这些问题,基本就抓住了这篇论文的主线。
17. 这篇论文的价值和局限
它的价值在于:把主动感知里长期存在的“搜索算法、路径评分、在线图构建”三个问题连成了一个完整 pipeline,并且用抽象图、Habitat、真机三个层级逐步验证。对做导航、探索、巡检、三维重建的人来说,它比单纯的 VLA 热点更贴近传统机器人系统。
它的局限也很清楚:
- 它是近似搜索,不是精确最优 IPP 求解器。
- 它依赖 gain 和 frontier 估计,如果地图或可见性估计差,规划也会受影响。
- 量化实验主要基于 HSSD 室内场景,真实环境验证规模有限。
- 当前 OpenApero 代码尚未正式发布,教程暂时不能给出完整复现命令。
- 它不处理语言语义目标,也不负责底层控制器的鲁棒性。
更合理的判断是:这是一篇很扎实的 主动感知规划论文,适合补齐“机器人怎么主动选择观察位置”这一块,而不是把它当成 VLA 或世界模型新框架。
18. 推荐作业
组队学习里可以把它作为 Task04 导航规划进阶复盘题:
对比 Habitat / ETPNav / NBS 主动感知:普通导航、语言导航、主动感知分别在优化什么?输入输出是什么?失败边界是什么?
推荐交付:
- 画一张 NBS 主动感知闭环图。
- 用自己的话解释 Figure 1 和 Figure 2。
- 对比 DBS 和 NBS 的 beam 保留方式。
- 说明 expected gain 为什么比单纯 path gain 更适合探索。
- 写清楚当前 OpenApero 尚未公开代码,复现应等待官方 release。
19. 引用与图片来源
本文图片来自论文 arXiv HTML 版本:An Efficient Beam Search Algorithm for Active Perception in Mobile Robotics,版权与使用方式以原论文和 arXiv 页面说明为准。项目与代码状态参考 OpenApero GitHub 与 OpenApero 项目页。