DDPM 详解与代码实现
本教程从 VAE 的局限出发,解释 DDPM 为什么要把“一次生成”改成“多步去噪”,再从前向扩散、反向生成、ELBO、真实后验、噪声预测目标一路推导到最终训练和采样公式。
0. 学习路线
DDPM 的主线可以压缩成五步:
- VAE 通过潜变量 z 一步生成图像,但压缩和重建假设容易带来细节损失。
- DDPM 不急着一步生成完整图像,而是先定义一个固定的加噪过程,把真实图像逐步变成高斯噪声。
- 生成时从高斯噪声开始,训练神经网络学习每一步如何去掉一点噪声。
- 严格推导来自最大似然和 ELBO,但最终可以简化成一个很直观的监督学习任务:预测加到图像里的噪声。
- 实现时的核心不是复杂 loss,而是正确处理噪声日程、时间步、U-Net 输入输出、采样公式和数值范围。
DDPM 先把图像逐步加噪到接近纯噪声,再训练模型反过来逐步去噪;它把高难度的“一步生成图像”拆成很多个简单的“预测并去掉噪声”问题。
DDPM 最常用的训练目标是:
Lsimple(θ)=Et,x0,ϵ[∥ϵ−ϵθ(xt,t)∥2]其中:
xt=αˉtx0+1−αˉtϵ,ϵ∼N(0,I)也就是说,训练时我们知道真实噪声 ϵ,网络只需要根据带噪图像 xt 和时间步 t 把它预测出来。
1. 为什么需要 DDPM
1.1 VAE 存在的几个问题
VAE 很重要,但它也有几个常见问题。
第一,VAE 通常把图像压缩到一个低维潜变量:
x→z→x^如果 z 的容量不足,细节会丢失,生成图像容易偏模糊。
第二,VAE 的重建项常对应像素级似然。以高斯似然为例,最大化 logpθ(x∣z) 常等价于最小化均方误差。均方误差会鼓励模型输出“平均答案”,而平均图像往往看起来不锐利。
第三,VAE 一步从 z 生成 x:
这要求 Decoder 在一次前向传播中完成从抽象语义到全部像素细节的生成。对复杂图像来说,这个映射压力很大。
所以 VAE 的核心矛盾可以理解为:
它想用一个规整、可采样的潜空间生成图像,但这个压缩和一步解码过程可能损失高频细节。
1.2 DDPM 怎么换一个思路
DDPM 不再把生成看成:
而是看成:
xT→xT−1→⋯→x1→x0其中:
- x0 是真实干净图像;
- x1,…,xT 是逐步加噪后的图像;
- xT 接近标准高斯噪声。
生成时先采样:
xT∼N(0,I)然后每一步只做一件小事:
根据当前带噪图像,预测噪声并去掉一点噪声。
DDPM 的好处是:
- 训练目标稳定,不需要 GAN 那样的对抗训练。
- 每一步任务简单,只需要学习局部去噪。
- 图像空间中逐步生成,不需要把所有细节压进一个很小的潜变量。
- 可以使用 U-Net 保留多尺度空间细节。
- 数学上可以从 ELBO 推导到简单的噪声预测 MSE。
2. DDPM 的基本设定
DDPM 有两个过程:
- 前向扩散过程:固定规则,不需要学习,把真实图像逐步加噪。
- 反向生成过程:需要学习,从噪声逐步去噪生成图像。
2.1 前向扩散过程
前向过程从真实图像 x0 出发:
x0→x1→x2→⋯→xTDDPM 把它定义为 Markov chain:
q(x1:T∣x0)=t=1∏Tq(xt∣xt−1)Markov chain 的意思是:如果已经知道 xt−1,那么生成 xt 时不需要再直接看更早的状态。
每一步加噪定义为:
q(xt∣xt−1)=N(xt;1−βtxt−1,βtI)这里:
- βt 是第 t 步的噪声强度;
- βtI 表示每个维度加入方差为 βt 的独立高斯噪声;
- 1−βtxt−1 表示保留一部分上一时刻的图像信号。
通常定义:
αt=1−βt于是:
q(xt∣xt−1)=N(xt;αtxt−1,(1−αt)I)2.2 从分布写成采样公式
如果:
x∼N(μ,σ2I)就可以写成:
x=μ+σϵ,ϵ∼N(0,I)把这个规则用到 DDPM 的一步前向分布:
xt∣xt−1∼N(αtxt−1,(1−αt)I)得到:
xt=αtxt−1+1−αtϵt其中:
ϵt∼N(0,I)这就是一步加噪公式。
2.3 为什么系数用平方根
很多初学者会问:为什么是 1−βt,而不是 1−βt?
假设 xt−1 的方差大约是 I,噪声 ϵt 的方差也是 I。如果:
xt=1−βtxt−1+βtϵt那么方差大约是:
Var(xt)=(1−βt)I+βtI=I也就是说,每一步加噪后,整体尺度不会突然变大或变小。
如果改成:
xt=(1−βt)xt−1+βtϵt那么方差会变成:
(1−βt)2I+βtI它不再正好等于 I。所以 DDPM 使用平方根系数,是为了让信号和噪声的方差配比稳定。
3. 从一步加噪到任意时刻加噪
训练 DDPM 时,如果每次都从 x0 一步步加噪到 xt,会很慢。幸运的是,前向过程有闭式公式,可以直接从 x0 得到任意时间步的 xt。
最终公式是:
q(xt∣x0)=N(xt;αˉtx0,(1−αˉt)I)其中:
αˉt=s=1∏tαs对应采样公式是:
xt=αˉtx0+1−αˉtϵ其中:
ϵ∼N(0,I)这个公式非常重要。它说明训练时可以随机选择一个时间步 t,然后一次性构造对应的带噪图像 xt。
3.1 两步展开看懂闭式公式
一步加噪是:
xt=αtxt−1+1−αtϵt再写出上一时刻:
xt−1=αt−1xt−2+1−αt−1ϵt−1代入第一式:
xt=αt(αt−1xt−2+1−αt−1ϵt−1)+1−αtϵt展开:
xt=αtαt−1xt−2+αt(1−αt−1)ϵt−1+1−αtϵt后两项都是独立高斯噪声的线性组合,所以仍然是高斯噪声。它的方差是:
αt(1−αt−1)+(1−αt)=1−αtαt−1因此可以合并成一个新的标准高斯噪声 ϵ:
xt=αtαt−1xt−2+1−αtαt−1ϵ继续递推到 x0,就得到:
xt=αtαt−1⋯α1x0+1−αtαt−1⋯α1ϵ定义:
αˉt=αtαt−1⋯α1就得到任意时刻公式:
xt=αˉtx0+1−αˉtϵ3.2 为什么 xT 会接近标准高斯噪声
因为:
αˉt=s=1∏tαs而:
αs=1−βs<1当 t 足够大时:
αˉt→0代入:
xt=αˉtx0+1−αˉtϵ第一项会消失:
αˉtx0→0第二项会变成:
1−αˉtϵ→ϵ所以:
xT≈ϵ∼N(0,I)这解释了为什么生成时可以从纯高斯噪声开始。
4. 反向扩散过程
前向过程是人为固定的,不需要学习。真正需要学习的是反向过程:
xT→xT−1→⋯→x0模型联合分布写成:
pθ(x0:T)=p(xT)t=1∏Tpθ(xt−1∣xt)其中:
p(xT)=N(0,I)反向一步通常也设为高斯分布:
pθ(xt−1∣xt)=N(xt−1;μθ(xt,t),σt2I)这里:
- μθ(xt,t) 是神经网络预测出的反向均值;
- σt2I 是反向方差,很多基础实现中先固定不学;
- 网络输入是带噪图像 xt 和时间步 t;
- 网络输出可以设计成预测均值、预测原图 x0 或预测噪声 ϵ。
直觉上,反向一步在做:
给定当前噪声图 xt,猜测上一步稍微干净一点的图像 xt−1 应该在哪里。
5. 训练目标:从最大似然到 ELBO
DDPM 作为生成模型,本来希望最大化真实图像的似然:
logpθ(x0)但:
pθ(x0)=∫pθ(x0:T)dx1:T这个积分需要把所有中间变量 x1,…,xT 都积分掉,直接计算很困难。
因此 DDPM 使用变分下界。训练时最小化负 ELBO:
L=Eq(x1:T∣x0)[−logq(x1:T∣x0)pθ(x0:T)]其中:
pθ(x0:T)=p(xT)t=1∏Tpθ(xt−1∣xt)q(x1:T∣x0)=t=1∏Tq(xt∣xt−1)详细代数推导放在附录 A。主文只保留结论:
L=Eq[DKL(q(xT∣x0)∥p(xT))+t>1∑DKL(q(xt−1∣xt,x0)∥pθ(xt−1∣xt))−logpθ(x0∣x1)]它有三类项。
第一项:
DKL(q(xT∣x0)∥p(xT))表示最终噪声分布要接近标准高斯。因为 T 足够大时 q(xT∣x0)≈N(0,I),这一项通常接近常数。
中间项:
DKL(q(xt−1∣xt,x0)∥pθ(xt−1∣xt))是训练的核心。它要求模型学到的反向一步分布 pθ(xt−1∣xt) 接近真实后验 q(xt−1∣xt,x0)。
最后一项:
−logpθ(x0∣x1)表示从 x1 恢复 x0 的重建误差。
所以 DDPM 的关键问题变成:
如何让神经网络学会逼近真实后验 q(xt−1∣xt,x0)?
6. 真实后验与均值匹配
真实后验是:
q(xt−1∣xt,x0)它表示:如果已知原图 x0 和当前带噪图 xt,那么上一时刻 xt−1 应该是什么分布。
根据贝叶斯公式:
q(xt−1∣xt,x0)=q(xt∣x0)q(xt∣xt−1,x0)q(xt−1∣x0)由于前向过程是马尔科夫链:
q(xt∣xt−1,x0)=q(xt∣xt−1)所以:
q(xt−1∣xt,x0)=q(xt∣x0)q(xt∣xt−1)q(xt−1∣x0)右边三个分布都是高斯,所以结果仍然是高斯:
q(xt−1∣xt,x0)=N(xt−1;μ~t(xt,x0),β~tI)其中:
μ~t(xt,x0)=1−αˉtαˉt−1βtx0+1−αˉtαt(1−αˉt−1)xt以及:
β~t=1−αˉt1−αˉt−1βt详细配方推导放在附录 B。主文先理解它的含义:
- 真实后验均值 μ~t(xt,x0) 是 x0 和 xt 的线性组合;
- 它告诉我们从 xt 往回走一步时,最合理的中心位置;
- 训练模型时,可以让模型预测的均值 μθ(xt,t) 去接近这个真实均值。
模型反向分布是:
pθ(xt−1∣xt)=N(xt−1;μθ(xt,t),σt2I)如果固定方差,那么两个高斯分布之间的 KL 与模型有关的部分就是均值 MSE:
Lt−1=Eq[2σt21∥μ~t(xt,x0)−μθ(xt,t)∥2]+C其中 C 是与模型参数 θ 无关的常数。
这一步把复杂的概率匹配问题变成了:
让模型预测的反向均值接近真实后验均值。
7. 从预测均值到预测噪声
理论上,网络可以直接预测:
μθ(xt,t)但 DDPM 实践中更常预测噪声:
ϵθ(xt,t)这一步看起来突然,其实来自公式重写。
7.1 先从预测 x0 开始
真实后验均值可以写成:
μ~t(xt,x0)=Atx0+Btxt其中:
At=1−αˉtαˉt−1βtBt=1−αˉtαt(1−αˉt−1)生成时不知道真实 x0,所以可以让网络预测原图:
x0,θ(xt,t)再构造:
μθ(xt,t)=μ~t(xt,x0,θ(xt,t))这说明预测原图 x0 和预测均值 μθ 是可以互相转换的。
7.2 再从预测 x0 改成预测噪声
前向加噪公式是:
xt=αˉtx0+1−αˉtϵ把它对 x0 求解:
x0=αˉtxt−1−αˉtϵ如果网络预测噪声:
ϵθ(xt,t)就可以构造预测原图:
x0,θ(xt,t)=αˉtxt−1−αˉtϵθ(xt,t)再把 x0,θ 代入上一节的 μθ,得到 DDPM 最常见的反向均值参数化:
μθ(xt,t)=αt1(xt−1−αˉtβtϵθ(xt,t))这个公式的完整代数化简放在附录 C。
7.3 为什么更喜欢预测噪声
预测噪声有三个直观优势。
第一,监督信号天然可得。训练时我们自己采样:
ϵ∼N(0,I)然后构造:
xt=αˉtx0+1−αˉtϵ所以真实噪声 ϵ 是已知标签。
第二,目标形式统一。无论图像内容多复杂,噪声始终来自标准高斯:
ϵ∼N(0,I)第三,采样公式直观。模型预测当前图像中的噪声,然后把它从 xt 中减掉。
8. 最终训练目标和采样公式
8.1 从均值匹配到噪声预测 MSE
真实后验均值可以写成噪声形式:
μ~t(xt,x0)=αt1(xt−1−αˉtβtϵ)模型均值写成:
μθ(xt,t)=αt1(xt−1−αˉtβtϵθ(xt,t))两者相减:
μ~t(xt,x0)−μθ(xt,t)=αt1−αˉtβt(ϵθ(xt,t)−ϵ)因此:
∥μ~t(xt,x0)−μθ(xt,t)∥2=αt(1−αˉt)βt2∥ϵ−ϵθ(xt,t)∥2代入 KL 对应的均值匹配项,会得到一个加权的噪声预测 MSE:
Lt−1=E[2σt2αt(1−αˉt)βt2∥ϵ−ϵθ(xt,t)∥2]+CDDPM 实践中常使用简化目标,去掉复杂权重:
Lsimple(θ)=Et,x0,ϵ[∥ϵ−ϵθ(xt,t)∥2]其中:
xt=αˉtx0+1−αˉtϵ这就是 DDPM 最常见的训练目标。
8.2 训练流程
一次训练迭代可以理解为:
- 从数据集中采样真实图像:
x0∼qdata(x0)
- 随机采样时间步:
t∼Uniform({1,…,T})
- 采样高斯噪声:
ϵ∼N(0,I)
- 构造带噪图像:
xt=αˉtx0+1−αˉtϵ
- 让网络预测噪声:
ϵθ(xt,t)
- 最小化噪声预测误差:
∥ϵ−ϵθ(xt,t)∥28.3 采样流程
训练完成后,从纯噪声开始:
xT∼N(0,I)然后从 t=T 到 t=1 逐步执行:
xt−1=μθ(xt,t)+σtz其中:
z∼N(0,I)代入噪声预测形式的均值:
xt−1=αt1(xt−1−αˉtβtϵθ(xt,t))+σtz通常在最后一步 t=1 时不再加入随机噪声,即令:
这样可以避免最后输出又被额外扰动。
9. DDPM代码实现
本节结合 STL10 代码说明 DDPM 如何从公式落到 PyTorch 实现。完整代码位于:
code/train_stl10_ddpm.pycode/generate_stl10_ddpm.py
数据集采用 STL10,代码中使用 split="train",图像默认调整为 96×96。第一次运行时会自动下载数据集,需要提前安装好 torch 和 torchvision。
这份实现采用最基础的 DDPM 配置:线性 beta schedule、噪声预测目标、MSE loss、小型 U-Net 噪声预测器。它的目的不是一次写出最强扩散模型,而是先跑通“训练时加噪、模型预测噪声、采样时逐步去噪”这条闭环。
9.1 数据集和图像范围
STL10 是 RGB 图像,因此模型输入形状为:
x0∈R3×96×96训练脚本中先把图像 resize 到指定大小,再把像素归一化到 [−1,1]:
pythontransform = transforms.Compose(
    [
        transforms.Resize((args.image_size, args.image_size)),
        transforms.ToTensor(),
        transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)),
    ]
)
train_set = datasets.STL10(
    root=args.data_dir,
    split="train",
    download=True,
    transform=transform,
)
这里的 Normalize((0.5,0.5,0.5),(0.5,0.5,0.5)) 会把原来的 [0,1] 像素变成 [−1,1]:
xnorm=2x−1这样做的原因是,DDPM 最后会把图像逐渐加到标准高斯噪声附近。图像范围接近 [−1,1] 时,数据尺度和噪声尺度更匹配。生成保存图片时,再把结果映射回 [0,1]:
pythonutils.save_image((images + 1) / 2, out_path, nrow=int(num_samples**0.5))
9.2 时间嵌入
DDPM 的网络不能只看带噪图像 xt,还必须知道当前时间步 t。同一张图在 t=50 和 t=900 时噪声强度完全不同,如果不给时间信息,网络不知道应该去掉多少噪声。
代码中使用正弦时间嵌入,把整数时间步转成连续向量:
pythonclass SinusoidalTimeEmbedding(nn.Module):
    def __init__(self, dim: int) -> None:
        super().__init__()
        self.dim = dim

    def forward(self, t: torch.Tensor) -> torch.Tensor:
        half = self.dim // 2
        freq = torch.exp(
            -math.log(10000)
            * torch.arange(half, device=t.device, dtype=torch.float32)
            / max(half - 1, 1)
        )
        angles = t.float()[:, None] * freq[None, :]
        emb = torch.cat([angles.sin(), angles.cos()], dim=-1)
        return F.pad(emb, (0, self.dim % 2))
得到的时间向量再经过 MLP:
pythonself.time_mlp = nn.Sequential(
    SinusoidalTimeEmbedding(time_dim),
    nn.Linear(time_dim, time_dim),
    nn.SiLU(),
    nn.Linear(time_dim, time_dim),
)
这样每个时间步都有一个可供网络使用的条件向量。
9.3 残差块如何注入时间信息
U-Net 中的每个残差块都接收两个输入:图像特征 x 和时间特征 time_emb。时间特征先经过线性层投影到当前通道数,再加到卷积特征图上:
pythonclass ResBlock(nn.Module):
    def __init__(self, in_ch: int, out_ch: int, time_dim: int) -> None:
        super().__init__()
        self.conv1 = nn.Conv2d(in_ch, out_ch, 3, padding=1)
        self.norm1 = nn.GroupNorm(norm_groups(out_ch), out_ch)
        self.conv2 = nn.Conv2d(out_ch, out_ch, 3, padding=1)
        self.norm2 = nn.GroupNorm(norm_groups(out_ch), out_ch)
        self.time_proj = nn.Sequential(nn.SiLU(), nn.Linear(time_dim, out_ch))
        self.skip = nn.Conv2d(in_ch, out_ch, 1) if in_ch != out_ch else nn.Identity()

    def forward(self, x: torch.Tensor, time_emb: torch.Tensor) -> torch.Tensor:
        h = F.silu(self.norm1(self.conv1(x)))
        h = h + self.time_proj(time_emb)[:, :, None, None]
        h = F.silu(self.norm2(self.conv2(h)))
        return h + self.skip(x)
其中:
time_proj(time_emb) 的形状是 [B, C];[:, :, None, None] 把它变成 [B, C, 1, 1];- 加到
h 上时会自动 broadcast 到整张特征图。
这一步对应公式中的条件网络:
ϵθ(xt,t)也就是说,模型预测噪声时同时依赖图像状态 xt 和时间步 t。
9.4 U-Net 噪声预测器
训练脚本中的核心模型是 UNet96。它输入一张 96×96 的带噪 RGB 图像,输出同样大小的噪声预测:
xt∈R3×96×96ϵθ(xt,t)∈R3×96×96模型先下采样提取语义特征,再上采样恢复空间分辨率:
pythonself.in_conv = nn.Conv2d(in_ch, base, 3, padding=1)
self.down1 = ResBlock(base, base, time_dim)
self.down2 = ResBlock(base, base * 2, time_dim)
self.down3 = ResBlock(base * 2, base * 4, time_dim)
self.down4 = ResBlock(base * 4, base * 8, time_dim)
self.mid = ResBlock(base * 8, base * 8, time_dim)

self.up3 = ResBlock(base * 8 + base * 4, base * 4, time_dim)
self.up2 = ResBlock(base * 4 + base * 2, base * 2, time_dim)
self.up1 = ResBlock(base * 2 + base, base, time_dim)
self.out = nn.Sequential(
    nn.GroupNorm(norm_groups(base), base),
    nn.SiLU(),
    nn.Conv2d(base, in_ch, 3, padding=1),
)
前向传播时,上采样阶段会把深层特征和下采样阶段保存的特征拼接起来:
pythonx1 = self.down1(self.in_conv(x), time_emb)
x2 = self.down2(self.pool(x1), time_emb)
x3 = self.down3(self.pool(x2), time_emb)
x4 = self.down4(self.pool(x3), time_emb)
h = self.mid(x4, time_emb)

h = F.interpolate(h, scale_factor=2, mode="nearest")
h = self.up3(torch.cat([h, x3], dim=1), time_emb)
h = F.interpolate(h, scale_factor=2, mode="nearest")
h = self.up2(torch.cat([h, x2], dim=1), time_emb)
h = F.interpolate(h, scale_factor=2, mode="nearest")
h = self.up1(torch.cat([h, x1], dim=1), time_emb)
return self.out(h)
这里的 skip connection 很重要。DDPM 要做的是逐像素噪声预测,既需要全局语义,也需要局部纹理位置。下采样路径负责扩大感受野,上采样路径负责恢复分辨率,skip connection 负责把浅层细节送回去。
9.5 Diffusion 工具类
Diffusion 类负责两件事:
- 预计算前向扩散和反向采样需要的系数;
- 提供
q_sample 和 sample 两个核心函数。
初始化时先定义线性 beta schedule:
pythonself.betas = torch.linspace(beta_start, beta_end, timesteps, device=self.device)
self.alphas = 1.0 - self.betas
self.alpha_bars = torch.cumprod(self.alphas, dim=0)
self.sqrt_alpha_bars = torch.sqrt(self.alpha_bars)
self.sqrt_one_minus_alpha_bars = torch.sqrt(1.0 - self.alpha_bars)
这对应前面推导过的:
αt=1−βtαˉt=s=1∏tαs因为这些量只和时间步有关,所以应该在初始化时一次算好,而不是每个 batch 重新计算。
_extract 的作用是从长度为 timesteps 的系数表中取出当前 batch 对应的时间步系数:
pythondef _extract(self, values: torch.Tensor, t: torch.Tensor, x: torch.Tensor) -> torch.Tensor:
    return values.gather(0, t).view(t.size(0), *((1,) * (x.ndim - 1)))
例如一个 batch 有 32 张图,每张图随机到不同的时间步,_extract 就能取出 32 个对应的 αˉt,并 reshape 成 [B,1,1,1],方便和图像张量相乘。
9.6 训练时如何构造 xt
训练 DDPM 不需要从 x0 一步步加噪到 xt,而是直接使用闭式公式:
xt=αˉtx0+1−αˉtϵ代码中的 q_sample 正是在实现这个公式:
pythondef q_sample(
    self,
    x0: torch.Tensor,
    t: torch.Tensor,
    noise: torch.Tensor | None = None,
) -> torch.Tensor:
    if noise is None:
        noise = torch.randn_like(x0)
    return (
        self._extract(self.sqrt_alpha_bars, t, x0) * x0
        + self._extract(self.sqrt_one_minus_alpha_bars, t, x0) * noise
    )
这里的 noise 就是训练监督信号 ϵ。因为噪声是我们自己采样出来的,所以训练标签天然已知,不需要人工标注。
9.7 训练目标
一次训练迭代可以写成五步:
- 从数据集中取出真实图像 x0;
- 随机采样时间步 t;
- 随机采样噪声 ϵ;
- 用闭式公式得到 xt;
- 让模型根据 (xt,t) 预测 ϵ。
训练脚本中的核心代码是:
pythonfor x0, _ in train_loader:
    x0 = x0.to(device)
    t = torch.randint(0, args.timesteps, (x0.size(0),), device=device)
    noise = torch.randn_like(x0)
    xt = diffusion.q_sample(x0, t, noise)
    loss = F.mse_loss(model(xt, t), noise)

    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()
这正对应最终简化目标:
Lsimple(θ)=Et,x0,ϵ[∥ϵ−ϵθ(xt,t)∥2]注意,模型不是直接预测干净图像 x0,而是预测本次加进去的噪声 ϵ。预测出噪声后,采样阶段就可以根据 DDPM 公式一步步构造反向均值。
9.8 训练脚本的输出
train_stl10_ddpm.py 会保存:
checkpoints/stl10_ddpm.pt:模型权重和必要配置;outputs/stl10_sample_epoch_XXX.png:训练过程中从噪声采样得到的 STL10 风格图像。
checkpoint 中保存了:
python{
    "model_state": model.state_dict(),
    "base": args.base,
    "timesteps": args.timesteps,
    "image_size": args.image_size,
}
这些配置会被生成脚本复用。尤其是 image_size,因为 STL10 默认使用 96×96,生成阶段必须和训练阶段保持一致。
运行方式示例:
bashpython train_stl10_ddpm.py --epochs 200 --batch-size 32 --image-size 96
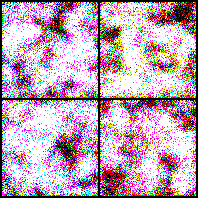
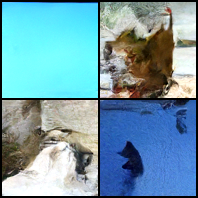
运行结果如下所示,可以看出,一开始训练的时候噪声比较大,当训练到200轮的时候,已经能够重建出一些轮廓,但是效果还是一般,教程为了让大家更好的理解,并没有添加很多的改进技巧,例如注意力机制,类别条件生成等,各位学习完课程之后可以进一步的学习~
9.9 采样生成过程
训练结束后,生成阶段从纯高斯噪声开始:
xT∼N(0,I)然后按照时间步反向循环:
xT→xT−1→⋯→x0代码中的 sample 函数实现了这个过程:
python@torch.no_grad()
def sample(self, model: nn.Module, shape: tuple[int, int, int, int]) -> torch.Tensor:
    model.eval()
    x = torch.randn(shape, device=self.device)

    for step in reversed(range(self.timesteps)):
        t = torch.full((shape[0],), step, device=self.device, dtype=torch.long)
        pred_noise = model(x, t)
        beta_t = self._extract(self.betas, t, x)
        alpha_t = self._extract(self.alphas, t, x)
        alpha_bar_t = self._extract(self.alpha_bars, t, x)
        mean = (1.0 / torch.sqrt(alpha_t)) * (
            x - beta_t / torch.sqrt(1.0 - alpha_bar_t) * pred_noise
        )
        x = mean if step == 0 else mean + torch.sqrt(beta_t) * torch.randn_like(x)

    return x.clamp(-1, 1)
其中反向均值为:
μθ(xt,t)=αt1(xt−1−αˉtβtϵθ(xt,t))代码中的这一行:
pythonx = mean if step == 0 else mean + torch.sqrt(beta_t) * torch.randn_like(x)
表示最后一步不再额外加随机噪声。否则生成出的 x0 会被最后一次噪声扰动。
9.10 测试生成脚本
generate_stl10_ddpm.py 只做生成,不再读取训练数据。它的流程是:
- 加载
checkpoints/stl10_ddpm.pt;
- 根据 checkpoint 里的
base 和 image_size 重建 UNet96;
- 加载模型权重;
- 从标准高斯噪声开始反向采样;
- 保存生成图像。
核心代码为:
pythoncheckpoint = torch.load(args.checkpoint, map_location=device)
image_size = int(checkpoint.get("image_size", 96))
model = UNet96(base=int(checkpoint["base"])).to(device)
model.load_state_dict(checkpoint["model_state"])

diffusion = Diffusion(timesteps=int(checkpoint["timesteps"]), device=device)
with torch.no_grad():
    images = diffusion.sample(model, (args.num_samples, 3, image_size, image_size))
    utils.save_image((images + 1) / 2, args.out, nrow=max(1, int(args.num_samples**0.5)))
运行方式示例:
bashpython generate_stl10_ddpm.py --checkpoint checkpoints/stl10_ddpm.pt --out outputs/generated_stl10.png --num-samples 1
默认只生成一张 96×96 图像,方便先检查模型是否真的能从噪声生成可见结构。如果想看多张图,可以调大 --num-samples。
运行结果如下所示:

10. 常见问题
10.1 DDPM 的前向过程是学出来的吗
不是。前向过程:
q(xt∣xt−1)=N(xt;αtxt−1,βtI)是人为固定的加噪规则。需要学习的是反向过程:
pθ(xt−1∣xt)10.2 为什么训练时不用一步步加噪
因为有闭式公式:
xt=αˉtx0+1−αˉtϵ它可以直接从 x0 得到任意时间步的 xt。
10.3 为什么目标是预测噪声,而不是预测图像
因为训练时噪声 ϵ 是我们自己采样出来的,天然就是监督标签。预测噪声后,可以通过公式恢复 x0 或构造反向均值:
μθ(xt,t)=αt1(xt−1−αˉtβtϵθ(xt,t))所以预测噪声并不弱,它等价于学习反向去噪步骤。
10.4 DDPM 和 VAE 最大区别是什么
VAE 是:
z∼N(0,I),x∼pθ(x∣z)也就是从潜变量一步生成图像。
DDPM 是:
xT∼N(0,I)xT→xT−1→⋯→x0也就是从噪声开始多步去噪生成图像。
10.5 DDPM 的缺点是什么
主要缺点是采样慢。因为它通常需要从 T 到 1 逐步反推,基础版本可能需要几百到上千步。后续可以用 DDIM、加速采样器或蒸馏方法减少采样步数。
11. 总结
DDPM 的核心逻辑是:
- 固定前向加噪:
q(xt∣xt−1)=N(xt;αtxt−1,βtI)
- 推出任意时刻加噪:
xt=αˉtx0+1−αˉtϵ
- 学习反向去噪:
pθ(xt−1∣xt)=N(xt−1;μθ(xt,t),σt2I)
- 用 ELBO 得到真实后验匹配:
DKL(q(xt−1∣xt,x0)∥pθ(xt−1∣xt))
- 把高斯 KL 转成均值 MSE,再转成噪声预测 MSE:
Lsimple(θ)=Et,x0,ϵ[∥ϵ−ϵθ(xt,t)∥2]与 VAE 相比,DDPM 不把全部图像信息压缩进一个低维潜变量,而是在图像空间中逐步去噪。它的训练目标来自概率推导,但最终落地成非常简单的监督学习问题。
12. 课后习题
- VAE 为什么容易生成模糊图像?
- DDPM 为什么不直接从潜变量一步生成图像?
- 前向过程中的 βt 控制什么?
- 为什么一步加噪公式中要使用平方根系数?
- 如何从 x0 直接采样任意时间步的 xt?
- 为什么 xT 会接近标准高斯噪声?
- DDPM 的反向过程为什么要建模为高斯分布?
- ELBO 分解中的中间 KL 项在约束什么?
- 为什么真实后验 q(xt−1∣xt,x0) 有解析解?
- 预测噪声 ϵ 为什么等价于学习反向去噪?
- 采样时为什么最后一步通常不再加噪声?
- 如果没有时间嵌入,DDPM 网络会遇到什么问题?
附录 A:DDPM ELBO 分解详细推导
DDPM 最小化负 ELBO:
L=Eq(x1:T∣x0)[−logq(x1:T∣x0)pθ(x0:T)]展开模型联合分布:
pθ(x0:T)=p(xT)t=1∏Tpθ(xt−1∣xt)展开前向分布:
q(x1:T∣x0)=t=1∏Tq(xt∣xt−1)代入:
L=Eq[−log∏t=1Tq(xt∣xt−1)p(xT)∏t=1Tpθ(xt−1∣xt)]拆开对数:
L=Eq[−logp(xT)−t=1∑Tlogpθ(xt−1∣xt)+t=1∑Tlogq(xt∣xt−1)]对 t>1 使用:
q(xt−1∣xt,x0)=q(xt∣x0)q(xt∣xt−1)q(xt−1∣x0)所以:
q(xt∣xt−1)=q(xt−1∣x0)q(xt−1∣xt,x0)q(xt∣x0)将这些项代入并整理 telescoping 项,可以得到:
L=Eq[−logq(xT∣x0)p(xT)−t>1∑logq(xt−1∣xt,x0)pθ(xt−1∣xt)−logpθ(x0∣x1)]写成 KL 形式:
L=Eq[DKL(q(xT∣x0)∥p(xT))+t>1∑DKL(q(xt−1∣xt,x0)∥pθ(xt−1∣xt))−logpθ(x0∣x1)]这个式子说明:训练 DDPM 的核心,就是让模型的反向一步分布匹配前向过程推出来的真实后验。
附录 B:真实后验 q(xt−1∣xt,x0) 的详细推导
令:
我们要求:
q(z∣xt,x0)根据贝叶斯公式:
q(z∣xt,x0)∝q(xt∣z)q(z∣x0)其中:
q(xt∣z)=N(xt;αtz,βtI)q(z∣x0)=N(z;αˉt−1x0,(1−αˉt−1)I)只看与 z 有关的指数部分:
q(z∣xt,x0)∝exp(−2βt1∥xt−αtz∥2−2(1−αˉt−1)1z−αˉt−1x02)展开第一项:
∥xt−αtz∥2=∥xt∥2−2αtxt⊤z+αt∥z∥2与 z 有关的部分是:
−2βtαt∥z∥2+βtαtxt⊤z展开第二项:
z−αˉt−1x02=∥z∥2−2αˉt−1x0⊤z+αˉt−1∥x0∥2与 z 有关的部分是:
−2(1−αˉt−1)1∥z∥2+1−αˉt−1αˉt−1x0⊤z合并:
logq(z∣xt,x0)=−21(βtαt+1−αˉt−11)∥z∥2+(βtαtxt+1−αˉt−1αˉt−1x0)⊤z+C高斯分布的标准指数形式是:
logN(z;μ,Σ)=−21z⊤Σ−1z+z⊤Σ−1μ+C对比二次项系数:
Σ−1=(βtαt+1−αˉt−11)I所以:
Σ=(βtαt+1−αˉt−11)−1I通分:
Σ=αt(1−αˉt−1)+βtβt(1−αˉt−1)I因为:
αˉt=αtαˉt−1且:
αt+βt=1所以:
αt(1−αˉt−1)+βt=1−αˉt因此:
Σ=1−αˉtβt(1−αˉt−1)I即:
β~t=1−αˉt1−αˉt−1βt再求均值。由一次项系数:
Σ−1μ=βtαtxt+1−αˉt−1αˉt−1x0所以:
μ=Σ(βtαtxt+1−αˉt−1αˉt−1x0)代入 Σ:
μ=1−αˉtβt(1−αˉt−1)(βtαtxt+1−αˉt−1αˉt−1x0)得到:
μ=1−αˉtαt(1−αˉt−1)xt+1−αˉtαˉt−1βtx0所以:
μ~t(xt,x0)=1−αˉtαˉt−1βtx0+1−αˉtαt(1−αˉt−1)xt
附录 C:从预测噪声推导反向均值公式
已知:
μθ(xt,t)=1−αˉtαˉt−1βtx0,θ(xt,t)+1−αˉtαt(1−αˉt−1)xt又有:
x0,θ(xt,t)=αˉtxt−1−αˉtϵθ(xt,t)代入:
μθ(xt,t)=1−αˉtαˉt−1βt⋅αˉtxt−1−αˉtϵθ(xt,t)+1−αˉtαt(1−αˉt−1)xt因为:
αˉt=αtαˉt−1所以:
αˉtαˉt−1=αt1于是:
μθ(xt,t)=αt(1−αˉt)βtxt−αt1−αˉtβtϵθ(xt,t)+1−αˉtαt(1−αˉt−1)xt合并 xt 系数:
αt(1−αˉt)βt+1−αˉtαt(1−αˉt−1)通分:
αt(1−αˉt)βt+αt(1−αˉt−1)因为:
βt+αt=1且:
αtαˉt−1=αˉt所以:
βt+αt(1−αˉt−1)=βt+αt−αtαˉt−1=1−αˉt因此 xt 的系数是:
αt1最终:
μθ(xt,t)=αt1xt−αt1−αˉtβtϵθ(xt,t)提取 αt1:
μθ(xt,t)=αt1(xt−1−αˉtβtϵθ(xt,t))
