扩散数理基础与问题解析入门
生成模型的核心问题是:
我们希望模型学会一个数据分布 Pdata(x),然后能从这个分布中采样新的样本 x。
比如:人脸图像分布,手写数字分布,圆环点云分布,文本、音频、视频分布等。
但是数据分布通常很复杂,我们无法直接写出它的分布以及密度函数,所以我们需要一些技巧来解决这些问题。
很多人在入门扩散模型的时候就被一大堆的公式吓跑了,其实扩散原理很简单,这篇内容主要就是用简单的代码讲解扩散模型,让大家在不推导复杂公式的前提下,熟悉vae和ddpm。
在本章中第一部分将给大家讲解扩散模型需要的一些数理基础,主要用于后续的公式推导,如果大家想要直接感受扩散模型,可以直接查看第二部分的内容,他是vae和ddpm的简化版,给大家一个完整简单的扩散体验,第三部分通过第二部分的内容,告诉大家第二部分有些函数我们是得不到的,因此我们需要扩散模型。
一、数理基础
1、贝叶斯公式
在学习贝叶斯公式时,我们经常会看到下面这个形式:
p(z∣x)=p(x)p(x∣z)p(z)这个公式的核心思想是:
看到一个结果之后,反推出它最可能来自什么原因。
在机器学习、统计推断、图像识别、自然语言处理等任务中,贝叶斯公式都非常重要。下面我们逐项理解公式中的每个符号。
| 符号 |
名称 |
含义 |
| z |
隐变量 / 潜在原因 |
表示我们看不见、但想要推断的原因 |
| x |
观测数据 |
表示我们已经看到的数据或现象 |
| p(z) |
先验概率 |
在看到数据 x 之前,原因 z 出现的概率 |
| p(x∣z) |
似然 |
在原因 z 已知的情况下,观测到数据 x 的概率 |
| p(z∣x) |
后验概率 |
在观测到数据 x 之后,原因 z 出现的概率 |
| p(x) |
证据 / 边缘似然 |
观测到数据 x 本身的总概率 |
z:潜在原因
z 表示我们想要推断的对象。
它通常不是直接观察到的,而是隐藏在数据背后的原因,所以也叫隐变量。
例如:看到一个病人的症状,我们想判断他得了什么病。
x:观测数据
x 表示我们已经观察到的数据。
例如:一组症状。
在贝叶斯公式中,我们是根据已经观察到的 x,去推断背后的原因 z。
也就是说:x 是结果,z 是可能导致这个结果的原因。
p(x):证据或边缘似然
p(x) 表示观测到数据 x 本身的总概率,它也叫证据,或者边缘似然。
例如,某人出现“发烧、咳嗽、流鼻涕”这些症状,可能由很多原因导致:感冒、流感、过敏、肺炎、其他疾病。
因此,p(x) 会综合考虑所有可能原因导致该观测结果的概率。
如果可能原因是离散的,可以写成:p(x)=∑zp(x∣z)p(z)
它的主要作用是:对概率进行归一化,让所有可能原因的后验概率加起来等于 1。
p(z):先验概率
p(z) 表示在还没有看到观测数据 x 之前,我们对原因 z 的初始判断,它也叫先验概率。
例如,在判断一个人是否感冒时,如果现在是流感高发季,那么“感冒”这个原因本身出现的概率就比较高;如果是非流感季节,那么这个概率可能就比较低。
所以,p(z) 可以理解为在看到证据之前,我们根据已有经验对原因的判断。
p(x∣z):似然
p(x∣z) 表示在原因 z 已经确定的情况下,观测到数据 x 的概率,它也叫似然。
例如,如果某人真的感冒了,那么他出现“发烧、咳嗽、流鼻涕”等症状的概率有多大?
这里的关系是:p(症状∣感冒)
它衡量的是:某个原因能不能很好地解释我们看到的现象,如果一个原因能够很好地解释观测数据,那么对应的似然就比较大;反之,似然就比较小。
p(z∣x):后验概率
p(z∣x) 表示在已经观察到数据 x 之后,原因 z 出现的概率,它也叫后验概率。
这是贝叶斯公式最终想要求的东西。
例如,看到一个人出现了“发烧、咳嗽、流鼻涕”的症状之后,我们想知道他真的感冒的概率有多大:p(感冒∣症状)
所以,后验概率可以理解为:看到结果之后,对原因的重新判断。
贝叶斯公式的作用,就是把先验概率和观测数据结合起来,得到后验概率。
贝叶斯公式:
p(z∣x)=p(x)p(x∣z)p(z)可以理解为:后验概率 = 似然 × 先验概率 ÷ 证据
也就是:
| 公式项 |
直观理解 |
| p(z∣x) |
看到结果后,原因有多可能 |
| p(x∣z) |
如果原因成立,结果有多可能 |
| p(z) |
原因本来有多可能 |
| p(x) |
结果总体有多常见 |
因此,贝叶斯公式的核心作用是:根据已经观察到的数据,结合已有经验,更新我们对某个原因的判断。
2、詹森不等式(Jensen 不等式)
对于凹函数 f, 有:
f(E[X])≥E[f(X)]对于凸函数 f, 有:
f(E[X])≤E[f(X)]通常在机器学习中 logx 代表 lnx 是凹函数,所以:
logE[X]≥E[logX]很多模型里我们想最大化的是:logp(x) 但 p(x) 往往是一个积分:
p(x)=∫p(x,z)dz于是:
logp(x)=log∫p(x,z)dz这个东西通常不好直接优化,詹森不等式可以帮我们构造一个下界,也就是:
logp(x)≥某个可优化的目标这个下界就是很多生成模型中的核心。
3、高斯分布
高斯分布,也叫正态分布,是生成模型里最常用的分布。
一维高斯分布
一维高斯分布写作:
x∼N(μ,σ2)下面我们可以求出他的概率密度函数。
我们可以先看最简单的标准正态分布:
X∼N(0,1)标准正态分布的密度函数可写成:
f(x)=Ce−2x2其中 C 是待定常数,因为 f(x) 是概率密度函数,所以必须满足归一化条件:
∫−∞+∞f(x)dx=1将
f(x)=Ce−2x2 代入:
∫−∞+∞Ce−2x2dx=1C∫−∞+∞e−2x2dx=1而高斯积分有:
∫−∞+∞e−2x2dx=2π所以:C2π=1
解得:
C=2π1因此标准正态分布的密度函数为:
f(x)=2π1e−2x2设随机变量 X 服从一般正态分布:
X∼N(μ,σ2)对于一维高斯分布,可以把它标准化为标准正态分布。
令:
u=σx−μ则标准正态密度函数为:
φ(u)=2π1e−2u2因为:
u=σx−μ所以:
dxdu=σ1根据连续型随机变量的密度变换公式:
fX(x)=φ(u)dxdu代入 u=σx−μ,得到:
fX(x)=φ(σx−μ)⋅σ1继续代入标准正态密度函数:
fX(x)=2π1e−21(σx−μ)2⋅σ1整理:
fX(x)=2πσ1e−2σ2(x−μ)2所以,一般正态分布的密度函数为:
fX(x)=2πσ1exp(−2σ2(x−μ)2)其中,μ 是均值,σ2 是方差,σ 是标准差。均值控制分布中心,方差控制分布宽窄。
多维高斯分布
对于具身领域来说,图像、隐变量、二维点通常不是一维变量,而是多维向量。
多维高斯分布写作:
x∼N(μ,Σ)密度函数是:
p(x)=(2π)d∣Σ∣1exp(−21(x−μ)TΣ−1(x−μ))其中:d 是维度,μ∈Rd 是均值向量,Σ∈Rd×d 是协方差矩阵
如果协方差是单位矩阵:
那么就是标准多维高斯:
x∼N(0,I)4、KL散度
KL 散度用于衡量两个概率分布之间的差异,也常被称为相对熵。
假设有两个概率分布:真实分布:P,近似分布:Q
那么从 Q 去近似 P 的 KL 散度定义为:
DKL(P∥Q)=x∑P(x)logQ(x)P(x)如果是连续型随机变量,则为:
DKL(P∥Q)=∫P(x)logQ(x)P(x)dxKL 散度可以理解为:当真实分布是 P,但你用 Q 来编码或建模时,平均会多付出的信息量。
也就是说:P 是真实情况,Q 是你的模型假设,KL 散度越小,说明 Q 越接近 P,KL 散度为 0,说明两个分布完全相同。
举一个简单例子
假设:
P=(0.5,0.5)Q=(0.9,0.1)则:
DKL(P∥Q)=0.5log0.90.5+0.5log0.10.5=0.5log95+0.5log5如果使用自然对数,结果约为:
DKL(P∥Q)≈0.5108KL散度与交叉熵的关系
交叉熵定义为:
H(P,Q)=−x∑P(x)logQ(x)熵定义为:
H(P)=−x∑P(x)logP(x)KL 散度满足:
DKL(P∥Q)=H(P,Q)−H(P)因此,在机器学习中,最小化交叉熵等价于在 P 固定时最小化 KL 散度。
因此可以看出KL 散度衡量的是:用分布 Q 去近似真实分布 P 时,平均多损失了多少信息。
二、生成基础入门案例
直接讲vae、ddpm以及fm可能会让大家很迷茫,我在初学的时候,也很迷茫,所以用一个简单的案例让大家对生成过程有一个基础的了解,对于后面的扩散模型的学习,有着很大的帮助,下面我将用圆环分布讲解基础生成步骤,让我们开始吧~
这个例子非常适合入门,因为圆环的函数、密度和采样过程都可以显式构造,也会按vae和ddpm的生成结构来给大家入门。后续我们也会在这章的第三部分为大家简单的讲解一下为什么需要vae、ddpm或者其他的扩散模型。
我们先不训练任何神经网络,而是用手写规则来模拟三种生成思路:
1、 直接采样:直接从圆周的数学定义采样。
2、 模拟VAE采样:先从潜变量先验采样,再通过 decoder 一步生成圆周点。
3、 模拟DDPM采样:先从高斯噪声开始,再一步步去噪到圆周上。
目标分布都是二维圆周:x12+x22=R2,也就是半径为 R 的圆。
我们希望生成一批二维点:
x=(x1x2)并且这些点落在半径为 R 的圆周上:
x12+x22=R2例如令:
那么目标就是生成如下这种分布:
text        * * * * *
     *             *
   *                 *
  *                   *
  *                   *
   *                 *
     *             *
        * * * * *
方法一:直接采样圆周
一个圆周上的点可以用角度参数化:
x1=Rcosθx2=Rsinθ如果我们希望点均匀地分布在圆周上,只需要让角度均匀分布:
θ∼Uniform(0,2π)然后计算:
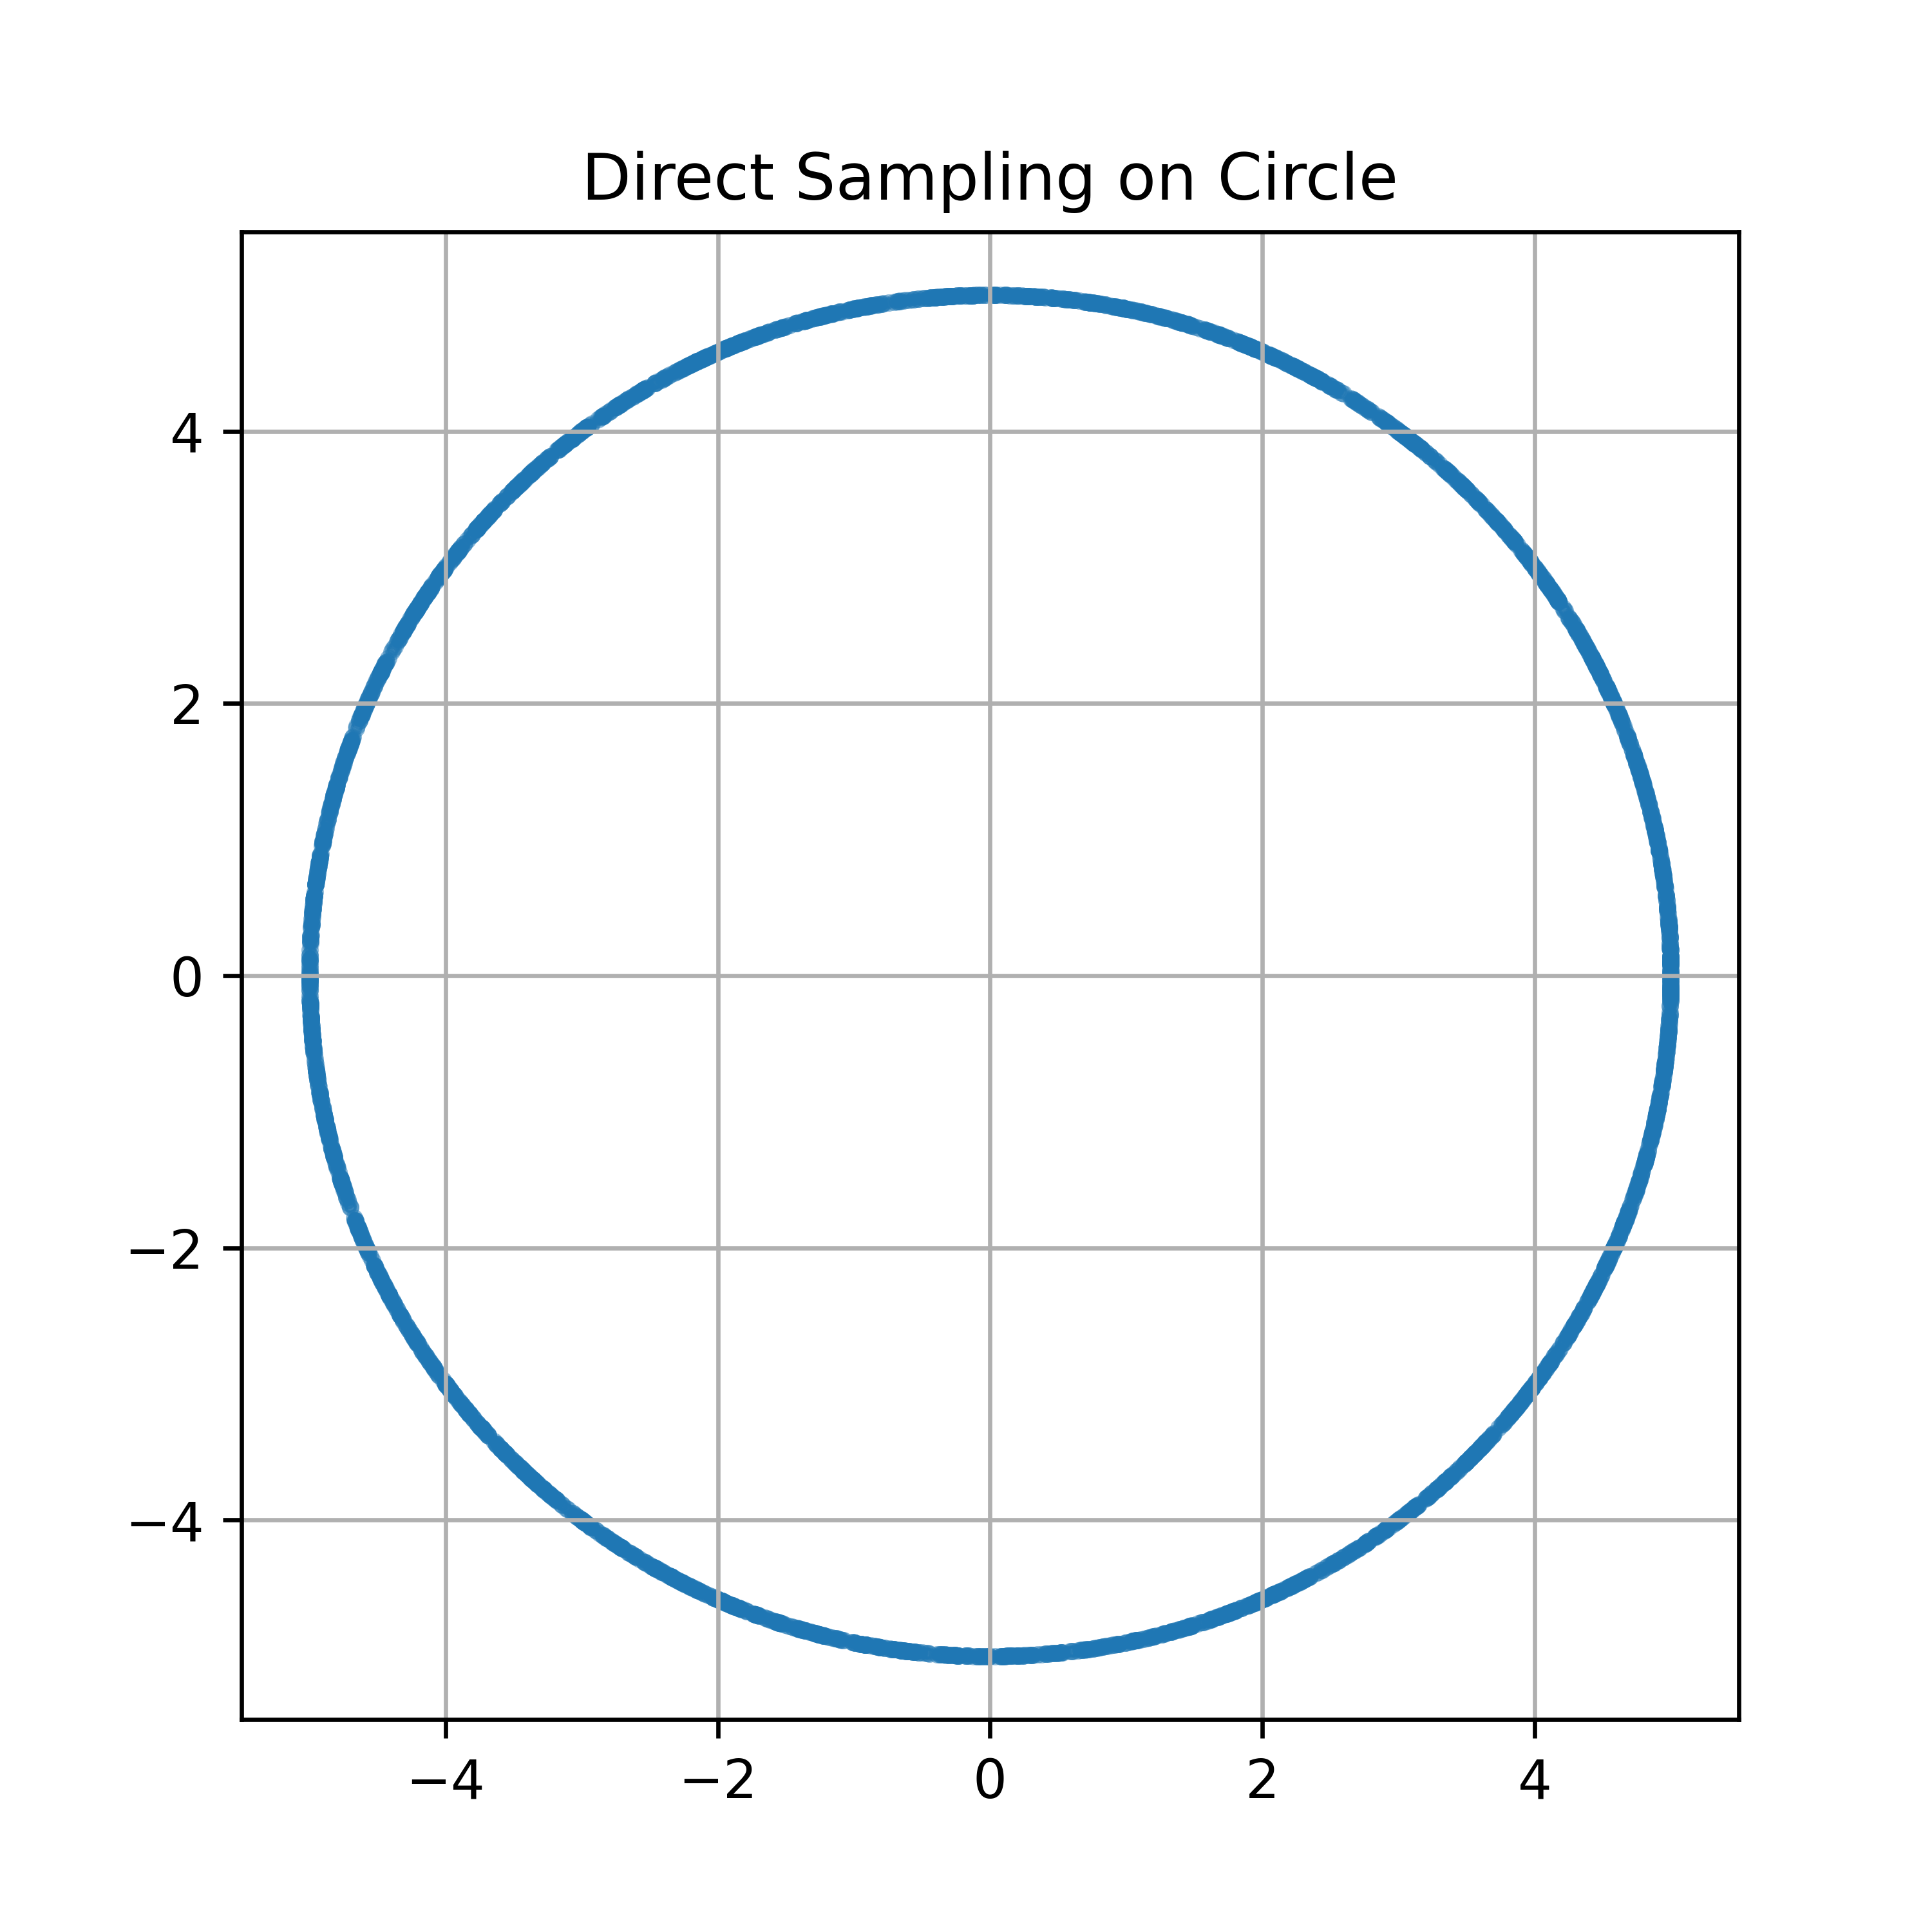
x=(RcosθRsinθ)这就是最直接的圆周采样,只要你知道目标分布的显式形式,就可以直接采样。
实现参考code代码中的direct.py文件,效果如下:
方法二:模拟VAE采样圆周
VAE 的生成过程通常是:
z∼p(z)x∼pθ(x∣z)最常见的先验是标准正态分布:
z∼N(0,I)如果 decoder 是确定性的,可以简化成:
x=fθ(z)也就是说,VAE 的核心生成逻辑是:先采样潜变量 z,然后通过 decoder 生成 x。
我们可以设计一个手写 decoder:
z∼N(0,I)其中:
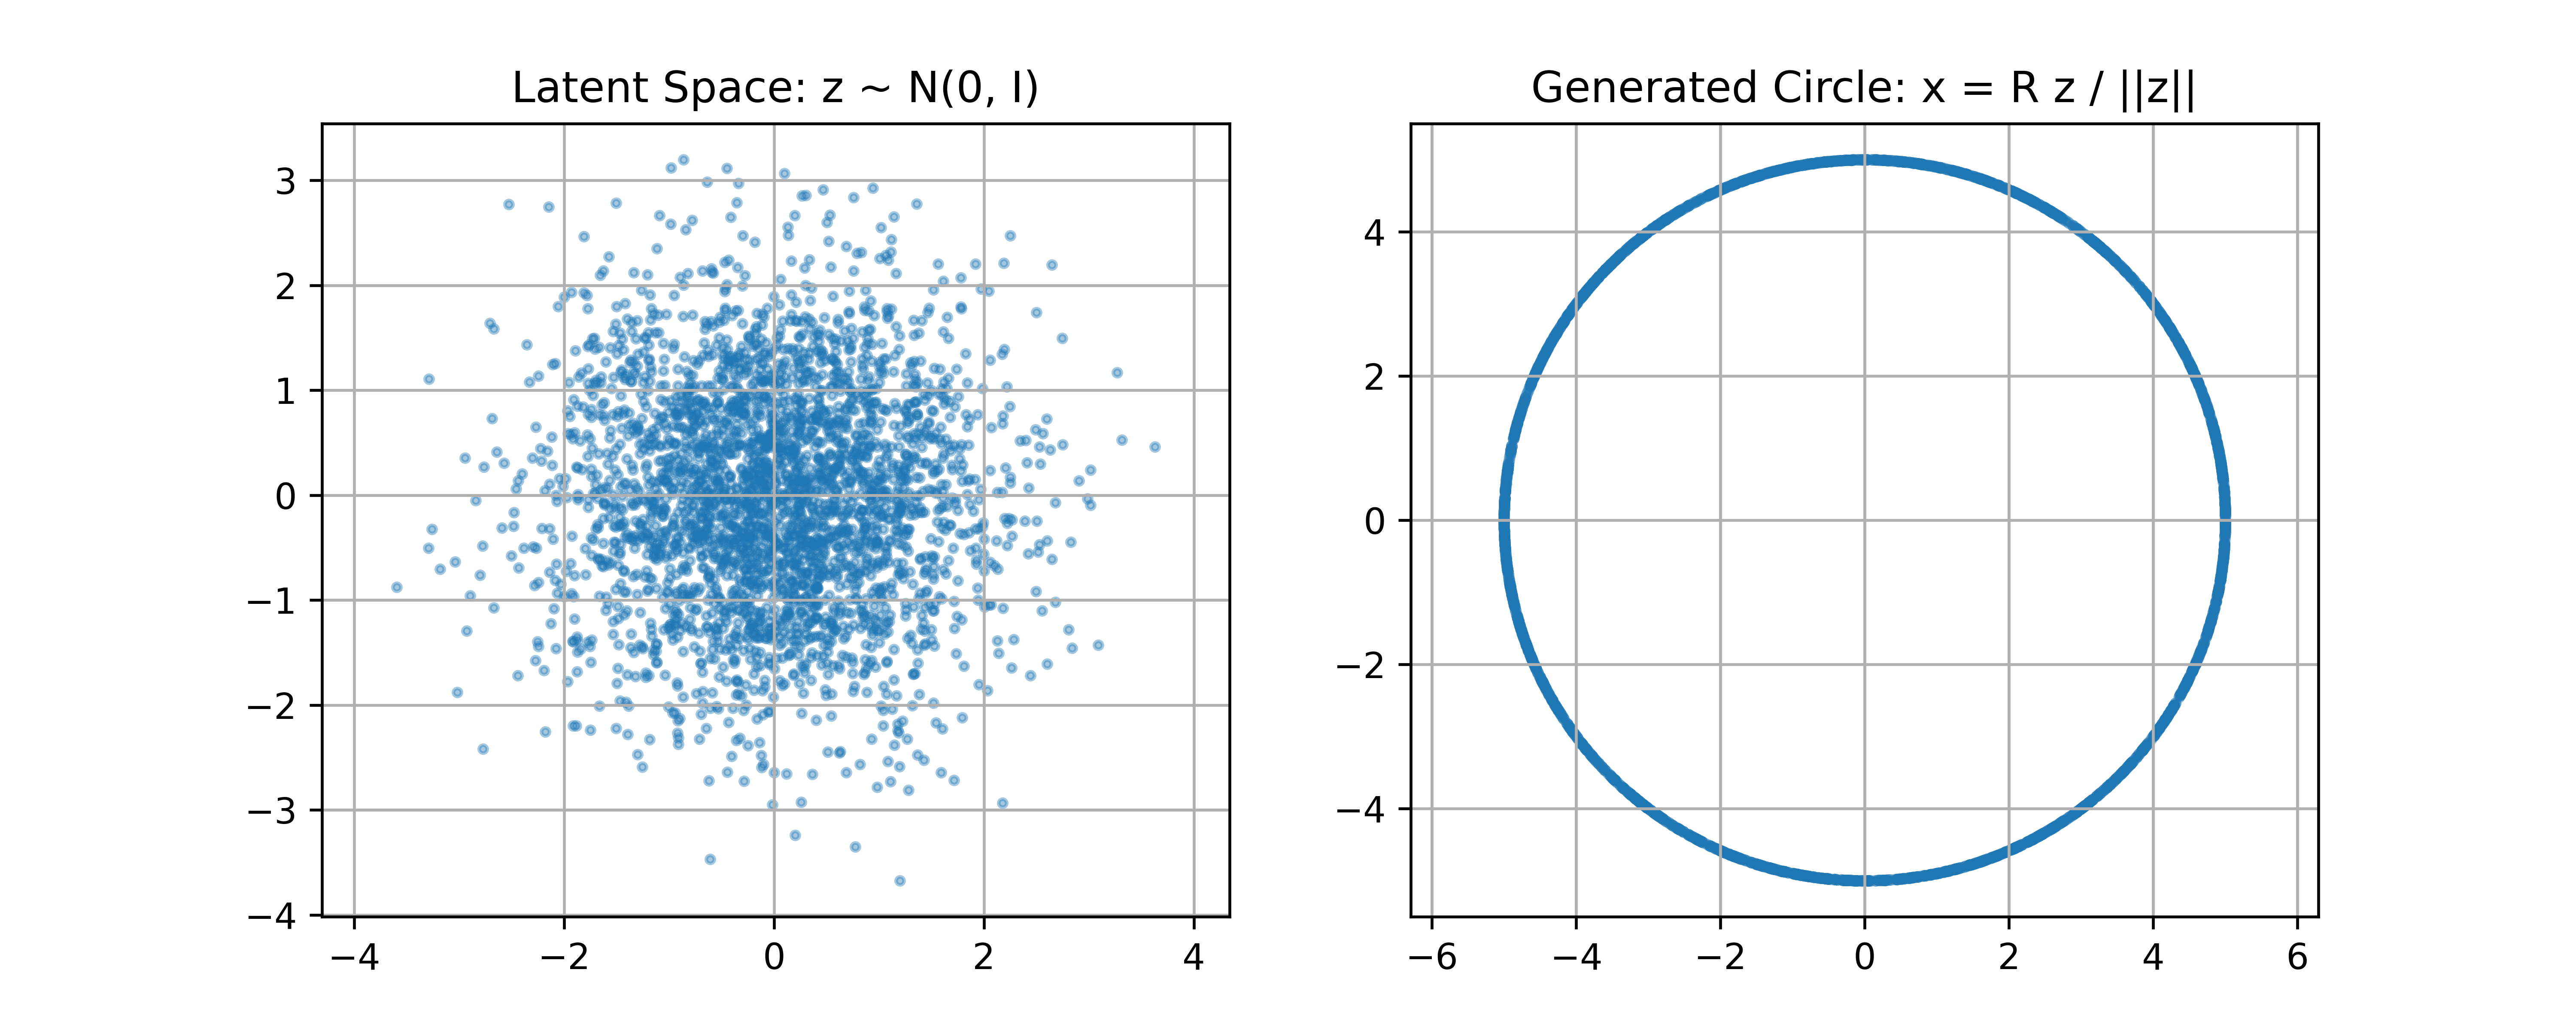
z=(z1z2)然后把这个二维高斯点投影到半径为 R 的圆周上:
x=R∥z∥z其中:
∥z∥=z12+z22展开写就是:
x1=Rz12+z22z1x2=Rz12+z22z2实现参考code代码中的vae_imitat.py文件,效果如下:
vae实际生成的时候,都是一步生成的,这个可能会导致结果偏向平均,因此才有了ddpm,这个大家可以先有个基础的认知,后续会在vae单独讲解的时候讲。
DDPM 和 VAE 的区别
VAE 是:
z∼N(0,I)x=fθ(z)它是一步生成。
DDPM 是:
xT∼N(0,I)xT→xT−1→⋯→x0它是多步生成。
方法三:模拟DDPM采样圆周
DDPM 的生成不是一步完成的。
它的生成过程是:
xT∼N(0,I)然后逐步去噪:
xT→xT−1→xT−2→⋯→x0最后得到数据样本:
x0∼pdata对于圆周分布来说,就是希望最后:
x12+x22≈R2真正的 DDPM 有两个过程:1、 前向加噪,2、 反向去噪
为了入门理解,我们可以先写一个手工去噪规则,模拟 DDPM 的采样过程。
核心想法是:
1、 从高斯噪声开始。
2、 每一步预测“干净圆周点”。
3、 当前点往预测的圆周点靠近。
4、 每一步加一点越来越小的噪声。
5、 最后点落到圆周附近。
对于任意一个当前点 xt,我们可以把它投影到半径为 R 的圆周上:
x^0=R∥xt∥xt这可以看作一个手写的去噪模型,真正 DDPM 中,x^0 是由神经网络预测出来的。
令当前点为 xt,预测的干净点为:
x^0=R∥xt∥xt然后更新:
xt−1=(1−γt)xt+γtx^0+σtη其中:
η∼N(0,I)这里:γt 控制每一步往圆周靠近多少,σt 控制每一步加入多少随机噪声,随着采样推进,σt 应该越来越小。
实现参考code代码中的ddpm_imitat.py文件,效果如下:

你会看到一个过程:
text标准高斯噪声 -> 点逐渐被推向圆周 -> 最后形成半径为 R 的圆
三、实际模型被简化的部分
1、VAE
真正的 VAE 是:
z∼N(0,I)x∼pθ(x∣z)其中 pθ(x∣z) 是神经网络 decoder 定义的分布。
常见形式是:
pθ(x∣z)=N(μθ(z),σ2I)采样时:
x=μθ(z)+σϵ其中:
ϵ∼N(0,I)在我们的简化版本中:
μθ(z)被替换成了:
μ(z)=R∥z∥z
2、DDPM
真正 DDPM 的前向过程是:
xt=αˉtx0+1−αˉtϵ训练神经网络:
ϵθ(xt,t)≈ϵ采样时从:
xT∼N(0,I)开始,逐步去噪。
在我们的简化版本中,神经网络预测被替换成了几何投影:
x^0=R∥xt∥xt也就是说,真正 DDPM中,神经网络学会把 x_t 去噪成 x_0,我们的简化版本中,直接用手写规则把 x_t 投影到圆周上。
在真实的任务中,我们没有办法直接得到类似于圆周分布的这种能够直接用数学公式表达的分布,因此才需要通过神经网络,编码解码,重参数化等技巧来将分布学习出来。
vae、ddpm和fm具体是怎么进行学习分布,生成数据的,以及目前比较前沿的具身扩散生成应用,例如dreamdojo,dreamzero,以及其他具身生成理解和生成,例如jepa,lewm等,会在后续的章节中进行更详细的讲解,希望大家看完这一章有所收获,对扩散模型有一个初步的了解。
感谢大家的阅读,安全带系好!我们继续向后面的章节发车啦~
