
具身智能推理与部署框架:从 APXInf 到 Jetson-PI、Embodied.cpp
这一章解决什么问题
VLA/WAM 模型训练完成,并不等于机器人已经能够稳定运行。真实部署还要处理模型前向、flow/diffusion 采样、相机和本体状态同步、action chunk 调度、通信、IK、控制周期、数据记录以及多机器人资源分配。
这一章把目前容易混在一起的项目放到同一张图里比较:
- 端侧推理 Runtime:APXInf、Embodied.cpp、vla.cpp、Jetson-PI-Edge;
- 异步控制与延迟隐藏:Jetson-PI、OpenPI-RTC、EVA-Client;
- 真实机器人部署和数据闭环:EVA-Client;
- 多机器人/云端 Serving:ROSA;
- 训练、rollout 和评测基础设施:RLinf;
- 模型参考实现和策略服务:OpenPI;
- 通用 NVIDIA 部署底座:TensorRT、TensorRT-LLM、Isaac ROS。
它们不是同一种软件,也不应该用同一个指标排名。本章以 APXInf 为可复现案例,其余项目用于建立选型和阅读论文的框架。
1. 先把“推理框架”分层
机器人系统通常是下面这条链路:
text训练 / 后训练
  RLinf、LeRobot、OpenPI 等
          ↓ checkpoint
模型与策略服务
  OpenPI、GR00T、StarVLA 或自定义 policy server
          ↓ observation / action chunk
推理与执行层
  APXInf、Embodied.cpp、vla.cpp、TensorRT
  Jetson-PI、OpenPI-RTC、EVA-Client
          ↓ action
机器人中间件与控制器
  ROS1/ROS2、ZeroMQ、IK、驱动、硬件
其中有两个经常被混淆的概念:
- 推理 Runtime 决定模型前向如何执行,例如算子、量化、显存、图捕获和后端。
- 推理策略/执行客户端 决定什么时候请求模型、如何拼接 action chunk、怎样补偿延迟,以及最终如何把动作发送给机器人。
APXInf 主要属于第一类;Jetson-PI 和 EVA-Client 主要解决第二类;RLinf 则位于训练和评测上层。
2. 全景对照
表 1 具身智能推理与部署项目的定位
| 项目 | 所在层 | 主要特点 | 适合解决的问题 | 公开状态 |
|---|---|---|---|---|
| APXInf | 端侧 Runtime | Rust Runtime、CUDA Kernel、CUDA Graph、BF16/FP8/INT8 | NVIDIA Jetson/RTX 上的低延迟 VLA 推理 | 开源工程;目前以项目文档为主 |
| Embodied.cpp | 通用具身 Runtime | C++ 分层 Runtime,统一 VLA/WAM 接口,面向异构硬件 | 跨模型、跨机器人、跨设备部署 | arXiv:2607.02501,公开页面未标注正式会议/期刊 |
| vla.cpp | 通用 VLA Runtime | 基于 llama.cpp/ggml,GGUF 打包,多模型、多后端 | 不依赖 Python/PyTorch 的轻量 VLA 推理 | arXiv:2606.08094,公开页面未标注正式会议/期刊 |
| Jetson-PI / Jetson-PI-Edge | 异步控制 + Edge Runtime | 前瞻校正、置信度调度、CUDA Graph、GPU 常驻缓存 | Orin 上隐藏推理延迟,提高有效控制频率 | 官方仓库标注 Accepted at CoRL 2026;论文同时有 arXiv:2607.12659 |
| EVA-Client | 真机部署客户端 | ROS/ZeroMQ、同步/异步/ACT/RTC、IK、采集和评测 | 把策略服务接到真实机器人并保留可诊断数据 | arXiv:2607.02646,公开页面未标注正式会议/期刊 |
| ROSA | 集群 Serving | 共享 GPU 池、机器人感知调度、多模型流水线 | 多机器人共享云端/机房 GPU | arXiv:2607.01088,公开页面未标注正式会议/期刊 |
| RLinf | 训练与 rollout 基础设施 | 分布式 RL、仿真、评测、多后端 | 训练和评估具身策略 | 开源框架;不是端侧推理 Runtime |
| OpenPI | 模型/策略参考栈 | π0/π0.5 模型、变换、策略服务 | 复现和提供策略接口 | 开源模型与代码;不是通用部署 Runtime |
| TensorRT / Isaac ROS | 通用部署底座 | NVIDIA 图优化、量化和 ROS 集成 | 固定 NVIDIA 平台的工程部署 | 官方 SDK/工程生态;不是专门的 VLA 论文 Runtime |
论文状态怎么读
本表把“正式发表”和“公开预印本”分开写。Jetson-PI 的官方仓库明确写有 CoRL 2026 接收信息,因此列为“官方仓库标注已接收”;Embodied.cpp、vla.cpp、EVA-Client 和 ROSA 的链接目前是 arXiv 条目,教程不把它们写成已经正式发表于某个会议或期刊。APXInf 目前按开源项目和官方技术介绍讨论,不虚构论文出处。
3. APXInf:专门优化 NVIDIA 端侧 VLA
APXInf 解决的是“已有模型如何在机器人本体上跑得足够快、足够稳”。官方开源载体是 RLinf/APXinf-robo,其中通过 Git submodule 引入 ApxInf 引擎。
它的典型链路是:
textPython API / OpenPI-compatible server
                 ↓
          Rust 系统运行时
                 ↓
  融合算子、CUTLASS/cuBLAS、CUDA Graph、量化
                 ↓
      Jetson Thor / Orin / RTX 4090
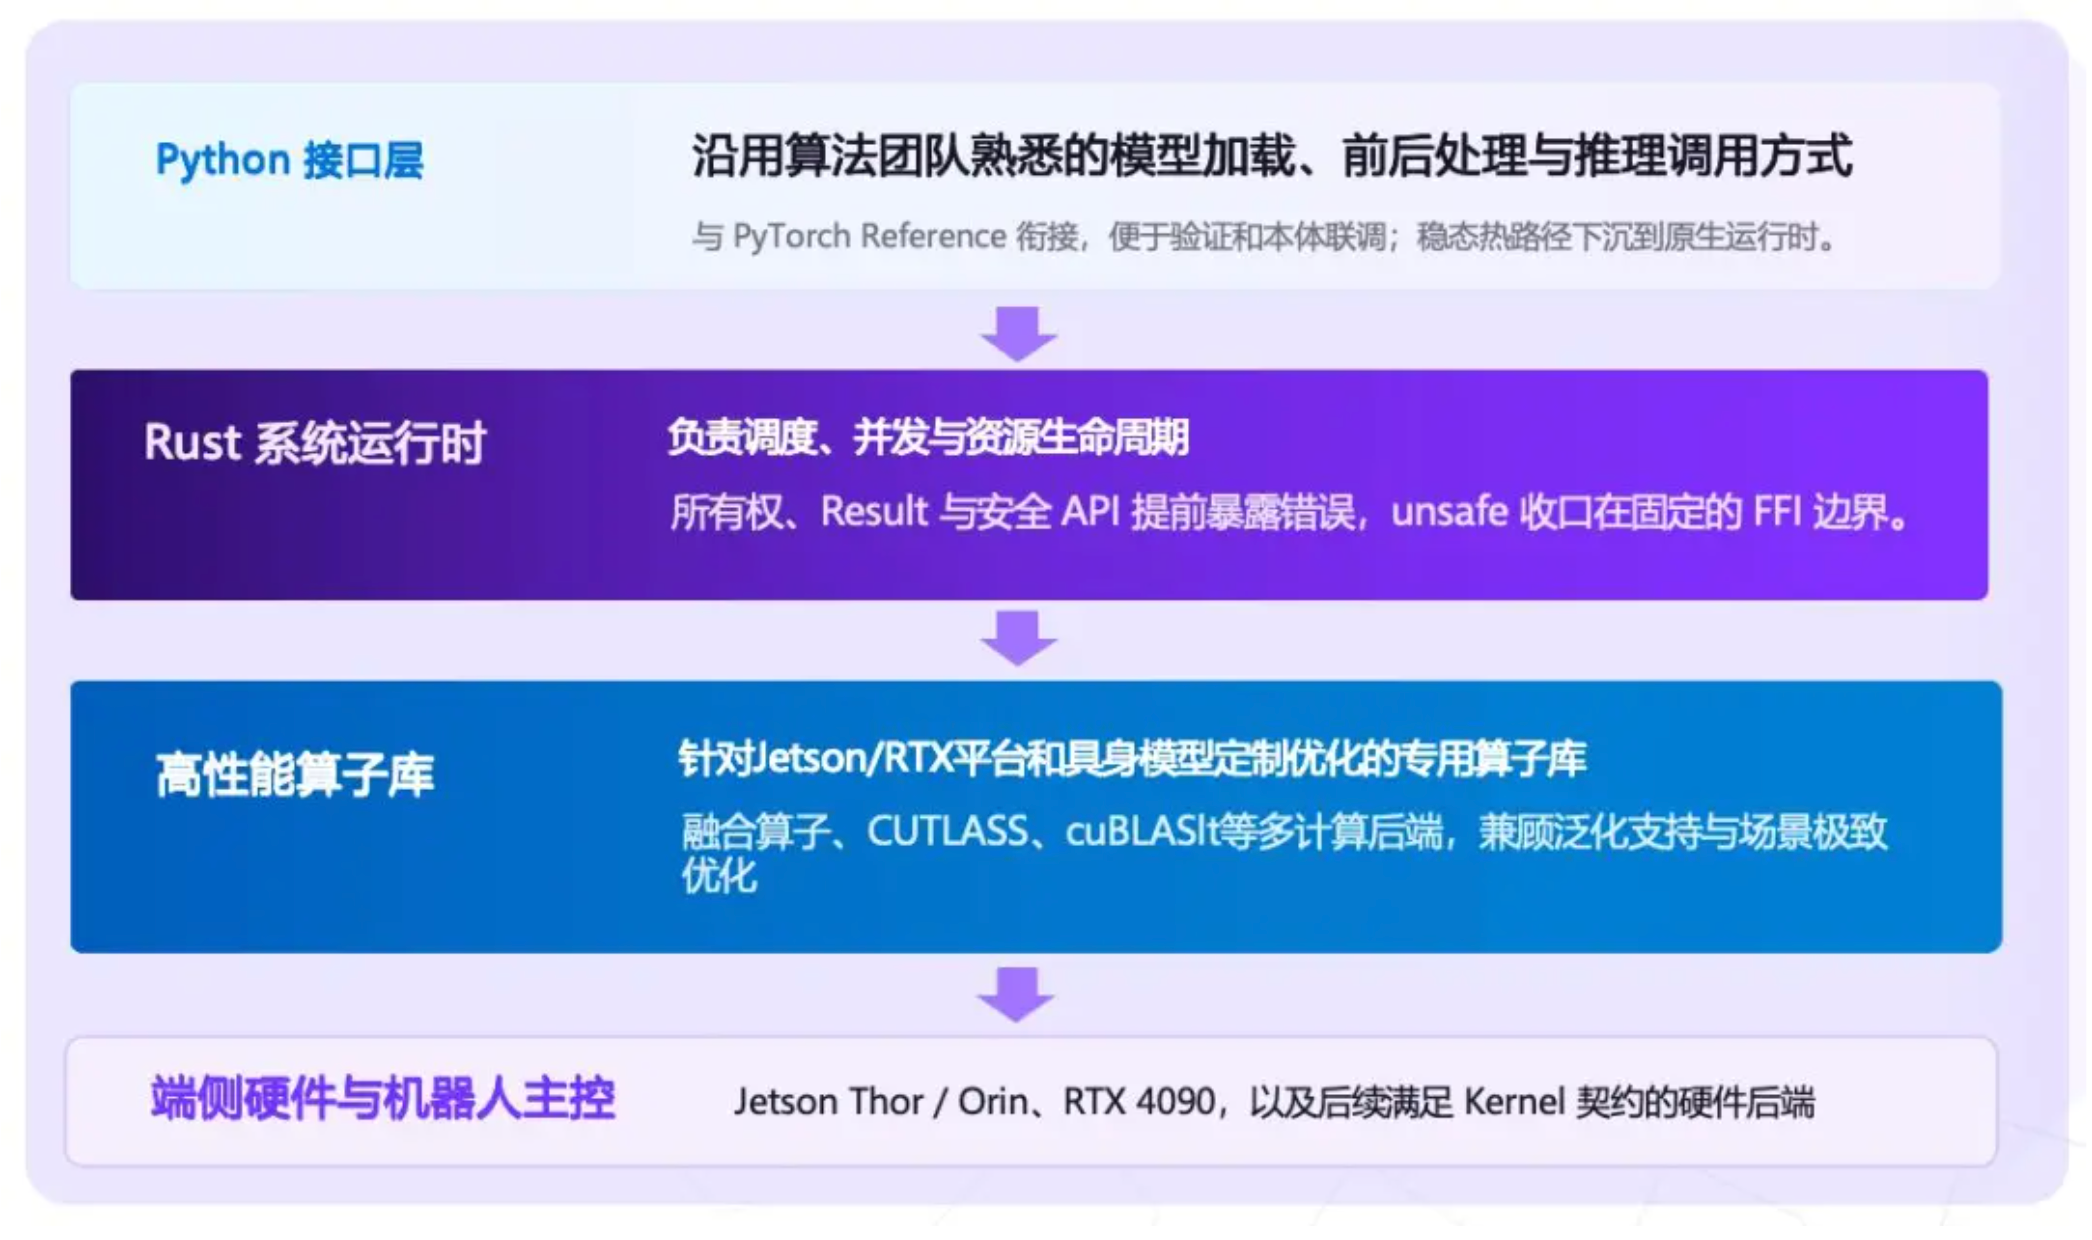
图 1:APXInf 的官方分层示意。Python 接口保持模型加载、前后处理和推理调用的易用性;Rust Runtime 负责调度和资源生命周期;底层算子库针对 Jetson/RTX 和具身模型做优化。
来源:无问芯穹 APXInf 官方介绍。
官方首发重点是 π0.5,并支持 BF16、FP8 和 INT8。官方给出的 π0.5、batch=1、两路视角、10 个 flow steps、action horizon=10 的延迟如下:
| 硬件 | 精度 | 基础延迟 | onestep pruning 后 |
|---|---|---|---|
| Jetson AGX Thor | BF16 | 72.45 ms | 44.05 ms |
| Jetson AGX Thor | FP8 | 41.16 ms | 26.32 ms |
| Jetson AGX Orin | BF16 | 165.67 ms | 119.05 ms |
| RTX 4090 | BF16 | 31.38 ms | 20.36 ms |

图 2:官方给出的优化链路。延迟下降来自融合算子、静态图、CUDA Graph、量化、Kernel 优化和动作生成裁剪的组合,不能简单归因于 Rust 或某一个 CUDA Kernel。
来源:无问芯穹 APXInf 官方介绍。
APXInf 最小验证
下面流程只验证 APXInf 的安装和推理链路,不需要把模型权重提交到教程仓库。命令在 APXinf-robo 仓库根目录、Linux NVIDIA 环境中执行:
bashgit clone --recursive https://github.com/RLinf/APXinf-robo.git
cd APXinf-robo

python3 -m venv .venv
source .venv/bin/activate
pip install maturin

CARGO_TARGET_DIR=target/wheel maturin build --release --features cuda \
  --auditwheel skip -m apxinf/crates/apxinf-py/Cargo.toml
pip install --force-reinstall target/wheel/wheels/apxinf_py-*.whl
pip install -e "./apxinf/python/apxinf[serving]" --config-settings editable_mode=strict
pip install -e ".[serve]"
先做导入检查:
bashpython -c 'import apxinf_py; print(apxinf_py.__version__)'
python -c 'import apxinf_robo; print(apxinf_robo.__version__)'
再用随机权重做运行时 smoke test:
bashpython scripts/bench_pi05.py \
  --random-weights \
  --precision bf16 \
  --layer l1 \
  --views 2 \
  --token-count 10 \
  --action-horizon 10 \
  --num-flow-steps 10 \
  --warmup 10 \
  --samples 30 \
  --autotune
随机权重只证明输入形状、CUDA Kernel、图捕获和计时链路可用,不证明模型成功率。真实评测还需要兼容的 π0.5 checkpoint、norm_stats.json、LIBERO 和 MuJoCo。官方文档建议先跑单任务单回合,再进行完整 LIBERO-10 评测。APXInf LIBERO 文档
4. Embodied.cpp:更偏“具身模型的通用 Runtime”
Embodied.cpp 试图解决的是模型和机器人部署栈碎片化:不同 VLA/WAM 使用不同 Python 代码、后端和机器人 glue code,导致换模型、换设备或换本体时都要重新接线。
论文把 Runtime 拆成五层:
textInput adapters
      ↓
Sequence builders
      ↓
Backbone execution
      ↓
Head plugins
      ↓
Deployment adapters
它的研究重点是多速率执行、batch-1 latency-first inference、融合执行和异构设备部署。相对 APXInf,它的目标更通用:不是只把 π0.5 在某几块 NVIDIA 芯片上做到极致,而是建立一套能承载 VLA/WAM 的可移植 C++ Runtime。
Embodied.cpp 的论文目前是 arXiv 技术报告 2607.02501,本章不把它写成已正式发表的会议论文。它的工程潜力和论文发表状态是两件事。
5. vla.cpp:把 VLA 做成 GGUF/ggml 风格的轻量引擎
vla.cpp 的思路更接近 llama.cpp:把模型转换成自包含 GGUF,在 C++/ggml Runtime 中执行,从而在推理阶段不依赖完整 Python/PyTorch 环境。
它的公开仓库已经覆盖多种策略和后端,包括 π0/π0.5、SmolVLA、BitVLA、Evo-1、OpenVLA-OFT、GR00T 等,并提供 CUDA、CPU、Apple Silicon、SYCL/OpenVINO 等路径。它适合回答下面的问题:
能否用一个轻量、可移植、可打包的 Runtime 统一运行多种 VLA?
| 对比项 | APXInf | vla.cpp |
|---|---|---|
| 主要目标 | 指定具身模型和 NVIDIA 平台的极致端侧性能 | 多模型、多平台、轻量打包 |
| 模型形态 | checkpoint + 专用实现 | GGUF/ggml 自包含 bundle |
| 上层依赖 | Rust/CUDA/Python binding | C++/ggml,推理阶段更轻 |
| 适合场景 | Thor/Orin/RTX 上做深度优化 | 希望减少 Python/PyTorch 运行时依赖 |
| 论文状态 | 目前以项目文档为主 | arXiv:2606.08094,公开页面未标注正式会议/期刊 |
6. Jetson-PI:不只让推理更快,而是让机器人少等
Jetson-PI 的核心不是单纯替换 PyTorch,而是把动作执行和下一次推理并行起来。它提出 Foresight-Aligned Asynchronous Correction:根据已经提交的动作预测未来环境表征,再从未来时刻生成动作,缓解异步推理造成的观测—执行错位。
text当前 action chunk 执行 ───────────────→ 机器人控制器
          │
          └── 后台推理 → 未来校正 → 下一段 action chunk
它还结合置信度调度、CUDA Graph reuse、GPU-resident buffer 和 flow unrolling。官方论文报告在 Jetson Orin 上,相比朴素 PyTorch 和 vla.cpp,控制频率分别提升 8.66× 和 5.41×;这个结果同时包含算法、调度和系统优化,不能直接当成某个 Runtime 的裸模型速度。Jetson-PI 论文
Jetson-PI 的官方仓库标注为 Accepted at CoRL 2026。这里把“官方仓库标注的接收信息”和 arXiv 页面区分开写,便于后续论文状态更新。
7. EVA-Client:模型推理之后的真机执行层
EVA-Client 不应归类为 CUDA 推理引擎。它位于策略服务和实体机器人之间,负责:
- ROS1、ROS2、ZeroMQ 和离线数据回放;
- OpenPI、OpenPI-RTC、StarVLA、GR00T 等 policy backend;
- sync、async、naive、ACT ensemble 和 RTC;
- action buffer、延迟补偿、EEF/Joint action 转换和 IK;
- Debug、Collect、Eval、Replay;
- 同时记录原始策略输出、平滑后动作和实际下发动作。
这类框架解决的是“模型已经能输出动作,但真实机器人为什么仍然停顿、抖动、错位或无法复盘”。它和 APXInf 是互补关系:APXInf 可以作为模型推理后端,EVA-Client 负责把输出接到机器人并形成数据闭环。EVA-Client 技术报告
8. ROSA:从单机端侧推理走向机器人集群 Serving
ROSA: A Robotics Foundation Model Serving System for Robot Factories 讨论的是另一种部署形态:工厂里有很多机器人,但不一定每台机器人都配一块高性能 GPU。
text机器人集群
   ↓ 网络请求
共享 GPU Pool / Ray Serve
   ↓
多模型推理与机器人感知调度
它关注共享 GPU 池、多模型流水线、任务级性能要求和故障处理,目标是优化整个工厂的生产率,而不是只优化某一台机器人的单次 latency。它和 APXInf 的关系是边缘与云端的互补:机器人端可以用 APXInf,机房侧可以用 ROSA 一类 Serving 系统。
ROSA 的公开论文条目是 arXiv:2607.01088,该页面目前不等于正式会议或期刊发表证明。
9. RLinf、OpenPI 和 TensorRT 放在哪里
RLinf:训练和 rollout 基础设施
RLinf 支持具身强化学习、仿真、rollout、分布式执行以及多种模型后端。它可以通过 APXinf-robo 调用 APXInf 做 π0.5 评测,但这不意味着 RLinf 本身就是端侧推理引擎。
一个清晰的组合方式是:
textRLinf:训练 / 强化学习 / rollout / 评测
  ↓ checkpoint
APXInf 或 vla.cpp:模型端侧推理
  ↓ action chunk
EVA-Client 或自研客户端:异步执行、IK、记录和真机评测
OpenPI:模型和策略参考实现
OpenPI 提供 π0/π0.5 的模型、数据变换、训练和策略服务参考实现。APXInf、vla.cpp、Jetson-PI 和 EVA-Client 都可以在不同层面与 OpenPI 对接。OpenPI 解决“模型如何定义和调用”,不等于已经解决所有硬件上的极致部署问题。
TensorRT / Isaac ROS:工业部署底座
TensorRT、TensorRT-LLM 和 Isaac ROS 不是专门针对 VLA 的单一 Runtime,但在 NVIDIA 机器人生态里很重要。固定模型、固定硬件和明确输入形状时,TensorRT/NVFP4/FP8 路线可能获得很低延迟;Isaac ROS 则提供 ROS 侧的硬件加速组件和系统集成。
这条路线和 APXInf 不应简单二选一:APXInf 可以把 VLA 的采样、action horizon、policy 接口和机器人部署约束整合起来,而 TensorRT 负责通用图优化和硬件后端。最终应在同一模型、同一输入、同一 flow steps、同一温度和同一统计口径下实测。
10. 按需求选方案
表 2 选型建议
| 需求 | 优先阅读/尝试 | 原因 |
|---|---|---|
| π0.5 在 Jetson Thor/Orin 上追求端到端低延迟 | APXInf、TensorRT on Thor | 现成的 NVIDIA 端侧优化路径 |
| 推理慢但控制不能停顿 | Jetson-PI、OpenPI-RTC、EVA-Client | 通过异步执行、前瞻校正或 RTC 隐藏延迟 |
| 多个 VLA/WAM、多个硬件平台统一接入 | Embodied.cpp、vla.cpp | 更重视 Runtime 抽象和可移植性 |
| 真机采集、评测、回放、失败分析 | EVA-Client | 把部署和数据闭环放在同一套客户端里 |
| 多台机器人共享服务器 GPU | ROSA | 目标是 fleet/factory 级 Serving |
| 训练、强化学习和大规模 rollout | RLinf | 端侧 Runtime 不是它的主职责 |
| 想先复现 π0/π0.5 模型行为 | OpenPI | 模型、变换和策略服务参考最直接 |
11. 这类系统应该怎么比较
不要只比较一个“推理速度”数字。至少要分别记录:
- Runtime latency:固定输入和固定采样步数下的模型执行时间;
- Policy latency:包括 resize、tokenize、normalization、采样和 unnormalization;
- Transport latency:进程间通信和网络往返;
- Control frequency:动作实际下发频率,以及异步策略下的有效频率;
- Task success:相同 checkpoint、相同 seed、相同任务集上的成功率;
- 长期稳定性:显存、内存、队列、线程和异常恢复;
- 迁移成本:换模型、换硬件、换本体时是否需要重写 Runtime。
一个 26 ms 的裸模型结果,不一定比一个 40 ms 但能持续异步执行、支持失败恢复和可复盘的系统更适合真实机器人。反过来,一个部署客户端也不能因为控制频率高,就被称为底层推理引擎。
12. 本章小结
具身智能推理基础设施正在形成几个互补方向:
text模型和训练:OpenPI、RLinf
        ↓
端侧 Runtime:APXInf、Embodied.cpp、vla.cpp、TensorRT
        ↓
异步控制:Jetson-PI、OpenPI-RTC
        ↓
真机闭环:EVA-Client、ROS/机器人控制器
        ↓
集群 Serving:ROSA
APXInf 的价值是把 NVIDIA 端侧的具身模型推理做深;Embodied.cpp 和 vla.cpp 更关注通用 Runtime;Jetson-PI 解决推理与控制的时间错位;EVA-Client 解决真机执行和数据闭环;ROSA 则把问题扩展到机器人集群。它们共同说明,具身智能的“推理”已经不只是一次 Transformer forward,而是模型、调度、硬件和机器人控制共同组成的系统问题。