
VisualThink-VLA:用视觉证据思考再行动
本文导读 VisualThink-VLA: Visual Intermediate Reasoning for Effective and Low-Latency Vision-Language-Action Policies。论文 arXiv 编号为
2605.30011v1,2026 年 5 月 28 日提交。作者包括 Mingjian Gao、Wenqiao Zhang、Yuqian Yuan、Yang Dai、Binhe Yu、Zheqi Lv、Haoyu Zheng、Jiaqi Zhu、Zhiqi Ge、Zixuan Wan、Siliang Tang、Yueting Zhuang。
1. 先说结论:它为什么值得放进 VLA 章节
VisualThink-VLA 讨论的是 VLA 里一个很现实的问题:机器人到底应该怎样“先想一下再行动”。
近年的 VLA 推理增强路线经常让模型先生成文字 Chain-of-Thought,再根据文字推理输出动作。这在离线评测里看起来很自然,但放到闭环机器人控制里会出现两个问题。
第一,文字推理不一定适合空间操作。机器人要抓红色碗、避开干扰物、沿边缘接触、判断物体相对关系时,真正关键的信息往往是位置、边界、运动和空间关系,而不是一大段自然语言解释。自由文本 CoT 可能把无关描述带进动作预测,反而干扰控制。
第二,文字 CoT 有明显延迟。论文报告 ECoT 在 BridgeData V2 上单步延迟为 8.377s,VisualThink-VLA 则把延迟降到 0.367s,达到约 22.8x 加速。对真实机器人来说,这不是小优化:多秒级推理很难闭环控制,亚秒级才更接近可部署策略。
VisualThink-VLA 的核心判断是:
text机器人不一定要用文字思考。
更合适的中间推理形式,是紧凑、可路由、可审计的视觉证据。
因此它不是世界模型,也不是重新训练一个全新的 VLA 基座。它更像是给冻结 VLA 加一个 视觉证据中间层:
textRGB 当前帧 + 上一帧 + 语言指令
    -> 提取 bbox / edge / motion / relation 等视觉证据
    -> router 选择当前动作真正需要的证据通道
    -> Visual State Composer 把证据变成轻量 soft states
    -> 冻结 VLA backbone 在这些视觉证据条件下预测动作
所以它应该放在 06-策略抓取或抓取VLA/大模型控制、VLA、VLM,接在 LWD 后面。它和 EventVLA、G0.5、PRTS、LWD 属于同一条“让 VLA 不只做直接行为克隆”的方法线,但它的切入点是 视觉中间推理的效率和可审计性。
2. 论文、代码和复现入口
| 条目 | 链接 | 当前状态 |
|---|---|---|
| 论文 | arXiv:2605.30011 / HTML / PDF | 2026-05-28 提交 |
| GitHub | DCDmllm/VisualThink-VLA | 官方代码仓库,MIT License |
| 代码状态 | GitHub README 写明 2026-05 初始公开 code skeleton | 包含 evidence extraction、router training、adapter training、VisualEvidence-Set 构建和评测脚本 |
| 大资产 | README 写明不把 OpenVLA checkpoint、感知模型缓存、原始机器人数据、特征 manifest、训练 checkpoint 和评测日志放进仓库 | 复现时需要外部准备模型和数据路径 |
当前最适合的学习方式是:先读方法,跑通代码仓库里的轻量 pipeline 结构,理解证据提取、router、adapter 和 audit 是怎样连接的。完整复现论文里的全部 benchmark 和真实机器人结果,需要 OpenVLA/Prismatic、LIBERO、SAM2、Grounding DINO、Qwen2.5-VL、机器人数据、训练好的 router/adapter checkpoint 和评测环境,不能理解成一条命令直接得到论文表格。
3. 总览图:用视觉证据替代长文本 CoT
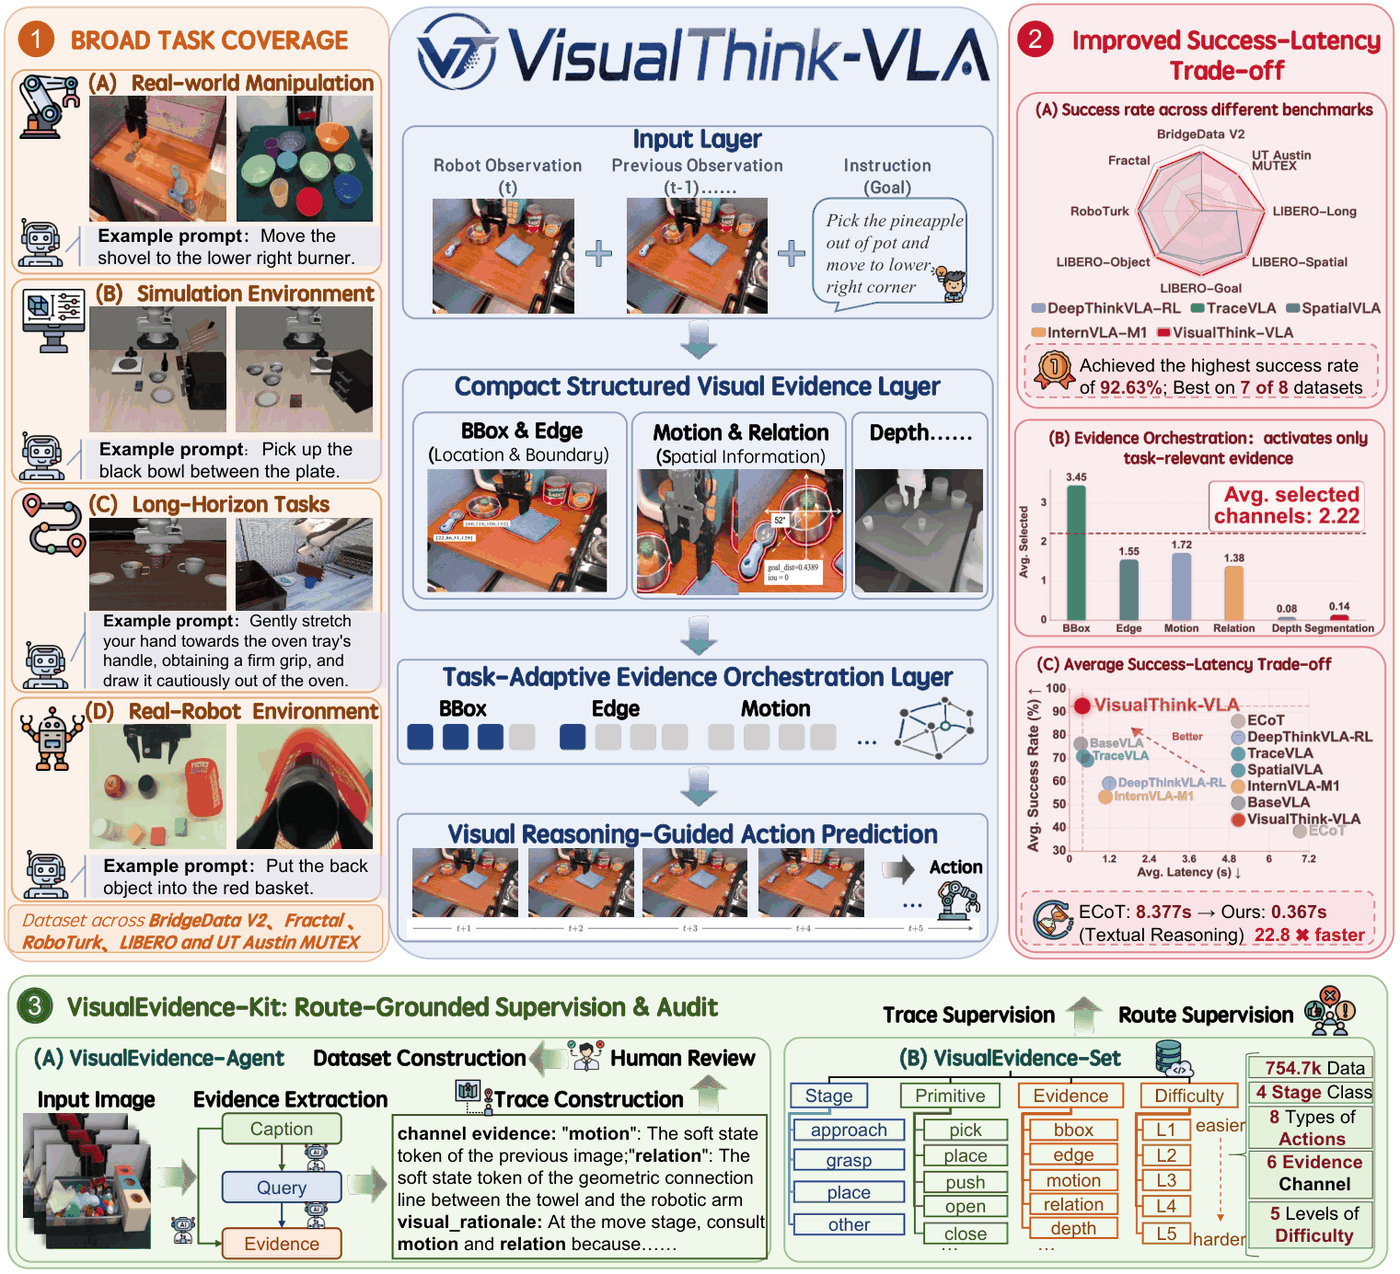
图 1 VisualThink-VLA 总览。 左侧说明它覆盖多类 manipulation 场景;中间给出成功率和延迟的权衡;右侧展示 VisualEvidence-Kit 如何构造 route-grounded 监督和审计数据。
来源:DCDmllm/VisualThink-VLA 官方仓库。
这张图可以从三个层次理解。
第一层是 任务动机。VLA 在真实操作里经常遇到多物体干扰、空间关系、接触几何、长时程阶段变化。直接从图像到动作当然可以做,但当场景复杂时,策略需要某种“中间依据”来知道当前动作应该依赖哪个视觉线索。
第二层是 效率约束。如果中间依据是长文本 CoT,推理会变慢;如果中间依据是完整分割图、深度图、密集 side cue,又可能把冗余或错误信息塞给 action decoder。VisualThink-VLA 选择的是折中路线:只保留紧凑视觉证据,并且每一步只激活需要的证据通道。
第三层是 可审计性。它不是把视觉证据全部压成一个不可解释 latent,而是保留 route mask 和 channel-grounded trace。这样可以问:这一步策略到底看了 bbox、edge、motion 还是 relation?如果把某个通道 counterfactual 移除,动作是否真的受影响?这比事后生成一句好听的自然语言解释更接近机器人控制里的 faithfulness。
4. 方法图:六个候选通道,四个部署通道
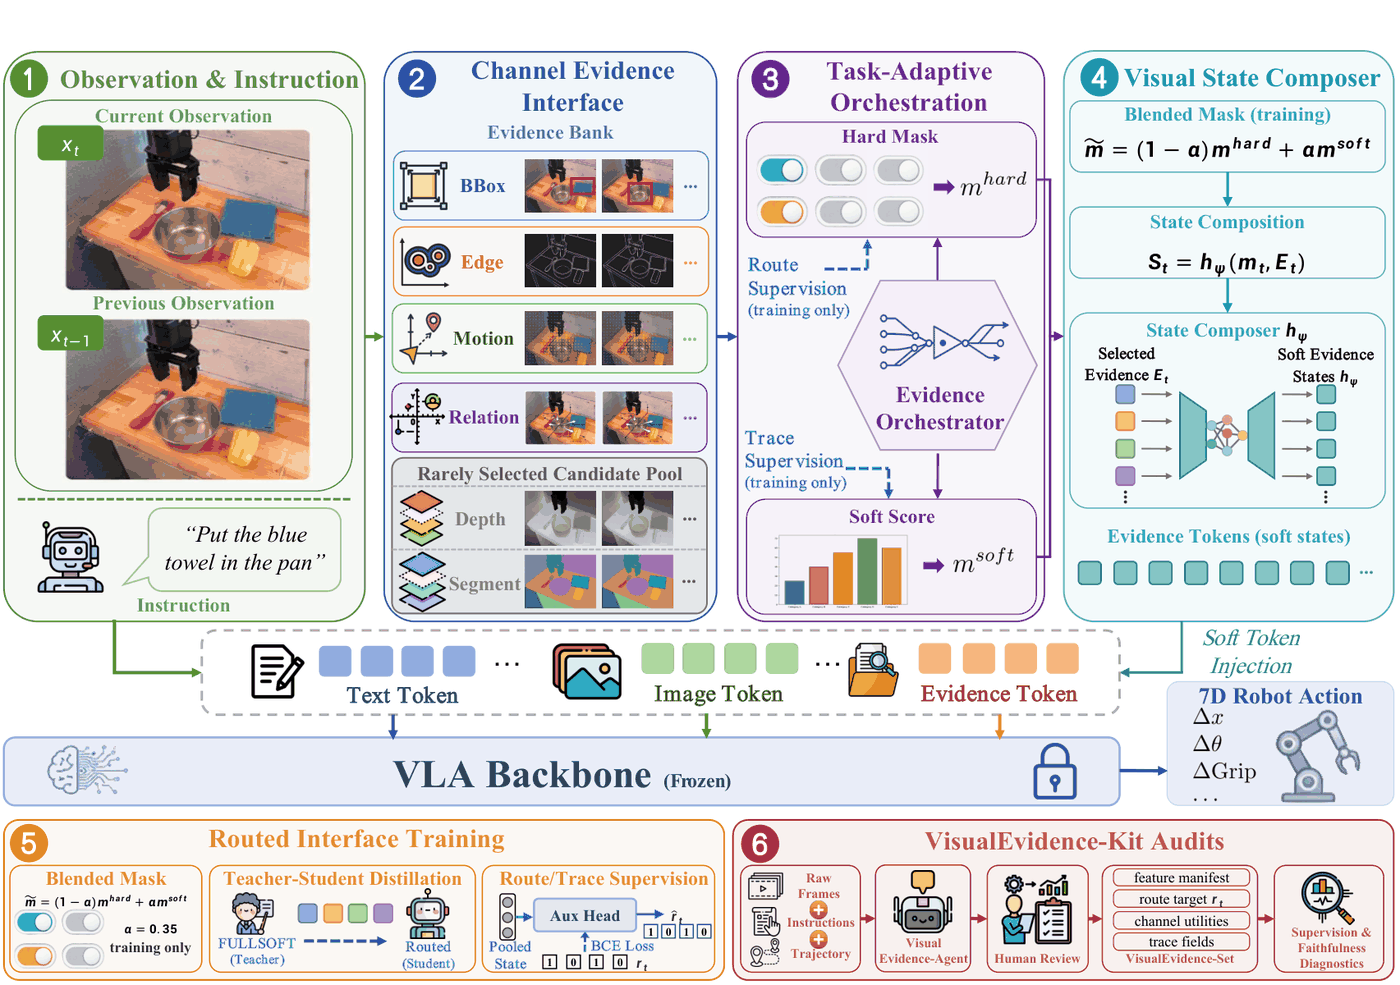
图 2 VisualThink-VLA 架构。 系统先从当前帧、上一帧和语言指令提取六类候选视觉证据;经过 channel screening 后保留四个部署通道;router 根据当前决策选择证据;Visual State Composer 把 routed evidence 注入冻结 VLA backbone。虚线表示训练时使用、推理时不需要的监督路径。
来源:DCDmllm/VisualThink-VLA 官方仓库。
论文里最关键的设计是 Visual Evidence Interface。它先构造六类候选证据:
| 通道 | 作用 | 直观例子 |
|---|---|---|
bbox |
目标位置和检测框 | 多物体抓取时定位红碗、蓝杯、目标方块 |
edge |
边界和接触几何 | 插入、推拉、沿边缘接触、旋转时估计物体轮廓 |
motion |
短时程变化 | 判断物体是否被推动、是否已经移动、当前阶段是否变化 |
relation |
指令相关空间关系 | “放到盒子左边”“把杯子放进盘子里” |
depth |
单目几何深度 | 估计前后距离和局部几何 |
segment |
物体区域 mask | 分割目标区域和干扰区域 |
但最后部署时不是六个都用。论文的 channel screening 发现 depth 和 segment 在他们的 benchmark 设置中收益较低、开销较高,容易增加 side-perception overhead。因此最终 operational evidence bank 保留四个通道:
textbbox + edge + motion + relation
这就是 VisualThink-VLA 的“少即是多”:不是把所有感知结果都塞给 VLA,而是让 router 在每一步选择当前最需要的视觉证据。比如靠近目标时可能更依赖 bbox;接触和重定向时更依赖 edge / motion;处理“左边、里面、旁边”这类指令时更依赖 relation。
5. 冻结 VLA backbone:它不是重新训练一个大基座
GitHub README 明确写到,VisualThink-VLA keeps the base VLA frozen。这个点很重要。
很多 VLA 改进方法会重新 fine-tune 大量 backbone 参数,成本高,也容易把原本的泛化能力冲掉。VisualThink-VLA 的做法更像一个外挂式视觉推理层:
textFrozen VLA backbone
    + evidence extractor
    + task-adaptive router
    + Visual State Composer / routed adapter
    -> action prediction
其中 evidence extractor 负责把原始观测变成紧凑证据向量;router 负责选择通道;Visual State Composer 负责把 routed channel vectors 投影成少量 learned visual states,并插入到 action decoding 前。推理时它不生成文字,不调用在线图像编辑模型,也不需要输出人类可读长解释。
这也是它和 G0.5 / CoT VLA 的区别。G0.5 把结构化 CoT 和 action tokens 放进自回归流;VisualThink-VLA 则尽量避免文字 token 解码,把中间推理放在视觉证据 token / soft states 上。
6. Task-Adaptive Router:不是固定看所有证据
VisualThink-VLA 的 router 预测每个证据通道的选择概率,再通过 hardening operator 转成推理时的硬路由 mask。也就是说,它每一步不是固定打开四个通道,而是动态选择。
训练时直接用硬路由会比较脆,所以论文采用 soft-hard collaborative masks:训练阶段混合 soft / hard route,推理阶段使用 hard route。为了让稀疏路由继承 dense evidence 的能力,VisualThink-VLA 还训练一个 FullSoft teacher。FullSoft 每步看四个部署通道,VisualThink-VLA student 则在 router 选择的稀疏通道上学习,并通过 teacher-student distillation 保留性能。
这个设计解决的是一个具体矛盾:
textDense evidence:
    信息充分,但慢,且可能引入干扰。

Sparse routed evidence:
    快,干扰少,但训练不稳、容易漏掉关键信息。

FullSoft teacher + routed student:
    用 dense teacher 提供容量,再让 sparse student 学会按需选择。
论文结果也支持这个判断:VisualThink-VLA 在内部对比里平均成功率 90.10%,平均延迟 0.395s;FullSoft 平均成功率 89.83%,平均延迟 0.470s。这说明稀疏路由不只是省计算,还在平均成功率上略高于 dense teacher,原因可能是过滤了部分无关或冲突证据。
7. VisualEvidence-Kit:监督和审计不是自由文本解释
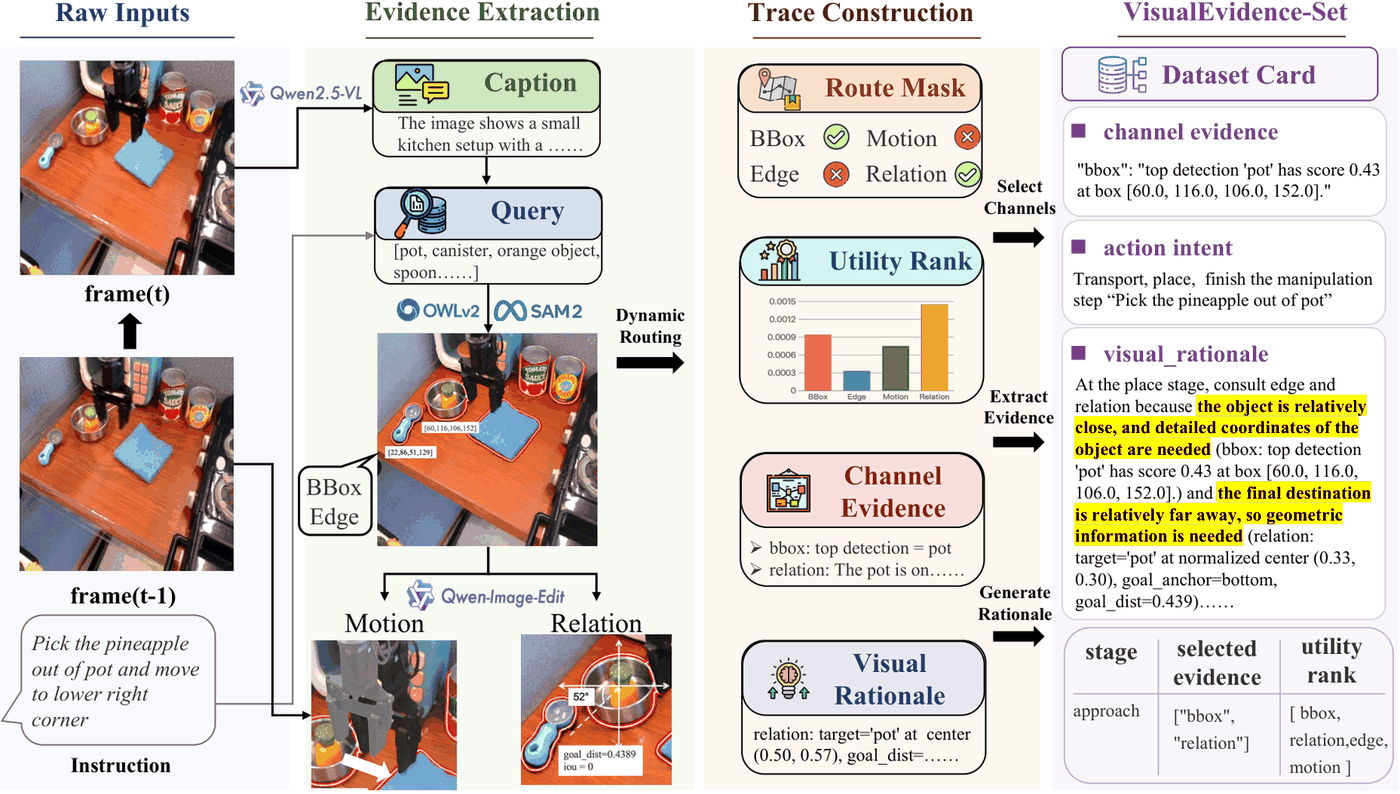
图 3 VisualEvidence-Kit 工作流。 VisualEvidence-Agent 从机器人轨迹中提取候选视觉证据、评估通道 utility、构造 channel-grounded trace,并经过人工审查生成可用于 router 训练和 faithfulness 审计的 VisualEvidence-Set。
来源:DCDmllm/VisualThink-VLA 官方仓库。
VisualEvidence-Kit 是这篇论文很值得注意的部分。很多“可解释机器人策略”容易只做事后解释:策略先输出动作,再让语言模型编一段解释。这种解释未必真的参与了动作决策。
VisualThink-VLA 反过来要求证据路径可审计。VisualEvidence-Agent 做四件事:
- Evidence extraction:对每个决策上下文提取候选通道特征。
- Route and utility assessment:估计每个通道对当前动作的 route target 和 counterfactual utility。
- Trace construction:记录 manipulation stage、primitive、evidence dependence、difficulty 和 selected evidence,形成结构化 channel-grounded trace。
- Human review:人工检查一致性,过滤不可靠标签。
最终 VisualEvidence-Set 包含 754.7k 条 visual-thinking VLA instructions,可用于 route supervision、trace-supervised adapter refinement 和 counterfactual faithfulness tests。论文强调,这些 trace 在训练和审计时使用,推理时不需要 VisualEvidence-Agent,也不需要生成 trace 字段。
对教程来说,这一点要讲清楚:VisualEvidence-Kit 不是机器人在线控制时跑一个很重的解释器,而是一个 构造监督与验证路由是否可信的数据工具链。
8. Channel Screening:为什么删掉 depth 和 segment
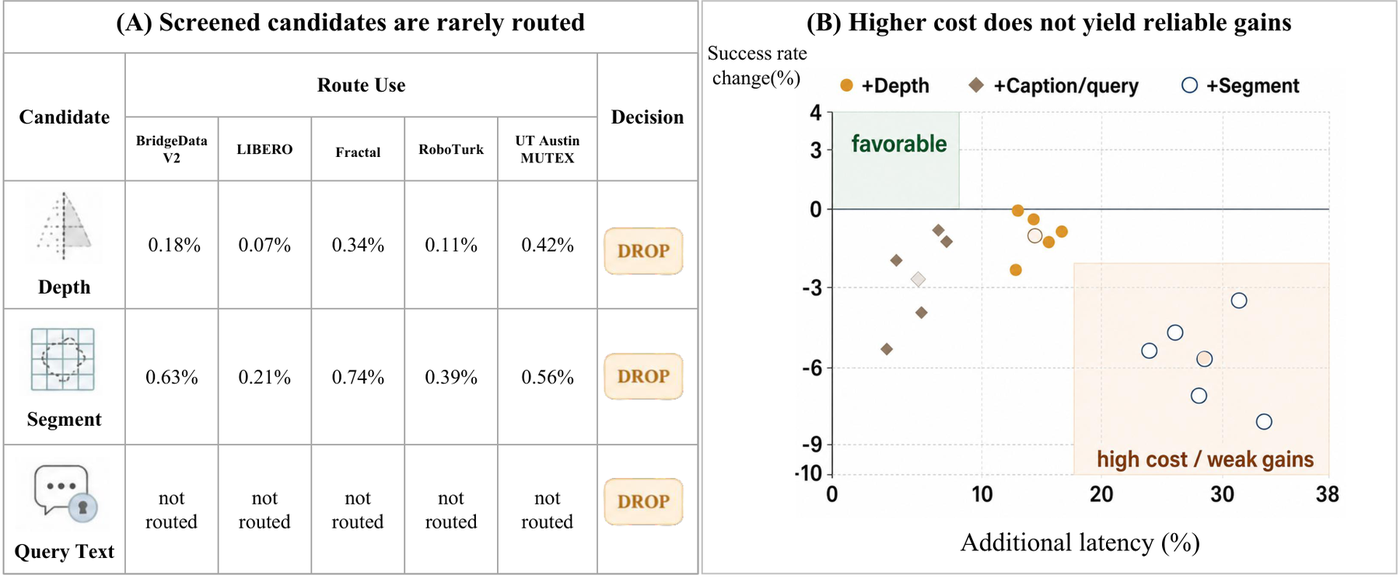
图 4 证据通道筛选。 初始候选包含六类证据,但论文筛选后保留 bbox / edge / motion / relation 四个部署通道;depth 和 segment 可以用于诊断或筛选,不属于默认 operational interface。
来源:DCDmllm/VisualThink-VLA 官方仓库。
机器人视觉里很容易有一个直觉:深度、分割、检测、运动、关系全都给模型,信息越多越好。VisualThink-VLA 的实验说明这个直觉不总是成立。
原因有三类。
第一,额外通道会增加感知开销。实时控制里每一步都跑深度估计、分割、检测和关系推理,会把 latency 堆起来。
第二,额外通道会带来噪声。分割边界错误、深度估计漂移、遮挡下的目标 mask 错误,都可能误导 action decoder。
第三,证据之间会竞争。动作解码器看到太多辅助 token,可能分散对真正关键证据的注意力。比如多物体 pick-place 主要需要 bbox 和 relation,接触敏感重定向主要需要 edge / motion,把低效通道一并塞进去不一定更好。
因此 VisualThink-VLA 的路线不是“多模态信息越多越强”,而是 通过筛选和路由找到足够小但有效的视觉证据接口。
9. 实验结果:强在成功率和延迟同时看
论文最有代表性的结果有四类。
第一是多 benchmark 控制对比。VisualThink-VLA 在 BridgeData V2、Fractal、RoboTurk、LIBERO-Object、LIBERO-Goal、LIBERO-Spatial、LIBERO-Long 和 UT Austin MUTEX 上评测。相比 matched BaseVLA re-evaluation,它在 8 个 benchmark 中有 7 个成功率提升。BridgeData V2 上,BaseVLA 是 75.37% / 0.345s,VisualThink-VLA 是 89.49% / 0.367s;ECoT 是 85.09% / 8.377s。这说明它不是单纯用更长推理换成功率,而是在接近 BaseVLA 延迟的区域增加视觉中间推理。
第二是 backbone portability。论文在 VisualEvidence-Set test split 上测试 OpenVLA、Octo、SmolVLA 三个基座。VisualThink-VLA 分别带来 +16.37、+10.87、+11.95 成功率提升,延迟只增加约 0.05s 到 0.10s。这支持它作为 plug-and-play visual reasoning layer,而不是 OpenVLA 专属改造。
第三是内部接口对比。Prompt-text evidence 能提升成功率,但平均延迟达到 1.428s;Heavy dense evidence 平均延迟 0.592s;FullSoft 为 0.470s;VisualThink-VLA 为 0.395s,平均成功率 90.10%。这个结果说明结构化视觉证据比自由文本证据更适合低延迟控制,稀疏路由又比密集 side cue 更有效率。
第四是真机闭环评估。论文使用 PIPER NERO 7-DoF 机械臂和固定外部 RGB 相机,覆盖 multi-object pick-place、relation-sensitive placement、contact-sensitive reorientation、two-stage compositional task 四类任务。VisualThink-VLA 在四类任务上都超过 BaseVLA,并在三类任务上超过 FullSoft;平均完成时间 25.6s,低于 FullSoft 的 30.2s,平均只选择 1.83 个证据通道。
这些结果说明 VisualThink-VLA 的核心价值不是“多一个解释模块”,而是给 VLA 找到一个更实际的中间推理接口:足够视觉化、足够紧凑、足够快,并且能被审计。
10. 代码仓库怎么读
官方仓库当前给出了研究 pipeline。建议按下面顺序读。
第一步看证据提取:
bashgit clone https://github.com/DCDmllm/VisualThink-VLA
cd VisualThink-VLA

conda create -n visualthink-vla python=3.10 -y
conda activate visualthink-vla
pip install -r requirements.txt
pip install -e .

python scripts/extract_visual_evidence.py \
  --image_path path/to/current.png \
  --prev_image_path path/to/previous.png \
  --instruction "pick up the red bowl" \
  --output_dir outputs/evidence_one
这个命令的目标不是复现论文指标,而是看清楚单帧当前图、上一帧和语言指令如何变成 visual evidence。它能帮助理解 bbox / edge / motion / relation 这些通道在代码里是什么格式。
第二步看 router:
bashpython scripts/train_evidence_router.py \
  --feature_manifest outputs/features/feature_manifest.jsonl \
  --config configs/evidence_router.yaml \
  --output_dir outputs/router
router 训练依赖 feature manifest 和 route supervision。没有完整 VisualEvidence-Set 时,可以先读配置和脚本,理解输入字段、输出 checkpoint 和 route mask 的数据流。
第三步看 FullSoft 和 VisualThink-VLA adapter:
bashpython scripts/train_visualthink_adapter.py \
  --mode full \
  --feature_manifest outputs/features/feature_manifest.jsonl \
  --model_path path/to/openvla \
  --config configs/visualthink_adapter.yaml \
  --output_dir outputs/fullsoft

python scripts/train_visualthink_adapter.py \
  --mode visualthink \
  --feature_manifest outputs/features/feature_manifest.jsonl \
  --model_path path/to/openvla \
  --config configs/visualthink_adapter.yaml \
  --gate_checkpoint_dir outputs/router \
  --teacher_adapter_dir outputs/fullsoft \
  --output_dir outputs/visualthink
这里要注意,path/to/openvla、perception checkpoint、数据 manifest 和训练产物都不应该放进教程仓库。官方 README 也强调这些大资产应保存在 Git 仓库外部,并通过命令行参数传入。
第四步看 VisualEvidence-Set 和审计:
bashpython scripts/build_visualevidence_set.py \
  --feature_manifest outputs/features/feature_manifest.jsonl \
  --gate_checkpoint_dir outputs/router \
  --visualthink_checkpoint_dir outputs/visualthink \
  --output_path outputs/visualevidence/visualevidence_set.jsonl

python scripts/audit_faithfulness.py \
  --feature_manifest outputs/features/feature_manifest.jsonl \
  --model_path path/to/openvla \
  --visualthink_checkpoint_dir outputs/visualthink \
  --evidence_trace_manifest outputs/visualevidence/visualevidence_set.jsonl \
  --output_dir outputs/audit
这部分的学习重点是 faithfulness audit:路由出来的证据是否真的影响动作,而不是只作为后验解释。
11. 和其他 VLA 推理方法的关系
| 方法 | 中间推理形式 | 优点 | VisualThink-VLA 的区别 |
|---|---|---|---|
| ECoT / text CoT | 自回归文字推理 | 解释直观 | 延迟高,文本可能弱视觉 grounding |
| TraceVLA / SpatialVLA | 图像或空间中间信息 | 更贴近视觉空间 | 可能引入较多 dense side cue |
| Galaxea G0.5 | 结构化 CoT + action token 流 | 推理和动作统一在自回归序列里 | VisualThink-VLA 避免长文本解码,用视觉 soft states 条件化动作 |
| EventVLA | 长时域视觉证据记忆 | 解决长时程视觉证据遗忘 | VisualThink-VLA 关注单步决策所需证据通道路由 |
| PRTS | 目标可达性 / CRL 预训练 | 让 VLA 有 goal-reachability awareness | VisualThink-VLA 关注视觉证据接口和低延迟控制 |
| LWD | 真机部署后 offline-to-online RL | 用真实部署数据持续改进 policy | VisualThink-VLA 关注推理接口,LWD 关注部署数据飞轮 |
可以把 VisualThink-VLA 放在“视觉推理 VLA”这条线里读:它不是让模型说更多话,而是让模型在行动前看对东西。
12. 推荐组队学习题目
在 Task04 里可以这样布置:
对比 EventVLA、G0.5 和 VisualThink-VLA:EventVLA 强调长时域视觉证据记忆,G0.5 强调结构化 CoT 与 action token 流,VisualThink-VLA 强调低延迟 routed visual evidence。请说明三者分别解决 VLA 的哪个瓶颈,并分析文字 CoT、视觉证据 token 和动作 token 的取舍。
交付可以不跑完整训练,但要回答:
- VisualThink-VLA 为什么认为 textual CoT 不适合实时机器人控制?
- 六个候选通道为什么最后只保留四个?
FullSoftteacher 和 routed student 各自解决什么问题?- VisualEvidence-Kit 为什么强调 counterfactual faithfulness?
- 代码仓库当前可以复现哪些 pipeline,哪些还依赖外部模型/数据/checkpoint?
13. 资料来源
本文图片来自 DCDmllm/VisualThink-VLA 官方仓库,为了教程稳定访问已保存到本地 assets/。文字内容参考 arXiv:2605.30011、arXiv HTML 和官方 GitHub README。