
HumanoidMimicGen:用全身规划把少量人形示教扩成大规模操作数据
这篇导读对应 NVIDIA、UT Austin 等作者的论文 HumanoidMimicGen: Data Generation for Loco-Manipulation via Whole-Body Planning。它适合放在本仓库的 10-具身智能其他仿真工具及仿真前沿 章节中,接在 SIM1、InternDataEngine、UniLab + MotrixSim 之后,作为“仿真数据生成 + 人形机器人全身操作”的前沿方法补充。
一句话概括:
HumanoidMimicGen 不是一个新的 VLA 基座,也不是一个纯视觉世界模型,而是一个面向人形机器人 loco-manipulation 的数据生成系统:从少量、甚至单条遥操作示教出发,把示教拆成带约束的技能片段,再用全身 IK、运动规划、腿部运动控制器和技能重放,把同一个任务扩展到大量不同物体位置、机器人初始位姿和场景布局中。
它的关键价值在于解决“人形机器人既要走路又要操作时,示教数据太贵”的问题。固定机械臂的数据扩增方法可以只管末端执行器,但人形机器人多了腿、躯干、平衡、步态和长时域导航,不能简单把手臂轨迹平移一下就复用。HumanoidMimicGen 的核心贡献就是把“示教复用”升级成“示教技能 + 全身规划 + 运动控制”的组合系统。
1. 论文、项目页和开源状态
| 项目 | 信息 |
|---|---|
| 项目页 | humanoidmimicgen.github.io |
| 论文 | arXiv:2605.27724,提交于 2026-05-26 |
| arXiv HTML | HumanoidMimicGen HTML |
| 机构 | NVIDIA、The University of Texas at Austin |
| 机器人 | 主要实验使用 Unitree G1 形态的人形机器人 |
| 仿真栈 | 论文描述的 benchmark 基于 MuJoCo 和 robosuite;运动规划细节中使用 cuRobo 做 GPU 加速碰撞检测与批量 IK |
| 策略学习 | 仿真策略实验里微调 GR00T N1.6 VLA;真实机器人实验里使用 flow matching policy 做 sim-and-real co-training |
| 代码 | 截至 2026-07-18,官方项目页未提供 GitHub/Code 链接 |
| 相关开源入口 | NVlabs/mimicgen 是原始 MimicGen 的官方仓库,可用于理解“少量示教扩增”谱系 |
这里需要特别说明:用户现在如果想完整复刻 HumanoidMimicGen 论文结果,最理想的路径还是等官方代码、benchmark 环境和数据生成脚本发布。当前教程的定位是方法导读和复现路线预埋,不把它写成已经可以一键跑通的工程教程。读者可以先学习 MimicGen / DexMimicGen / robosuite / MuJoCo / cuRobo 的相关接口,等官方仓库放出后再补齐运行步骤。
2. 官方效果预览
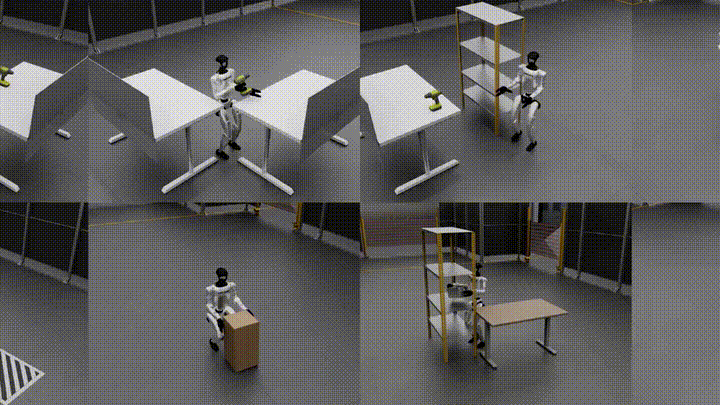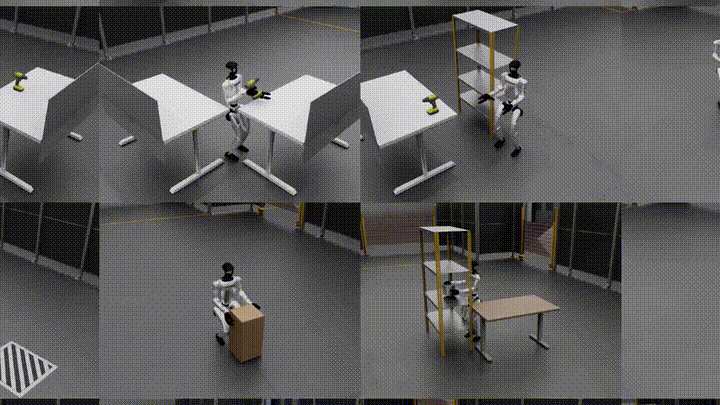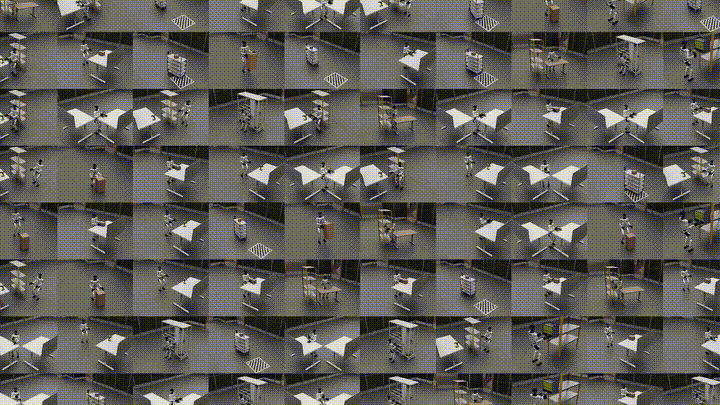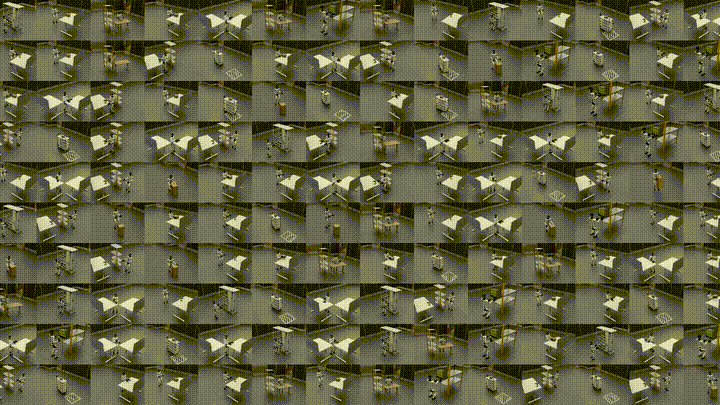
图 1 HumanoidMimicGen 官方 teaser 视频转 GIF。 项目页展示的核心效果是:从少量遥操作示教出发,自动生成大量人形机器人在不同布局下完成搬运、推柜、拿钻头、绕障碍取物等任务的示教轨迹。
来源:HumanoidMimicGen project page。
这张动态图体现了它和普通“机械臂数据增强”的区别:
- 机器人不是固定在桌前,而是需要先移动身体位置,再进入可操作区域。
- 操作不是只靠手臂,还要考虑躯干姿态、足底支撑、机器人根节点位置和长时域任务阶段。
- 同一个源示教会被迁移到新的物体位姿、机器人初始位姿和障碍布局,生成新的可执行轨迹。
3. 为什么人形 loco-manipulation 的数据生成更难
传统 MimicGen 解决的是固定基座或稳定机械臂场景里的示教扩增。比如一个机械臂从桌上抓杯子,源示教里末端相对杯子的轨迹可以迁移到新杯子位置:把“手相对物体”的 SE(3) 轨迹变换一下,再让机械臂控制器跟踪即可。
人形机器人不一样。它的任务通常同时包含 locomotion 和 manipulation:
text走到物体附近 -> 调整脚步和身体姿态 -> 伸手抓取 -> 搬运或推动 -> 再移动到目标区域 -> 放置或完成交互
这里至少有四类耦合:
| 难点 | 具体含义 | 如果直接套机械臂 MimicGen 会怎样 |
|---|---|---|
| 腿和手耦合 | 手是否够得到物体,取决于脚站在哪里、躯干怎么转、机器人是否保持平衡 | 手臂轨迹看似正确,但身体站位错误,末端根本不可达 |
| 动态稳定 | 行走阶段和静态操作阶段的控制规律不同 | 机械臂轨迹插值无法保证双足机器人稳定走过去 |
| 长时域阶段 | 推柜、搬箱、绕障碍取钻头都不是一个短抓取动作 | 单段轨迹迁移容易在中间阶段失败 |
| 接触丰富 | 双手抱箱、推架子、从 holder 中取出钻头都涉及持续接触 | 只迁移末端位姿,可能碰撞、穿模或丢失接触关系 |
所以这篇论文真正要解决的是:如何把一条人形示教拆成可迁移的局部技能,同时用全身规划保证每个技能在新场景里仍然可达、稳定、无碰撞。
4. 总览图:从一条示教到千级数据扩增
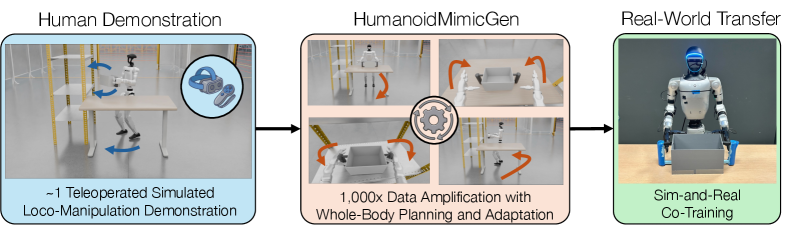
图 2 HumanoidMimicGen 总览。 左侧是人类遥操作采集少量源示教;中间是通过 whole-body planning and adaptation 做 1000x 级别的数据扩增;右侧是用这些仿真数据训练策略,并进一步做 sim-and-real co-training。
来源:HumanoidMimicGen arXiv HTML。
这张图可以拆成三段:
- Human Demonstration:人通过 VR controller 做一次完整任务示教。论文实验中,每个仿真任务只采集一条 source demonstration;真实机器人实验中也强调少量真实数据。
- Data Amplification:系统不是随机扰动整条轨迹,而是先理解每个技能片段的目标和约束,再对新场景重新规划可执行路径。
- Policy Learning:生成的轨迹不是最终控制器,而是 imitation learning 的训练数据。论文在仿真中用 GR00T N1.6 VLA 做后训练,在真实 G1 上用生成数据和真实数据混合训练策略。
这个流程对开源教程很重要:它不是“按键盘在世界模型里玩”的那类可交互仿真器,也不是“预测下一帧视频”的世界模型。它更像一个合成数据引擎,目标是生成可以训练策略的 state-observation-action demonstration。
5. 方法图:技能标注、约束、全身规划、技能适配
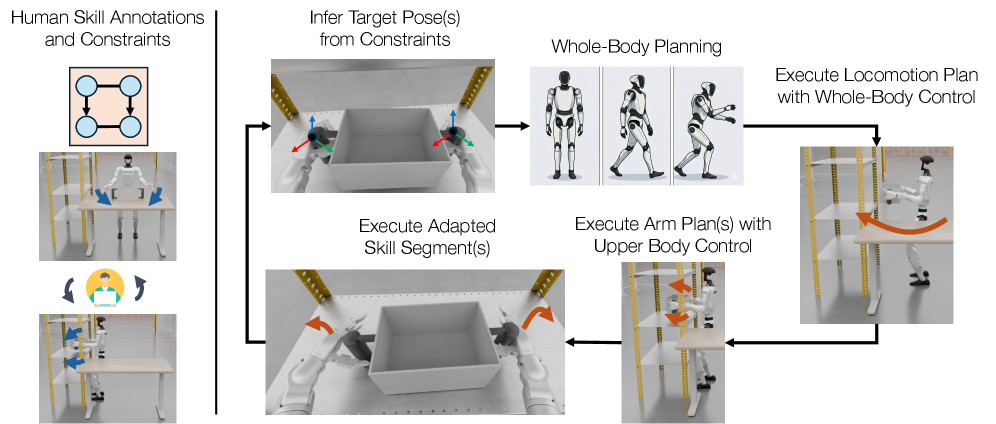
图 3 HumanoidMimicGen 方法图。 左边是一条带技能标注和约束的源示教;右边是系统根据约束推断目标末端位姿,然后依次执行全身规划、腿部移动、手臂规划和技能片段适配。
来源:HumanoidMimicGen arXiv HTML。
这张架构图建议按“输入、规划、执行、输出”四层理解。
5.1 输入:source demonstration + per-arm skill annotations
源示教不是一串无结构轨迹,而是带技能切分的轨迹。一个任务会被切成多个 object-centric skill,例如:
| 任务 | 可能的技能片段 |
|---|---|
| Box Table To Shelf | 左手接近箱子、右手接近箱子、双手抬起箱子、走到架子前、双手放置箱子 |
| Drill PnP | 走到第一张桌子、抓取钻头、拿起钻头、走到第二张桌子、放置钻头 |
| Push Shelf Forward | 走到货架前、双手接触货架、持续推动、停止到目标区域 |
每个技能片段通常绑定某个末端执行器和参考物体坐标系。比如“右手抓钻头”并不是只记录右手在世界坐标的位置,而是记录右手相对钻头坐标系的轨迹。这样当钻头换位置后,轨迹可以按物体坐标变换迁移。
5.2 约束:precedence 和 coordination
人形双臂任务经常不是严格单线程。论文用两类约束表达技能关系:
- precedence constraint:哪个技能必须先于哪个技能。例如先抓起箱子,再把箱子放入货架。
- coordination constraint:哪些技能需要同步执行。例如双手同时抬箱子,或双手同时推货架。
这些约束会被编译成一个技能执行顺序图。简单任务可以是线性的,双手任务则可能有并行技能组。系统每次选择当前可执行的一组技能,然后为这些技能求目标位姿和全身配置。
5.3 目标推断:从约束推到 end-effector target poses
在新场景里,物体位置发生变化,机器人初始位置也可能变化。HumanoidMimicGen 需要根据源示教中的相对关系推断新的末端目标:
text源示教中:末端相对物体的目标位姿
新场景中:物体的新世界位姿
推断出:末端在新世界中的目标位姿
这一步保留的是任务语义中的相对关系。例如“手要从钻头把手侧面接近”比“手要到世界坐标某个固定点”更可迁移。
5.4 全身 IK:先问机器人能不能达到
推断出末端目标后,系统要找一个人形机器人全身配置,让活跃的末端执行器达到目标,同时尽量保持身体合理。论文中使用 whole-body inverse kinematics,并在附录里说明使用 cuRobo 做 GPU 加速的批量 IK 和碰撞检测。
这里和机械臂 IK 的区别是:人形机器人可以动的自由度很多。手够不到时,不一定只是动肩肘腕,还可以转躯干、调整腿部站位,甚至换一个机器人 root pose。因此 IK 不是单纯求手臂关节,而是在全身配置空间中寻找一个可达、稳定、尽量少动不必要关节的解。
5.5 分解规划:动态走路和静态操作分开
论文采用 decoupled planning 的工程思路,把阶段拆成:
text当前配置
  -> locomotion plan:腿部和底盘位置移动到 switch configuration
  -> manipulation plan:站稳后用上半身接近目标配置
  -> adapted skill segment:重放并适配源示教里的接触技能
这样做的原因很现实:双足机器人走路阶段是动态稳定问题,手臂精细操作阶段更接近静态稳定问题。强行在一个控制器里同时规划所有自由度,难度和失败率都会很高。HumanoidMimicGen 把它拆开,腿部移动时用学习得到的 locomotion policy 执行 pelvis velocity commands,操作阶段用 upper-body joint-space control。
5.6 技能适配:不是只到达目标,还要重放接触片段
到达目标附近后,系统还要执行源示教中的局部技能,例如抓、抬、推、放。技能适配会根据新场景中的物体位姿重新计算末端轨迹,并用全身 IK 跟踪这些 adapted end-effector target poses。手指关节等细节在论文描述中会按源示教重放。
这一步是 MimicGen 谱系的核心:不要重新学习所有动作,而是复用源示教中“相对物体”的局部接触经验。HumanoidMimicGen 的改进是,在人形机器人上给这些技能前后加上全身可达性、步态移动和碰撞约束。
6. 方法视频:规划和技能适配如何交替执行
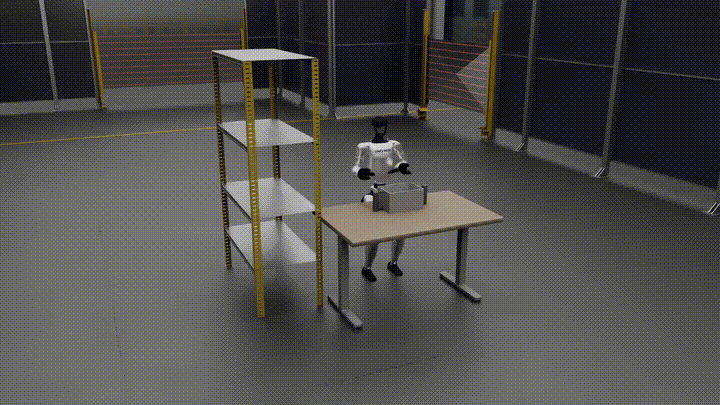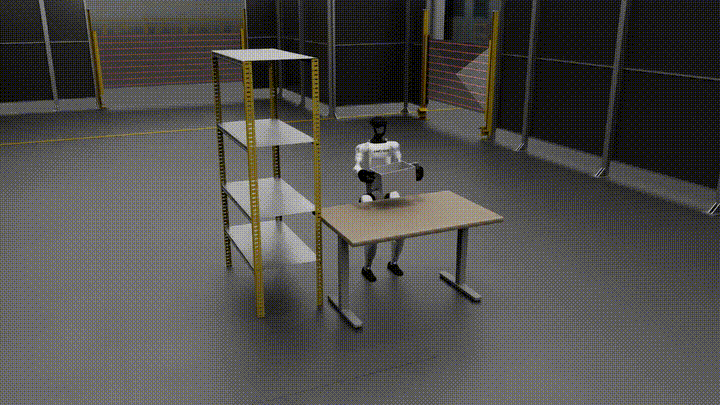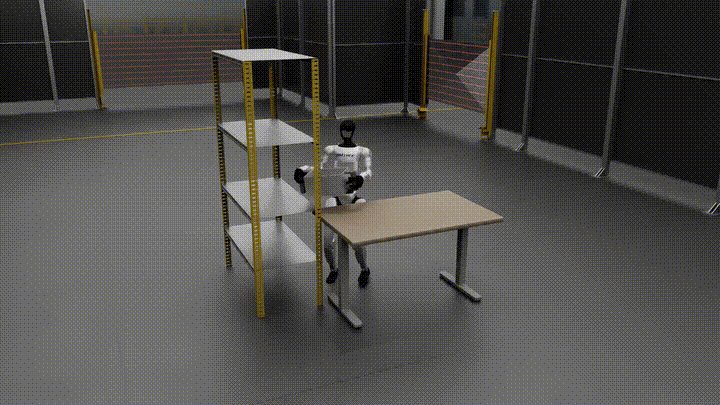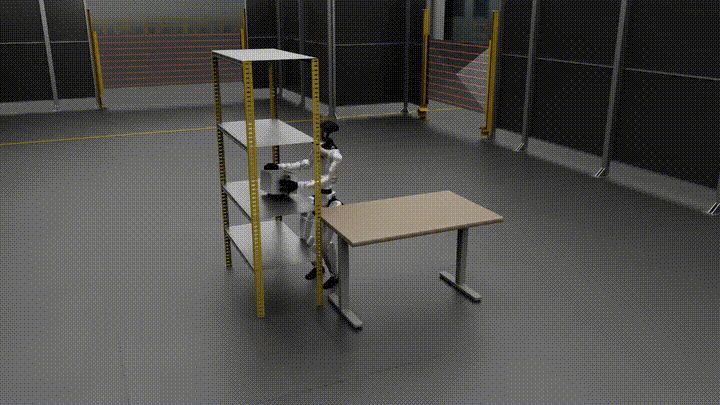
图 4 官方 method 视频转 GIF。 这段视频展示了系统如何交替进行 locomotion planning、manipulation planning 和 skill adaptation。
来源:HumanoidMimicGen project page。
读这段视频时,不要只看机器人“动作很顺”。更关键的是看它每个阶段在解决什么问题:
- Locomotion Planning 解决“人形机器人应该站到哪里,如何走过去”。
- Manipulation Planning 解决“站稳之后,上半身和手臂如何到达技能开始位姿”。
- Skill Adaptation 解决“源示教里的局部接触动作如何迁移到当前物体位姿”。
这三者交替执行,才让一条源示教能够在新布局中变成成功 rollout。
7. 运动随机化:为什么不是生成一堆完美轨迹就够了
论文中特别强调 motion noise 和 initialization randomization。原因是 imitation policy 不能只学“理想状态下的专家轨迹”。真实或仿真闭环执行时,机器人会偏离专家轨迹;如果训练数据没有覆盖这些 off-nominal states,策略一旦走偏就会越错越远。
HumanoidMimicGen 的做法可以理解成:
text执行时:给动作加入噪声,让机器人经历轻微偏差
存标签时:仍然保存原本专家动作作为监督信号
训练时:策略看到偏差状态,也学习如何回到专家轨迹
这和 DAgger 的思想有一点相似:训练数据要覆盖策略可能到达的状态,而不只是专家理想轨迹上的状态。论文实验也显示,去掉 motion noise 后平均成功率从 0.89 降到 0.49;固定初始位姿、不做 initialization randomization 后,平均成功率从 0.89 降到 0.51。
8. G1 Loco-Manipulation Benchmark
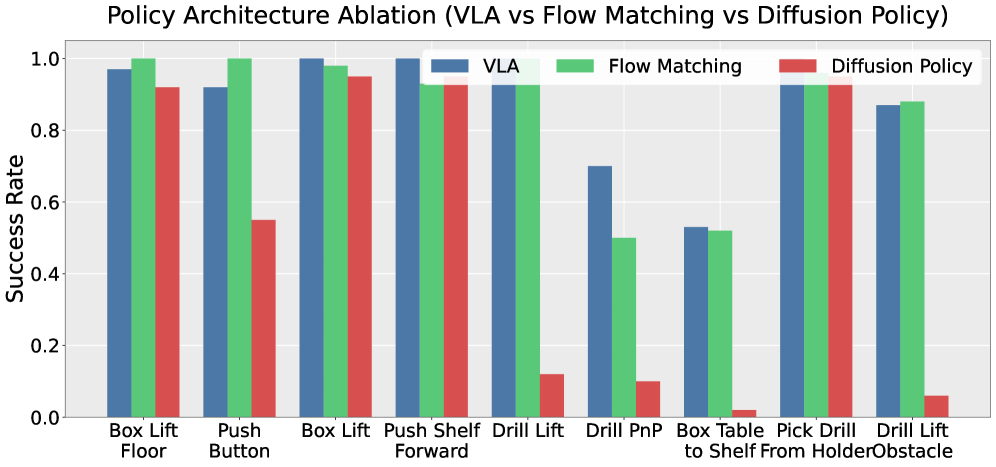
图 5 G1 Loco-Manipulation Benchmark。 论文提出 9 个仿真人形 loco-manipulation 任务,每个任务展示一个随机初始场景和一个完成状态。
来源:HumanoidMimicGen arXiv HTML。
这 9 个任务覆盖了从短程接近到长时域移动、从单臂操作到双臂协同、从桌面物体到货架/障碍布局的变化:
| 任务 | 要求 |
|---|---|
| Box Lift Floor | 从地面抓起箱子并举到目标高度 |
| Push Button | 走到工业面板前按按钮 |
| Box Lift | 走到桌前抓箱子并举起 |
| Push Shelf Forward | 推动货架车到目标区域 |
| Drill Lift | 走到桌前抓起钻头 |
| Drill PnP | 从一张桌子拿钻头,放到另一张桌子 |
| Box Table To Shelf | 把桌上的箱子转移到货架 |
| Pick Drill From Holder | 从 holder 中取出钻头并举起 |
| Drill Lift Obstacle | 绕过阻挡货架后抓起钻头 |
这个 benchmark 的价值不只是“任务数量有 9 个”,而是任务设计确实卡在人形机器人最难的接口处:脚步站位稍微错一点,手就够不到;身体姿态稍微不稳定,双手接触就会失败;长时域任务中早期导航误差会影响后续操作可达性。
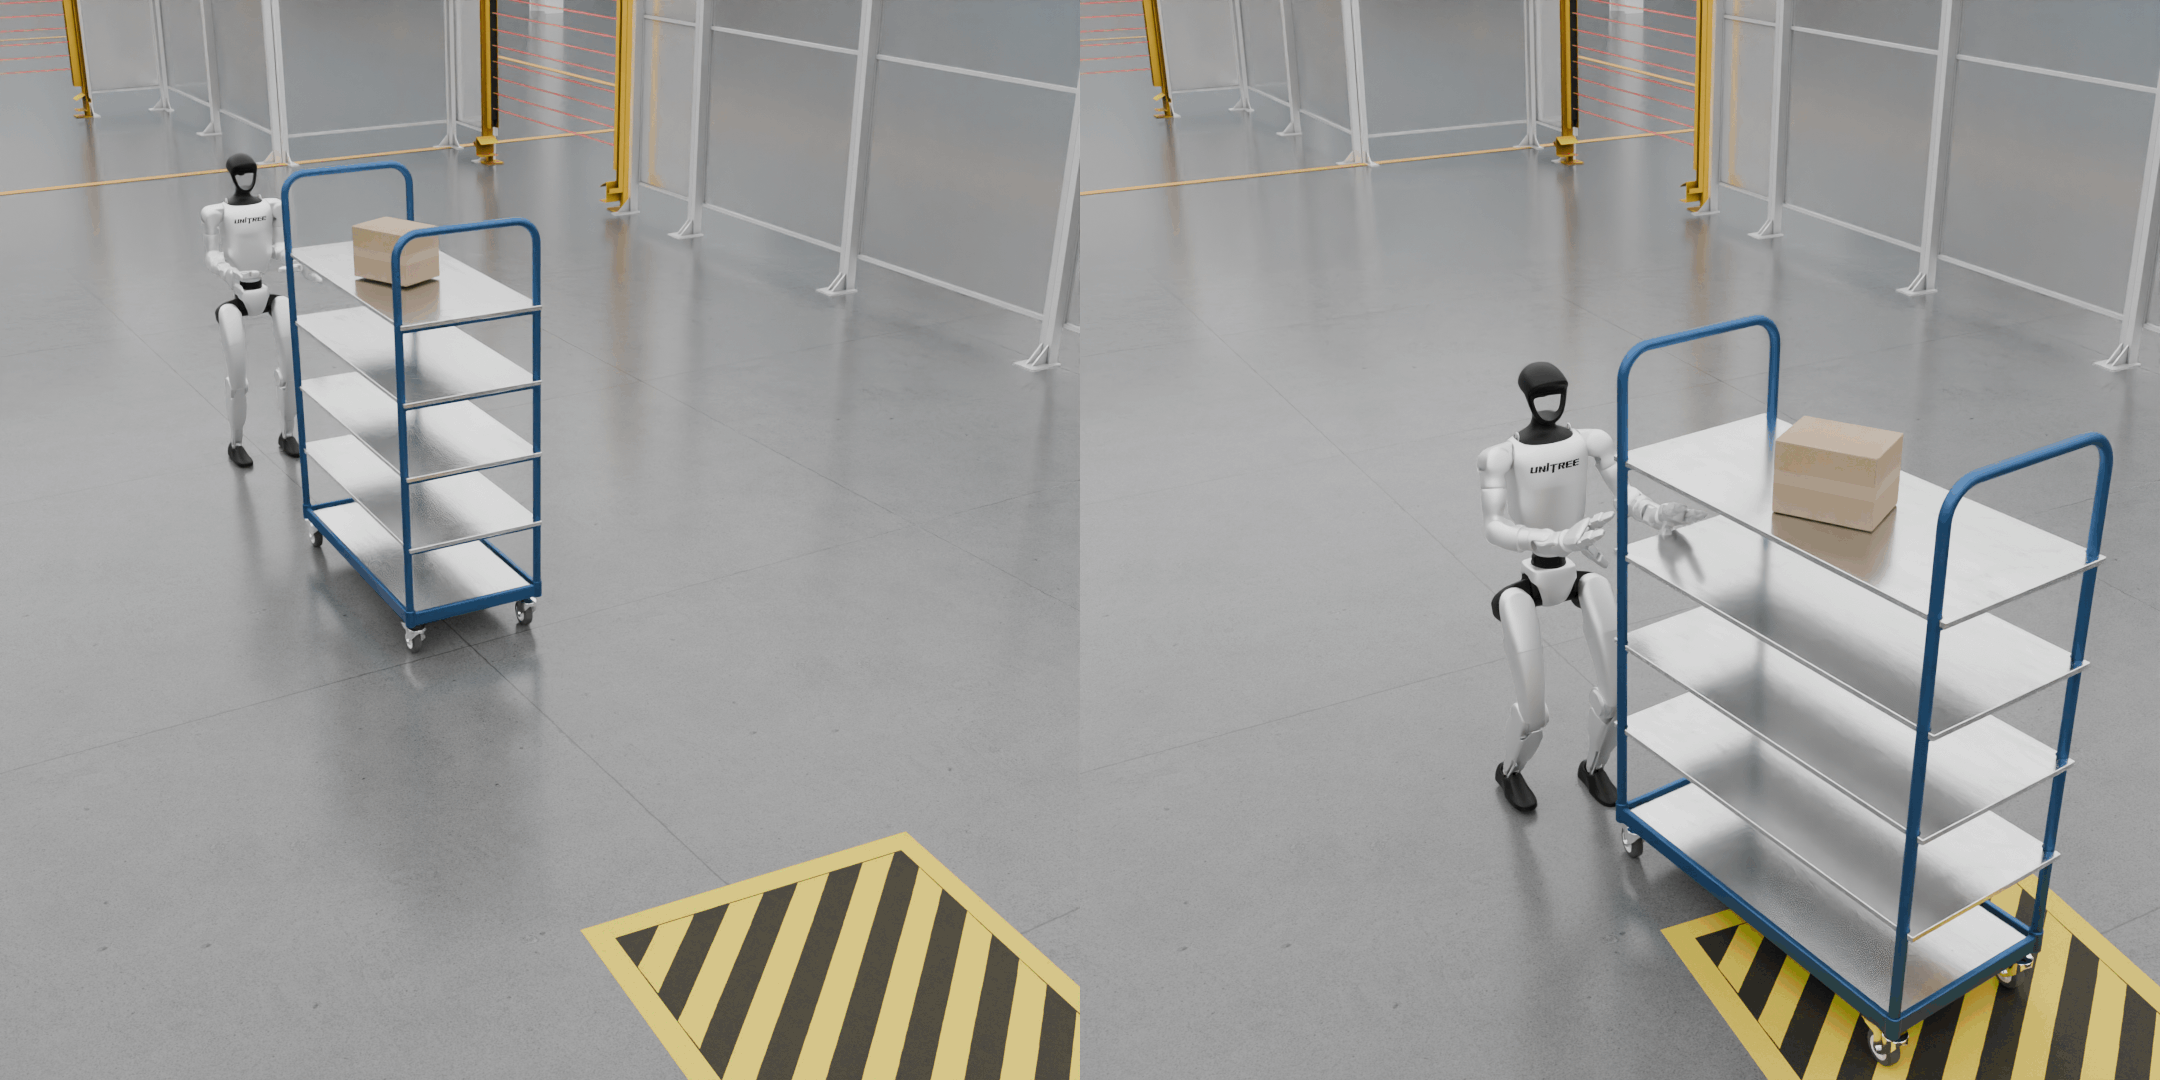
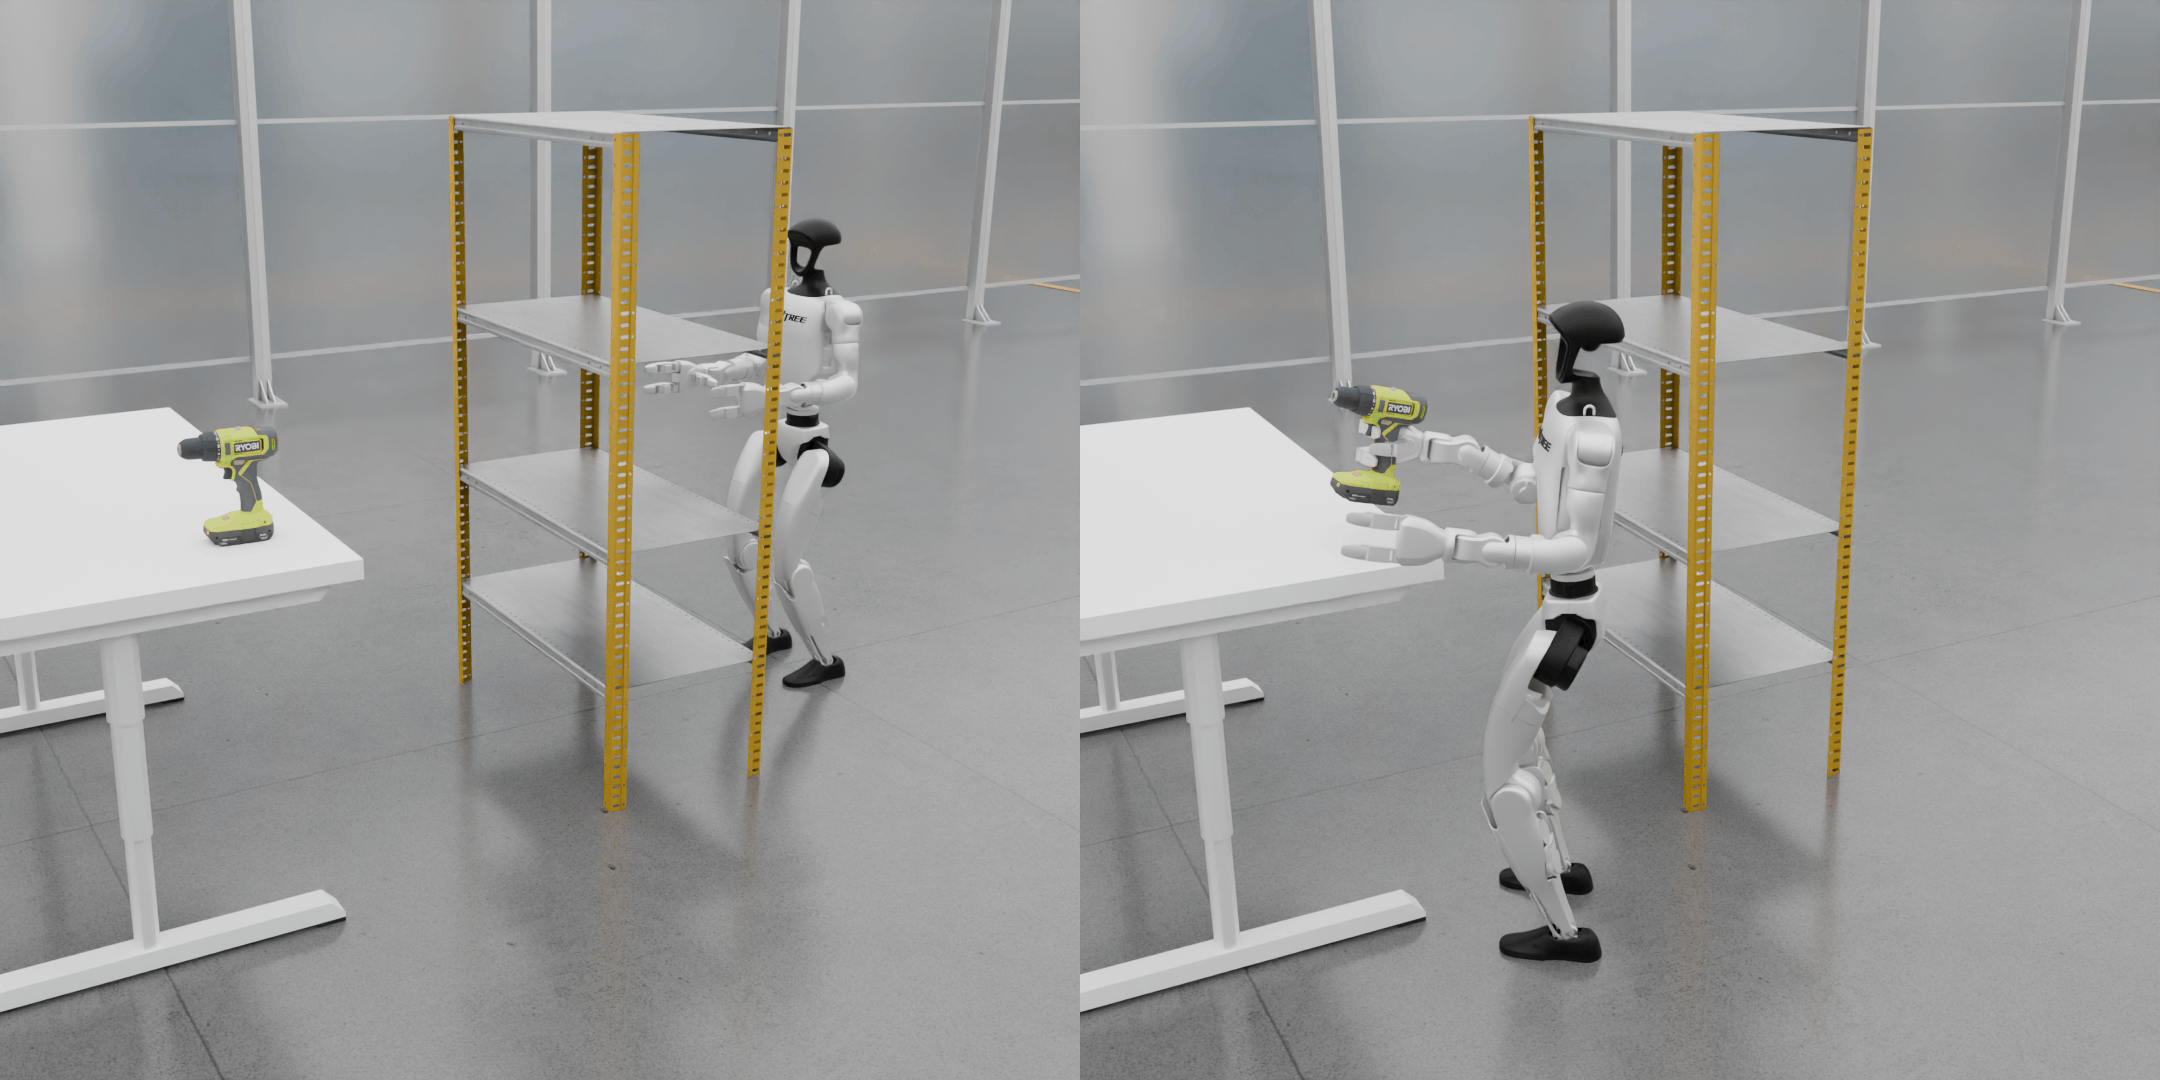
图 6 项目页中的 Push Shelf Forward 与 Obstacle-Aware Pick Drill 任务截图。 左图强调双手持续接触和长时域推货架,右图强调绕障碍导航、站位和单臂抓取的组合。
来源:HumanoidMimicGen project page。
9. 实验结果怎么读
论文在仿真 benchmark 上比较了 4 类数据来源:
| 数据来源 | 平均成功率 |
|---|---|
| 1 Human Demo | 0.26 |
| 100 Human Demos | 0.48 |
| DexMimicGen+ | 0.33 |
| HumanoidMimicGen | 0.89 |
这个结果的重点不是“它比 100 条人类示教更强”这么简单,而是说明:对于人形 loco-manipulation,示教数量不是唯一瓶颈,数据是否覆盖合理站位、物体扰动、技能可达性和长时域阶段同样关键。100 条人类示教如果场景覆盖不够,策略仍然容易学到狭窄分布;HumanoidMimicGen 通过规划和随机化生成的 1000 条轨迹,能覆盖更多可执行状态。
论文还给了几个很有代表性的长时域例子:
- PushShelfForward 长达约 1230 steps,HumanoidMimicGen 达到 1.00 PSR,DexMimicGen+ 为 0.35,单条源示教为 0.70。
- BoxLiftFloor 约 900 steps,HumanoidMimicGen 达到 0.97 PSR,DexMimicGen+ 为 0.87,单条源示教为 0.14。
这说明它对“长时域 + 全身移动 + 接触操作”的组合任务特别有效。
10. 策略模型:为什么论文里也提到 VLA
HumanoidMimicGen 生成的是示教数据,最终还要训练 policy。论文在仿真 policy architecture ablation 中使用 GR00T N1.6 base model 做 VLA 后训练,并和 Flow Matching、Diffusion Policy 对比:
| 策略架构 | 平均成功率 |
|---|---|
| VLA | 0.89 |
| Flow Matching | 0.86 |
| Diffusion Policy | 0.51 |
这里要注意两点:
- HumanoidMimicGen 自身不是 VLA,而是 VLA 的数据来源。
- 论文结果说明,在这个 benchmark 上,用 HumanoidMimicGen 生成的数据微调 VLA 是有效的;但数据生成器的价值并不绑定某一个策略架构,Flow Matching 也接近 VLA 表现。
对教程读者来说,这里可以和 GR00T、OpenVLA、pi0、SmolVLA 等章节联系起来:VLA 的能力上限不只取决于模型结构,也强依赖能否获得覆盖足够丰富的机器人数据。HumanoidMimicGen 正是从数据侧补这个短板。
11. 真实机器人结果:sim-and-real co-training
论文还在真实 G1 上做了四个任务:
| 任务 | Real Only | Co-training |
|---|---|---|
| ThrowBottle | 0.60 | 0.75 |
| BoxToCart | 0.35 | 0.60 |
| PickCanister | 0.50 | 0.75 |
| PickCanisterWithObstruction | 0.60 | 0.75 |
| 平均 | 0.51 | 0.71 |
这里的结论很明确:把 HumanoidMimicGen 生成的仿真数据和少量真实机器人数据一起训练,比只用真实数据更好,平均提升 20 个百分点。这个结果很有吸引力,因为它对应的是当前人形机器人落地最缺的东西:真实全身操作数据很贵,但仿真中可以用规划器生成更多覆盖。
不过也要看清边界:真实实验任务数量不大,仍然依赖手工构建的仿真环境、初始状态分布和成功条件。它证明“这种数据补充路线有效”,但还不能说明只靠仿真自动生成就能解决开放世界人形机器人操作。
12. 和 MimicGen / DexMimicGen+ / RoboDream 的区别
| 方法 | 主要对象 | 生成什么 | 关键假设 | HumanoidMimicGen 的不同 |
|---|---|---|---|---|
| MimicGen | 固定或相对稳定机械臂 | 大量机械臂示教 | 末端控制相对独立稳定 | 人形机器人需要腿、躯干、手臂整体协调 |
| DexMimicGen | 双手/灵巧操作 | 双臂或灵巧手示教 | 重点在手部和上肢接触 | HumanoidMimicGen 显式处理 locomotion、站位和全身可达性 |
| DexMimicGen+ baseline | 把 DexMimicGen 扩到人形 | 简化的人形扩增轨迹 | 直线路径和弱规划 | 缺少完整 skill reasoning、motion planning 和 collision checking |
| RoboDream | 机器人视频数据合成 | 合成示教视频/轨迹数据 | 借助 robot-only trajectory、scene prior 和 object prior | 偏生成式数据合成;HumanoidMimicGen 更偏规划和控制驱动的数据生成 |
| HumanoidMimicGen | 双足人形 loco-manipulation | state-observation-action 示教轨迹 | 有少量技能标注、任务环境和成功条件 | 把示教技能、全身 IK、运动规划、腿部控制、随机化串成数据生成系统 |
如果要放入课程体系,可以这样理解:
- MimicGen 是“少量示教扩增”的经典起点。
- RoboDream 是“用生成式世界模型/先验合成机器人数据”的代表。
- HumanoidMimicGen 是“用规划和控制把人形机器人全身示教扩增出来”的代表。
13. 复现路线建议
当前不建议把它写成手把手复现实验,因为官方 HumanoidMimicGen 代码和 benchmark 环境入口尚未在项目页公开。更合适的学习路线是先拆依赖,再等官方代码:
- 读项目页和论文图:先把 Figure 1、Figure 2、Figure 3 读懂,明确它的输入、输出和中间模块。
- 学习原始 MimicGen:阅读 NVlabs/mimicgen,理解 object-centric skill、少量示教扩增、robosuite 数据生成流程。
- 理解 robosuite / MuJoCo:这篇的 G1 benchmark 建在 MuJoCo 和 robosuite 体系上,后续官方代码大概率也会围绕这些接口组织。
- 补 cuRobo / IK / collision checking:附录提到使用 cuRobo 做 GPU 加速 whole-body IK 和 motion planning,这会是复现难点。
- 跟踪官方代码入口:等项目页补充 GitHub/Code 后,优先跑单任务、单条示教扩增、少量 rollout 可视化,再考虑训练 GR00T 或其他策略。
- 不急着复刻全量指标:论文仿真训练使用 1000 demonstrations per task,VLA 后训练 25K steps,并在 8 张 H100 上训练评估。对普通学习者,更现实的是先复现数据生成可视化和一个小任务。
如果读者只是想做课程作业,可以不跑训练,提交一份方法复盘即可。重点回答这些问题:
- 源示教里哪些信息需要人工标注?
- 技能片段如何从源物体位姿迁移到新物体位姿?
- 为什么腿部 locomotion 要和上半身 manipulation 分开处理?
- motion noise 和 initialization randomization 分别解决什么泛化问题?
- 这个方法生成的数据最终如何服务 VLA 或 flow matching policy?
14. 局限和继续研究方向
论文自己也承认了几个边界:
- 需要人工标注 skill segment,以及技能之间的 precedence / coordination constraints。
- 仿真环境、初始状态分布和成功条件仍然是手工设计的。
- 当前假设任务由固定技能集合和固定技能顺序结构组成,对需要新技能序列或高层规划的开放任务泛化有限。
- 主要依赖刚体物体坐标变换,不擅长处理类内几何差异很大的物体或含糊接触 affordance。
这些局限反而给后续研究留下了很清楚的方向:
- 用 VLM/LLM 自动做技能切分和约束标注。
- 结合 3D scene reconstruction 自动构建可规划仿真环境。
- 把 HumanoidMimicGen 生成的数据接入 GR00T / OpenHLM / WholeBodyVLA 等更完整的人形 VLA。
- 研究 sim2real 中哪些数据随机化最有效,哪些只是在仿真里看起来有用。
15. 推荐阅读顺序
如果你是从本仓库一路学过来的,可以按下面顺序建立上下文:
- MuJoCo 复现 ACT、Pi0、SmolVLA:先理解仿真操作任务和策略训练。
- Isaac Sim、Isaac Lab 与 GR00T 部署导览:理解人形策略和 GR00T 工程路线。
- SIM1 柔体仿真与数据生成:理解仿真数据生成和轨迹过滤。
- RoboDream 可组合世界模型数据合成导读:对比生成式数据合成路线。
- 本文:理解人形 loco-manipulation 场景中,为什么需要全身规划来生成可训练数据。