
MicroDuck:在自由滚动篮球上边走边保持平衡
本节把一个很适合作为运动控制强化学习案例的实验整理进 Every Embodied:让 MicroDuck 站在自由滚动的篮球上,在保持身体直立和双脚接触球面的同时,根据速度指令主动滚动前进。
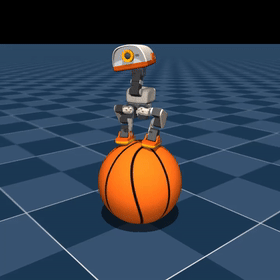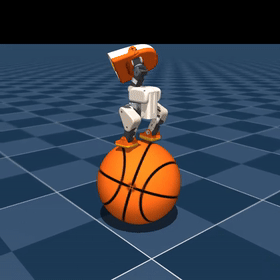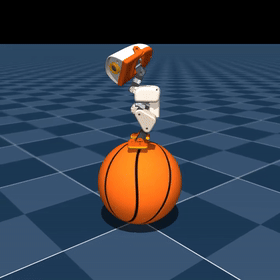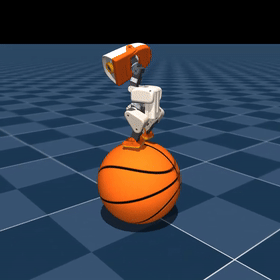
篮球平衡 GPU 策略回放视频(5 秒,无声)。首页播放预览为同一回放的 GIF,保留原始动作时间轴;视频采用 H.264 和 faststart。来源是本专题 01_篮球平衡_PPO_ONNX_BPU_MuJoCo.ipynb 对应的已有 GPU 回放,不是 MotrixLab 多机器人球面平衡片段。
1. 先说结论
这个任务不是把地面 walking 策略的动作输出直接叠加到篮球任务上。直接叠加通常会出现两个问题:
- 地面 walking 策略假设脚下是固定平面,动作节奏会把自由球越推越偏;
- 球的滚动速度、接触位置和身体姿态之间存在隐藏的时序关系,单帧状态很难判断下一步应该如何修正。
公开实现采用更稳妥的方式:沿用 MicroDuck 速度控制任务的 observation/action 约定,使用带记忆的 LSTM actor,通过 PPO 直接学习“脚下是自由球”这一新动力学。actor 不读取球的位置和速度,而是从陀螺仪、重力投影、关节状态、上一时刻动作和历史隐状态中估计球的运动;训练时 privileged critic 可以读取球状态,部署时只保留 actor。
因此,本实验更准确的表述是:
用原有 walking 任务的控制接口和速度指令定义,重新训练一个具备本体感觉记忆的球面行走策略。
它不是“冻结原 walking ONNX,再在动作上加一个小 residual”这么简单,但最终呈现的行为正是想要的:鸭子一边抬脚换重心,一边让球滚动,身体始终尽量停留在球顶附近。
1.1 这次复现,哪些是上游的,哪些是我们做的
先把这次工作的范围说清楚。看到演示视频,很容易以为我们已经训练出了一个新的“鸭子站在篮球上行走”模型。实际上,这一版做的是把公开方案在本地完整跑通,作为后面继续改环境、改奖励和做真机适配的基线。
上游项目已经准备好了最核心的部分:
microduck-playground提供篮球场景、碰撞模型、奖励函数和 PPO 训练脚本,任务 ID 是Mjlab-Basketball-MicroDuck;- 篮球的尺寸、质量、接触参数和重置方式沿用公开配置;
- Hugging Face 模型仓库提供训练好的
checkpoint.pt和policy.onnx; - 官方仓库还提供了训练说明和参考视频。
我们这边做的事情主要是把这条链路落到本地:拉取源码和模型,处理运行环境,跑 checkpoint 推理,渲染出本地视频,做一次继续训练 smoke test,再检查 PyTorch 和 ONNX 的逐步输出是否一致。
所以,回答“是不是直接把别人的模型搬过来用”这个问题:当前版本基本就是在公开场景中复现公开模型。场景不是我们自定义的,模型也不是我们从随机初始化训练出来的。这里的工作重点不是重新发明一个算法,而是确认源码、模型、物理场景和端侧推理接口能够真正接起来,并把过程整理成其他人可以照着跑的教程。
本地测到的 98.83%,指的是公开 checkpoint 在本地 256 个环境、运行 30 秒时的复核结果。它能说明这份公开模型在我们的环境里跑通了,不能说明我们训练出了新的策略,也不能直接拿来和官方完整实验结果比较。
如果要把它进一步做成我们自己的实验,就需要在这个基线之上改动至少一部分内容,例如球的质量或摩擦、机器人初始姿态、速度指令、扰动范围、奖励权重或训练课程。改完以后重新训练,并在没有参与训练的随机种子或新场景上测试,才能把结果称为我们的版本。
2. 公开项目与代码
| 资源 | 地址 | 用途 |
|---|---|---|
| 训练源码 | Vottivott/microduck-playground | MuJoCo-Warp 环境、奖励、训练和评测脚本 |
| 模型与 ONNX | HannesVonEssen/microduck-basketball | checkpoint.pt、policy.onnx、参数、评测记录和视频 |
| 原始机器人项目 | pollen-robotics/microduck | MicroDuck 机器人模型和硬件背景 |
| LSTM 运行时支持 | microduck PR #231 | 端侧 recurrent policy 的运行时适配参考 |
| 官方实验说明 | Basketball README | 方法、指标、训练命令和部署契约 |
| 官方完整视频 | preview.mp4 | 公开的自由球仿真演示 |
当前公开 checkpoint 是 b11,训练迭代约 6,999。项目作者明确说明:仿真和导出检查已经通过,但真机时序与真实机器人行为尚未验证。因此它适合做教程、仿真和端侧推理链路的基线,不应直接当作电机可用策略。
3. 场景与物理模型
3.1 自由球,而不是固定支撑物
仿真中篮球是一个带 free joint 的自由刚体:
- 直径约
0.24 m,半径约0.12 m; - 质量约
0.62 kg; - 球与地面、脚底之间是真实 MuJoCo 接触;
- 球不通过 weld 或固定约束锁在原地;
- 球的平动、转动和接触摩擦都会影响鸭子的下一步动作。
重置时把篮球放在环境原点,鸭子从球顶附近的直立姿态开始。训练初期使用逐渐减弱的 hold curriculum,让策略先在较容易的条件下学会保持平衡,再逐步过渡到完全自由滚动的球。这个 hold 只是训练课程,不是最终演示时给球施加的固定力。
3.2 为什么需要完整碰撞模型
如果机器人使用只有脚底碰撞的简化模型,摔倒时身体可能穿过篮球,或者以不合理的方式“悬浮”。篮球实验使用完整碰撞模型,并以以下条件判定摔倒:
- 鸭子根部相对球心高度过低;
- 鸭子根部偏离球心过远;
- 身体倾角超过阈值。
这三个条件共同约束“站在球上”,避免只用画面效果制造一个看似成功的动作。
4. 网络结构与输入输出
4.1 actor 的 61 维输入
发布的 blind actor 不读取球的状态,输入仍然保持 MicroDuck 常用的 61 维控制接口:
| 索引 | 内容 | 维度 |
|---|---|---|
0:3 |
身体陀螺仪 | 3 |
3:6 |
重力在身体坐标系下的投影 | 3 |
6:20 |
14 个关节位置 | 14 |
20:34 |
14 个关节速度 | 14 |
34:48 |
上一时刻 14 维动作 | 14 |
48:51 |
前向、横向、偏航速度指令 | 3 |
51:55 |
head command 的零填充 | 4 |
55:61 |
body command 的零填充 | 6 |
这里的“blind”不是没有记忆,而是 actor 不直接看球。LSTM 的隐状态把过去若干控制周期的信息压缩起来,用来推断脚底接触和球面滚动趋势。
4.2 LSTM 与动作头
结构可以概括为:
text61D proprioception
        |
   LSTM(256)
        |
   ELU MLP: 512 -> 256 -> 128
        |
    14 joint actions
训练时 critic 额外接收球的位置、线速度、角速度以及接触相关信息,帮助 PPO 获得更稳定的价值估计;部署导出时只保留 actor,因此不需要摄像头或球检测器。
4.3 ONNX 推理契约
ONNX 模型不是普通的单帧 MLP,输入输出包含 recurrent state:
textinputs:
  obs  [1, 61]
  h_in [1, 1, 256]
  c_in [1, 1, 256]

outputs:
  actions [1, 14]
  h_out   [1, 1, 256]
  c_out   [1, 1, 256]
运行频率为 50 Hz。每次推理都要把 h_out/c_out 传给下一次;首次启动、策略切换、摔倒恢复和 episode reset 时将它们清零。普通的速度指令变化不应清空记忆,否则策略会突然失去对球滚动趋势的估计。
5. 奖励如何表达“边走边站球”
核心奖励不是单纯奖励“球不动”。如果把球速度一直当作负项,策略最容易学到的行为是僵硬地站在原地,而不是按指令滚动。因此公开实现使用以下组合:
- 速度跟踪:鼓励球面上的整体运动跟随前向、横向和偏航速度指令;
- 直立奖励:身体重力投影接近直立方向;
- 居中奖励:鸭子根部保持在球心附近;
- 脚与球接触奖励:双脚应处于球面合理接触高度;
- 根部高度奖励:保持站在球顶,而不是逐渐蹲下或陷入球内;
- 球速正则:在较小权重下抑制无指令时的乱滚;
- 动作变化惩罚:降低高频抖动,但不在部署端额外做动作低通滤波。
这里的关键平衡是:球速项只做小权重正则,速度跟踪项负责让“滚动”变成有目标的行为。这样才能得到“脚步换重心,球随身体移动”的物理闭环。
6. 训练与复现
下面是公开项目给出的训练链路。这里只给出复现入口,不要求学习者从头完成完整长训。
6.1 获取源码与模型
bashgit clone https://github.com/Vottivott/microduck-playground
cd microduck-playground
uv sync --locked
下载 Hugging Face 模型仓库中的 checkpoint.pt、policy.onnx、参数和校验文件。若当前模型仓库要求登录,使用自己的 Hugging Face 账号完成认证,不要把 token 写进 Notebook、Shell 历史或 Git 仓库:
pythonfrom huggingface_hub import snapshot_download

snapshot_download(
    "HannesVonEssen/microduck-basketball",
    local_dir="artifacts/basketball",
)
6.2 先跑训练 smoke
训练前先用少量环境和少量迭代验证 MuJoCo-Warp、BAM actuator、checkpoint 恢复和奖励计算:
bashWANDB_MODE=disabled uv run python scripts/finetune_basketball.py \
  artifacts/basketball/checkpoint.pt \
  --run-name basketball-resume-smoke \
  --num-envs 64 \
  --iterations 5 \
  --learning-rate 2e-5 \
  --push-interval-s 1.5 3 \
  --save-interval 5
公开配方的长训入口如下。4096 是并行环境数量,不代表必须一次使用 4096 个环境;显存不足时先降低到 256 或 512,但要在报告中记录环境数量、迭代次数和随机种子:
bashuv run python scripts/finetune_basketball.py \
  artifacts/basketball/checkpoint.pt \
  --run-name basketball-resume \
  --num-envs 4096 \
  --iterations 500 \
  --learning-rate 2e-5 \
  --action-rate-weight -0.2 \
  --command-scale 1 \
  --episode-seconds 10 \
  --seed 42 \
  --push-interval-s 1.5 3 \
  --save-interval 125
6.3 评测和导出
评测不能只看一条好看的视频,建议至少同时保存:
- 生存率和首次摔倒时间;
- 前向/横向/偏航速度跟踪误差;
- action-change RMS;
- 不同 seed 下的视频和 JSON 结果;
- ONNX 与 PyTorch 的逐步 parity 误差。
公开项目提供了标准化导出与 parity 检查脚本:
bashMICRODUCK_BB_BLIND=1 MICRODUCK_BB_HISTORY=1 \
uv run python scripts/export.py \
  Mjlab-Basketball-MicroDuck \
  --checkpoint-file PATH/TO/model_XXXX.pt \
  --onnx-file output.onnx

uv run python scripts/verify_basketball_onnx_parity.py \
  PATH/TO/model_XXXX.pt output.onnx
7. 本次本地复核结果
本次在本机 CUDA + MuJoCo-Warp GPU 环境中复核了公开 checkpoint:
| 项目 | 结果 |
|---|---|
| 单策略回放 | 30 秒、1500 帧、未触发摔倒 |
| 多环境评测 | 256 环境 × 30 秒 |
| 生存率 | 98.83%(公开 checkpoint 的本地复核,不是从零训练) |
| 平均前向速度跟踪误差 | 0.112 m/s |
| 继续训练 smoke | 64 环境、5 次 PPO 更新,通过 |
| ONNX/PyTorch parity | 40 步最大绝对误差 1.43e-6 |
这些结果是本次对公开 checkpoint 的本地复核,不等同于我们重新训练得到的结果,也不等同于官方完整评测。公开实验的更大规模统计和边界条件请以官方实验 README为准。
8. 与原 walking 策略的关系
这项实验适合作为“运动技能迁移”的反例和改进案例:
- 不推荐:把地面 walking ONNX 的 14 维动作逐帧硬加到 ball-balance actor 上;两套策略面对的接触动力学不同,容易出现抬脚时机、球滚动方向和身体姿态互相冲突。
- 推荐:复用 walking 任务的关节顺序、动作缩放、速度指令和 50 Hz 控制接口,把球面平衡作为新的动力学任务,用 LSTM + privileged critic 重新训练。
- 后续研究:可以用地面 walking policy 做行为初始化、teacher regularization 或 curriculum warm start,但最终 actor 必须通过自由球接触数据学会落脚和滚动修正。
9. 真机边界与安全事项
公开项目当前没有证明真机可直接运行。上板前至少要完成:
- 在 Ubuntu 电脑上用 ONNX Runtime 检查 50 Hz 推理预算;
- 正确维护
h/crecurrent state,并验证 reset 行为; - 限制关节角、速度、电流和动作变化率;
- 使用安全绳、软垫和急停,先从固定球/低 hold 难度逐级验证;
- 先验证站球,再验证低速滚动,最后才考虑真机自由球;
- 不把仿真
98.83%生存率写成真实机器人成功率。